AWS 新发布的 S3 Files 适合作为 Kafka 的存储吗?

AWS Lambda 无服务器架构原理与AI数据工程实践 Serverless 是一种以事件驱动、按需执行、免运维为特征的云计算范式,其核心在于将基础设施抽象为‘能力即服务’,开发者只需关注业务逻辑。AWS Lambda 作为典型实现,通过函数即服务(FaaS)模型,自动完成资源调度、弹性扩缩、安全加固与高可用保障,使计算成本精确到毫秒级 GB-seconds。该模式天然适配 AI 推理、实时风控、ETL 流水线等短时、无状态、高并发场景,显著降低 TCO 并加速 MLOps 迭代。本文结合真实日志清洗、Kinesis 流处理与 S3 数据湖构建案例,详解 Lam 阅读详情

cover.webp

Kafka 社区对共享存储的兴趣由来已久:如果所有数据都放在 S3 这样的共享存储上,Broker 就不需要本地磁盘,副本复制可以省掉,跨 AZ 流量费也随之消失。但对象存储的延迟一直让这个想法停留在"理论上很美"的阶段。AWS 最近发布的 S3 Files 改变了这个前提——它给 S3 加上了 NFS 文件系统接口,小文件读取延迟做到了亚毫秒级。于是一个老问题以新的面貌回来了:Kafka 能不能直接跑在 S3 Files 上?

我们在 AutoMQ 从 2023 年起就在解决这个问题——不是把 Kafka 搬到共享文件系统上,而是从存储引擎层重新设计,让 Kafka 真正运行在共享存储架构上。我们是这个领域最早探索用共享文件系统作为存储后端的团队,也是目前唯一做到生产级低延迟的 Diskless Kafka 实现。所以当 S3 Files 出现时,我们自然要评估它的可能性——以及它的边界在哪里。

S3 Files 是什么?

要回答"Kafka 能不能跑在 S3 Files 上",先得理解 S3 Files 到底做了什么。它本质上是 AWS 在 S3 之上加了一层基于 EFS(Elastic File System)的文件系统访问面——你可以通过 NFS 协议把 S3 存储桶挂载到 EC2 实例上,像操作本地文件一样读写,而 S3 始终是数据的 Source of Truth。
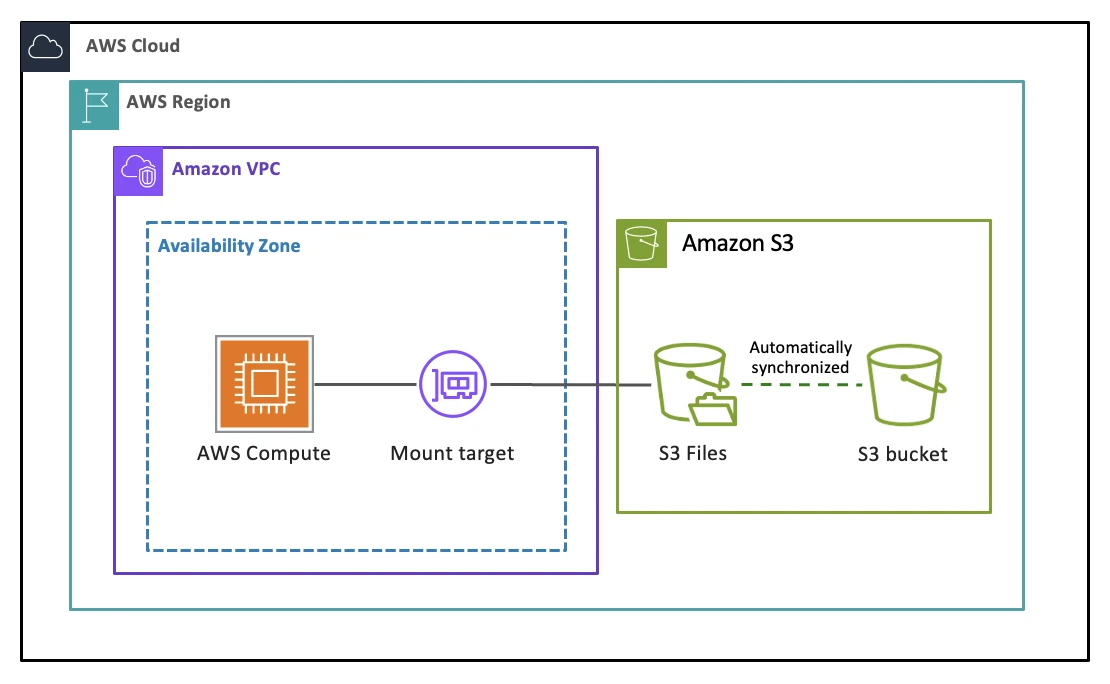
S3 Files 架构

这层访问面的核心设计围绕一个 128 KB 的阈值。小于 128 KB 的文件在首次访问时会被导入 EFS 高性能层,读取延迟可以做到亚毫秒到个位数毫秒;128 KB 及以上的文件则绕过 EFS,通过本地代理直接从 S3 流式读取。写入方向上,所有数据都先落到 EFS 层,再由后台异步批量同步回 S3。换句话说,S3 Files 的优化重点是小文件的低延迟读取,而不是让所有数据都常驻在高性能层。

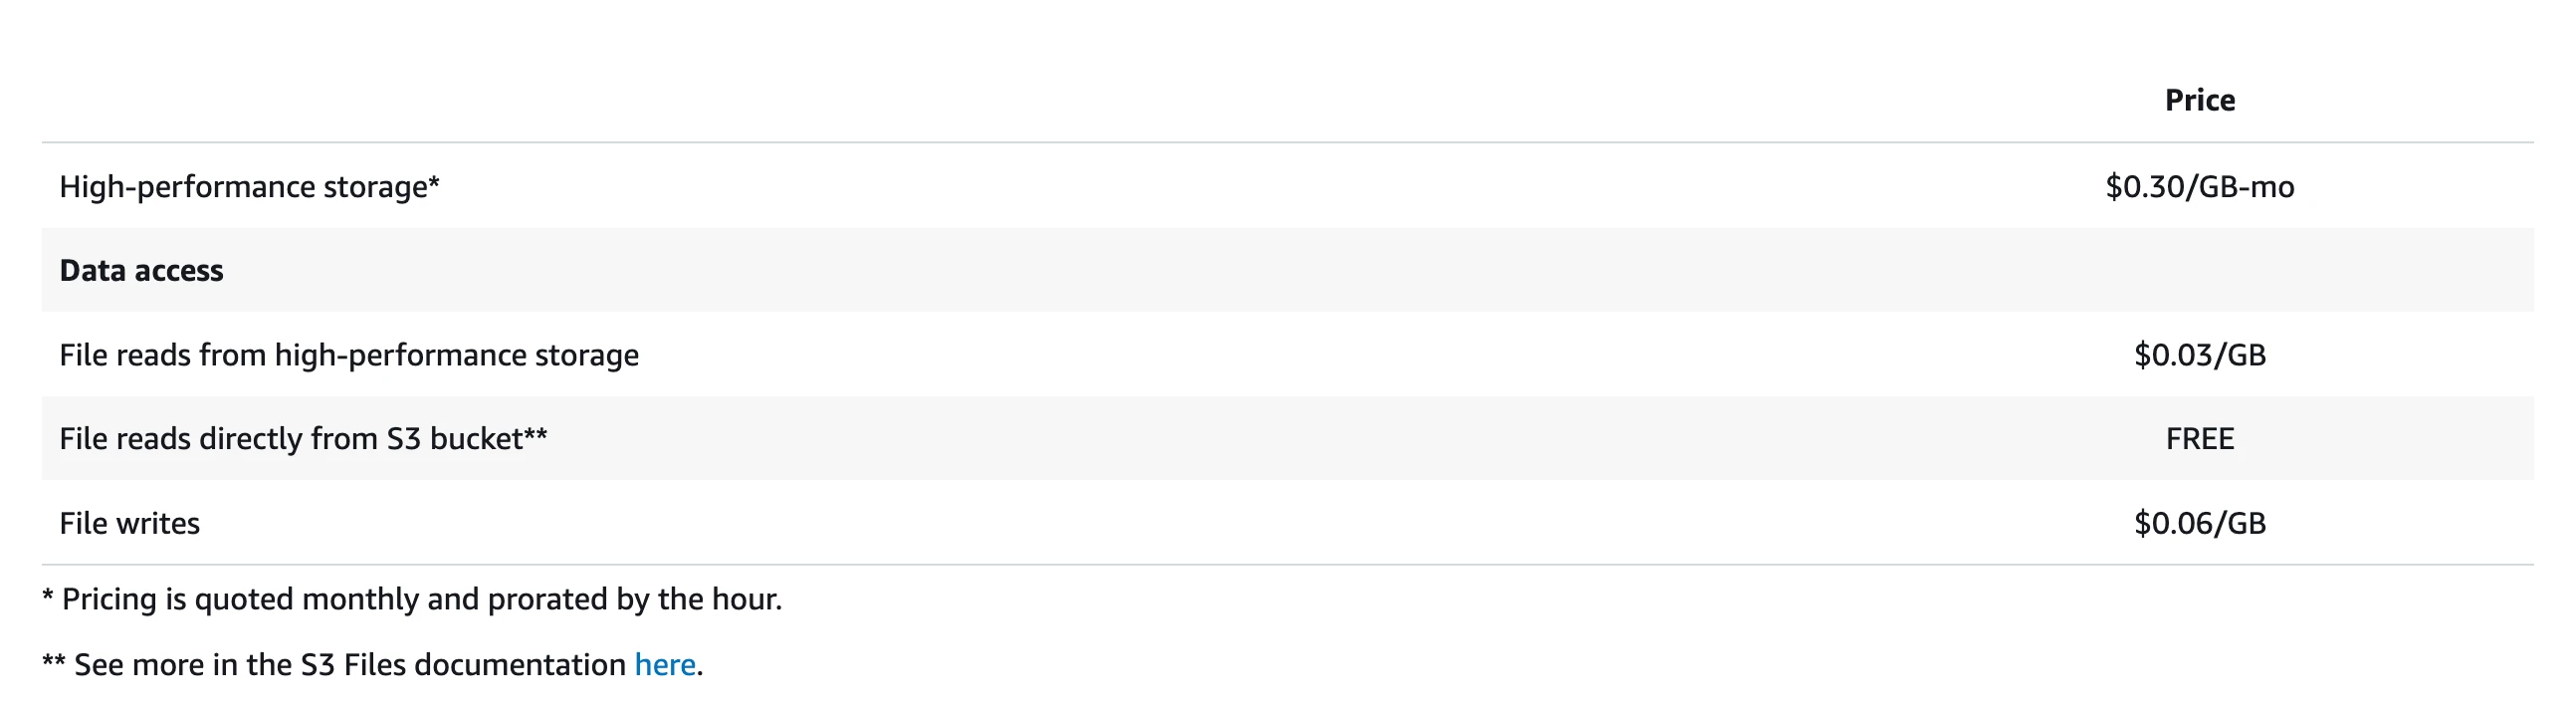
定价模型进一步印证了这个定位。写入按流量计费 $0.06/GB,最小计费 I/O 为 6 KiB,没有预置容量选项。数据同步到 S3 后不会立刻从 EFS 淘汰,默认驻留 30 天,期间你同时支付 EFS 高性能层存储费($0.30/GB-月)和 S3 存储费用。对于读多写少的场景,这个定价是合理的。但对于持续高吞吐写入的工作负载,写入成本和 EFS 驻留费用会快速累积。

共享存储对 Kafka 的吸引力

理解了 S3 Files 的能力边界,再来看为什么大家想把 Kafka 构建在上面。传统 Apache Kafka® 是为专用服务器加本地磁盘设计的,这套架构搬到云上会产生三个不断叠加的成本问题。

最直接的是副本复制带来的跨 AZ 流量费。Kafka 通过 ISR(In-Sync Replicas)机制保证持久性,每条消息会被复制到两到三个 Broker。在多 AZ 部署中,这种复制产生大量跨 AZ 网络流量——AWS 对跨 AZ 数据传输双向收费,合计 $0.02/GB。一个写入吞吐 500 MB/s、副本因子为 3 的集群,两个 Follower 分布在不同 AZ,每秒产生约 1 GB 的跨 AZ 复制流量,仅这一项就超过 $50,000/月。
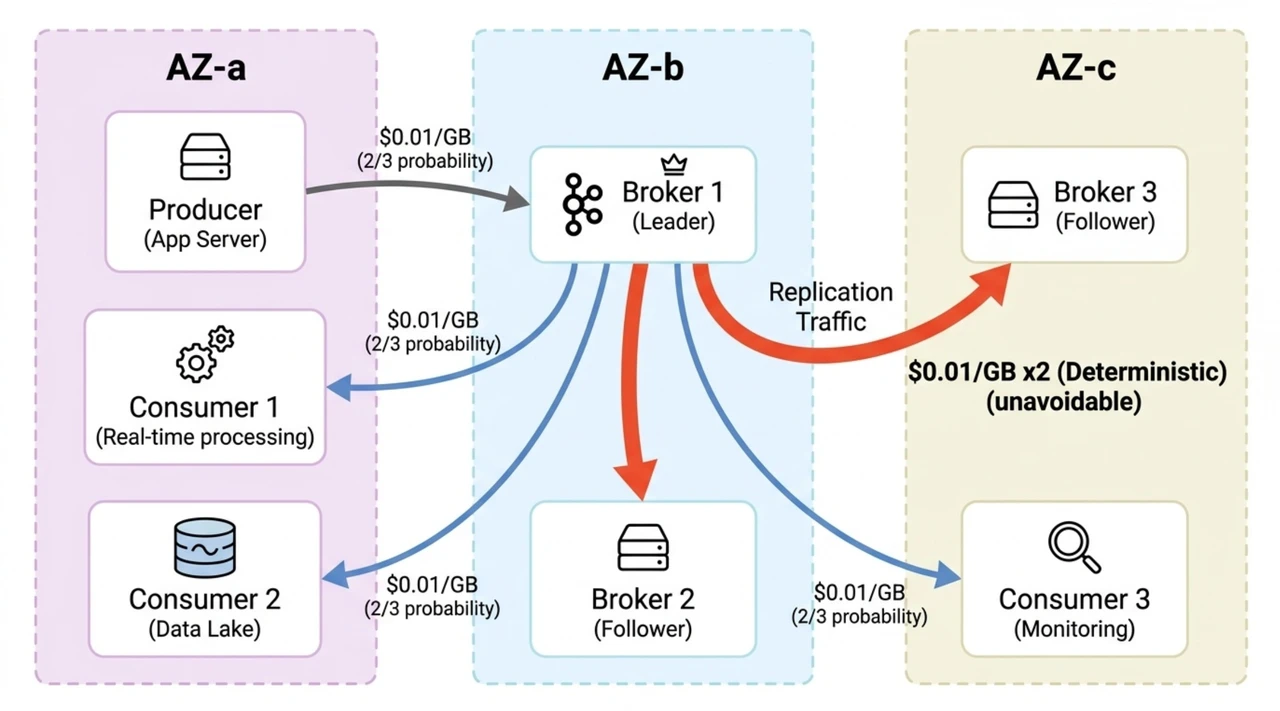
跨 AZ 副本复制

副本复制还带来了第二个问题:存算耦合。每个 Broker 在本地磁盘上管理自己的数据副本,扩展存储就意味着加机器——即使你只需要更多磁盘空间。而且必须按峰值负载加上故障冗余来预留容量,大部分时间都在为闲置资源付费。

存算耦合又进一步放大了运维复杂度。分区重分配需要在 Broker 之间物理搬迁数据,大 Topic 可能耗时数小时。Broker 故障触发漫长的恢复流程。缩容比扩容更难,因为你得先把数据搬走。

如果所有数据都在 S3 这样的共享存储上,这三个问题可以一次性解决:S3 自带 11 个 9 的持久性,不需要副本复制;Broker 变成无状态计算节点,秒级扩缩容;跨 AZ 流量降到接近零。S3 Files 有 NFS 接口、有亚毫秒延迟,看起来正好是连接 Kafka 和共享存储之间的桥梁。但真正尝试搭建这座桥梁时,会遇到几个根本性的问题。

挑战:直接把 Kafka 跑在 S3 Files 上会怎样?
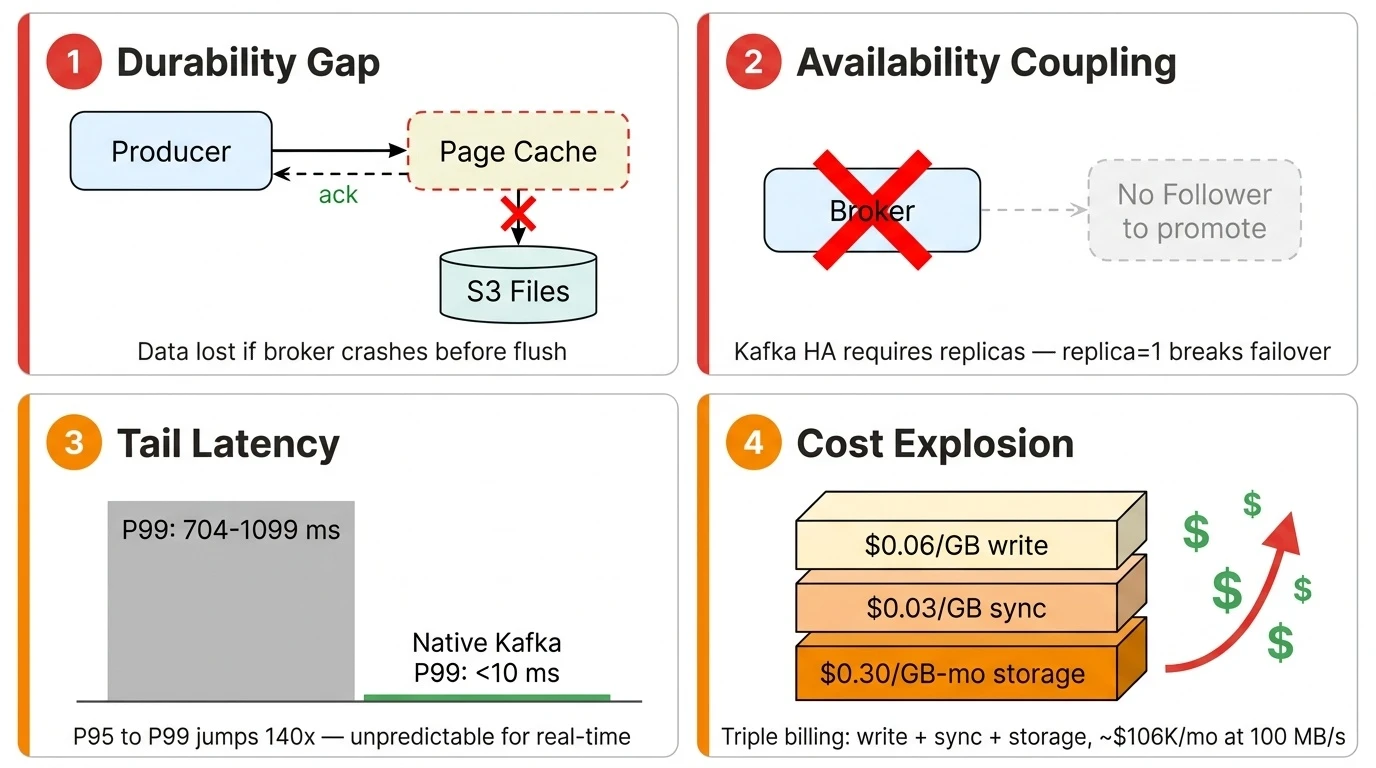
Kafka on S3 Files 的挑战

持久性缺口

最符合直觉的做法是把副本因子设为 1——既然 S3 Files 提供了共享的持久化存储,一份数据就够了。问题出在 Kafka 的写入机制上。

Kafka 是一个异步 I/O 系统。Producer 发送消息并收到 ack 时,数据还在操作系统的 page cache 里,并不一定已经刷到底层存储。这是 Kafka 高吞吐的设计基础——它假设即使 Broker 在刷盘前崩溃,数据仍然安全地存在于 Follower 副本上。但在 replica=1 的 S3 Files 上,这张安全网消失了。Broker 崩溃意味着 page cache 中尚未持久化的数据直接丢失,S3 Files 的 11 个 9 持久性帮不上忙——数据根本还没到达存储层。

要堵住这个缺口,需要改变 Kafka 的写入路径:确保每条被确认的消息在返回 ack 之前就已经持久化。这不是调配置能解决的,这是存储引擎层面的重新设计。

可用性耦合

持久性问题可以通过改造写入路径来解决,但 Kafka 的高可用机制带来了另一个更深层的挑战。

Kafka 的 HA 和多副本设计紧密耦合:Broker 故障时,Controller 将 Follower 副本提升为新 Leader。这个机制的前提是存在 Follower——而 replica=1 意味着没有 Follower 可以提升。你需要一套完全不同的故障转移逻辑:让新 Broker 直接从共享存储读取数据来接管分区,而不依赖本地副本。Kafka 现有的 HA 设计天然阻止了它利用 S3 Files 内置的可用性保障。

这同样需要架构层面的重新设计——不只是写入路径,还有整个故障恢复和分区所有权的管理方式。

延迟现实

即使解决了持久性和可用性问题,延迟仍然是一道坎。S3 Files 宣传的亚毫秒延迟针对的是 EFS 高性能层上的小文件读取,而 Kafka 的核心工作负载是高吞吐的持续顺序写入——这两者的 I/O 模式完全不同。

社区已经有人在 S3 Files 上跑过 Kafka benchmark,数据很说明问题:

指标1 KiB 最大吞吐10 KiB 最大吞吐10 KiB 调优后
平均延迟31.86 ms21.86 ms21.38 ms
P500 ms1 ms1 ms
P9512 ms5 ms13 ms
P991,099 ms704 ms801 ms
P99.93,173 ms2,959 ms2,051 ms
最大值9,904 ms4,152 ms5,139 ms

中位数和 P95 看起来还行——P95 只有 5-13ms,和原生 Kafka 差距不大。但从 P95 到 P99 出现了断崖式跳跃:5ms 直接飙到 704ms,延迟放大了 140 倍。这意味着每一百次请求就有一次要等超过一秒。对于实时流处理场景——风控、实时大屏、事件驱动微服务——这种不可预测的尾延迟是不可接受的。S3 Files 并没有彻底解决共享存储的低延迟问题,相比本地磁盘上的 Kafka 仍然有明显的延迟牺牲。

成本结构
成本结构

延迟之外,S3 Files 的定价模型对 Kafka 也不友好。S3 Files 采用按流量计费——写入 $0.06/GB,小文件读取 $0.03/GB,没有预置容量选项。这和 S3 的按 API 请求次数计费是完全不同的模型。Kafka 的工作负载特征是写入和读取都需要走高性能层:Producer 写入的数据落到 EFS 高性能层,Consumer 做 Tailing Read(消费最新数据)也从高性能层读取。两端都按流量计费,成本随吞吐量线性增长。写入端还有双重流量费——数据先写入 EFS($0.06/GB),再由后台同步回 S3($0.03/GB),Kafka 的所有数据都需要同步回 S3,这笔同步费逃不掉。更隐蔽的是 EFS 高性能层的存储驻留费:$0.30/GB-月,是 S3 Standard 存储费的 13 倍,数据默认驻留 30 天才淘汰。

算一笔具体的账。一个 100 MB/s 持续写入的集群,假设消费端吞吐和写入相当(1x fan-out,即一个 Consumer Group),每天写入和读取各约 8,400 GB(100 MB/s × 86,400 秒):

费用项计算日费用
写入流量费8,400 GB × $0.06/GB$504
写入同步费(导出回 S3)8,400 GB × $0.03/GB$252
Tailing Read 流量费8,400 GB × $0.03/GB$252
日流量费合计$1,008
EFS 存储驻留费(30 天累积)252,000 GB × $0.30/GB-月$75,600/月
月总计(流量 + 存储驻留)$1,008 × 30 + $75,600~$106,000/月

这还是 1x fan-out 的保守估算。如果有多个 Consumer Group(在 Kafka 场景中很常见),Tailing Read 的流量费会成倍增长。2x fan-out 下月成本就超过 $113,000,3x 超过 $120,000。而且这还没算 S3 本身的存储费。S3 Files 的定价模型是为"读多写少、活跃工作集小"的场景设计的——Kafka 恰好相反:持续高吞吐写入,所有数据都是"活跃"的,读取端也是持续高吞吐。

这些挑战加在一起意味着什么?

持久性缺口要求重新设计写入路径。可用性耦合要求重新设计故障转移机制。延迟问题要求在对象存储之前加一层高性能写入缓冲。成本问题要求对小写入进行攒批优化。把这四项加在一起,你实际上需要的是一个全新的 Kafka 存储引擎——而这正是 AutoMQ 从 2023 年就在构建的东西。

AutoMQ:已经被验证的 Shared Storage 架构

AutoMQ 的架构分为两层。S3 是主存储层,所有数据最终都持久化在 S3 上——这是和 Tiered Storage 的根本区别。Tiered Storage 仍然把热数据放在本地磁盘上,S3 只存冷数据;而 AutoMQ 让 S3 成为唯一的 Single Source of Truth,Broker 上没有任何持久化状态(关于两者的详细对比,可以参考这篇文章)。

但直接把每条消息都写到 S3 有两个问题:S3 的写入延迟太高,而且 S3 API 调用是按次计费的——每条消息一次 PUT 请求,API 成本会随消息数线性爆炸。这就是 WAL(Write-Ahead Log)层存在的意义。

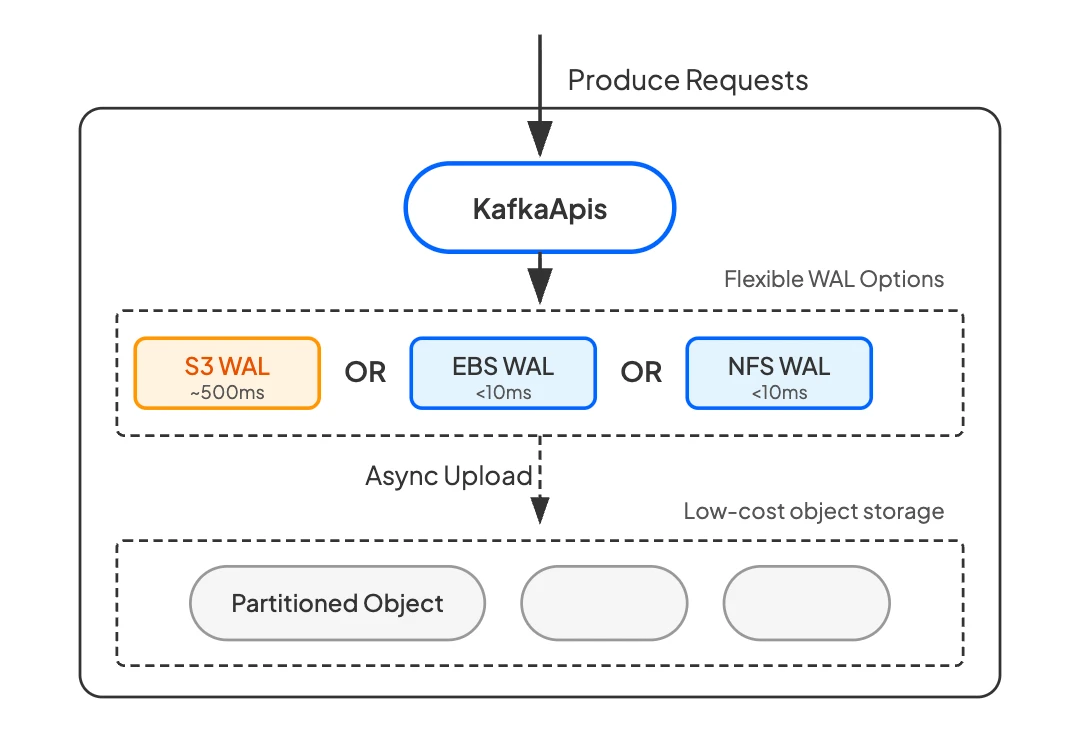
WAL 是一块固定大小的高性能存储空间,充当 S3 前面的写入缓冲。所有 Produce 请求先写入 WAL,使用 Direct IO 绕过 page cache,在返回 ack 之前就保证数据持久化——这直接堵住了上面说的持久性缺口。然后 WAL 中的数据被异步压缩、攒批,再批量上传到 S3。这个攒批过程至关重要:不是每条消息一次 S3 PUT,而是每批数千条消息一次 PUT,S3 API 成本从随消息数增长变成了随吞吐量增长,降低了一到两个数量级。
AutoMQ 架构

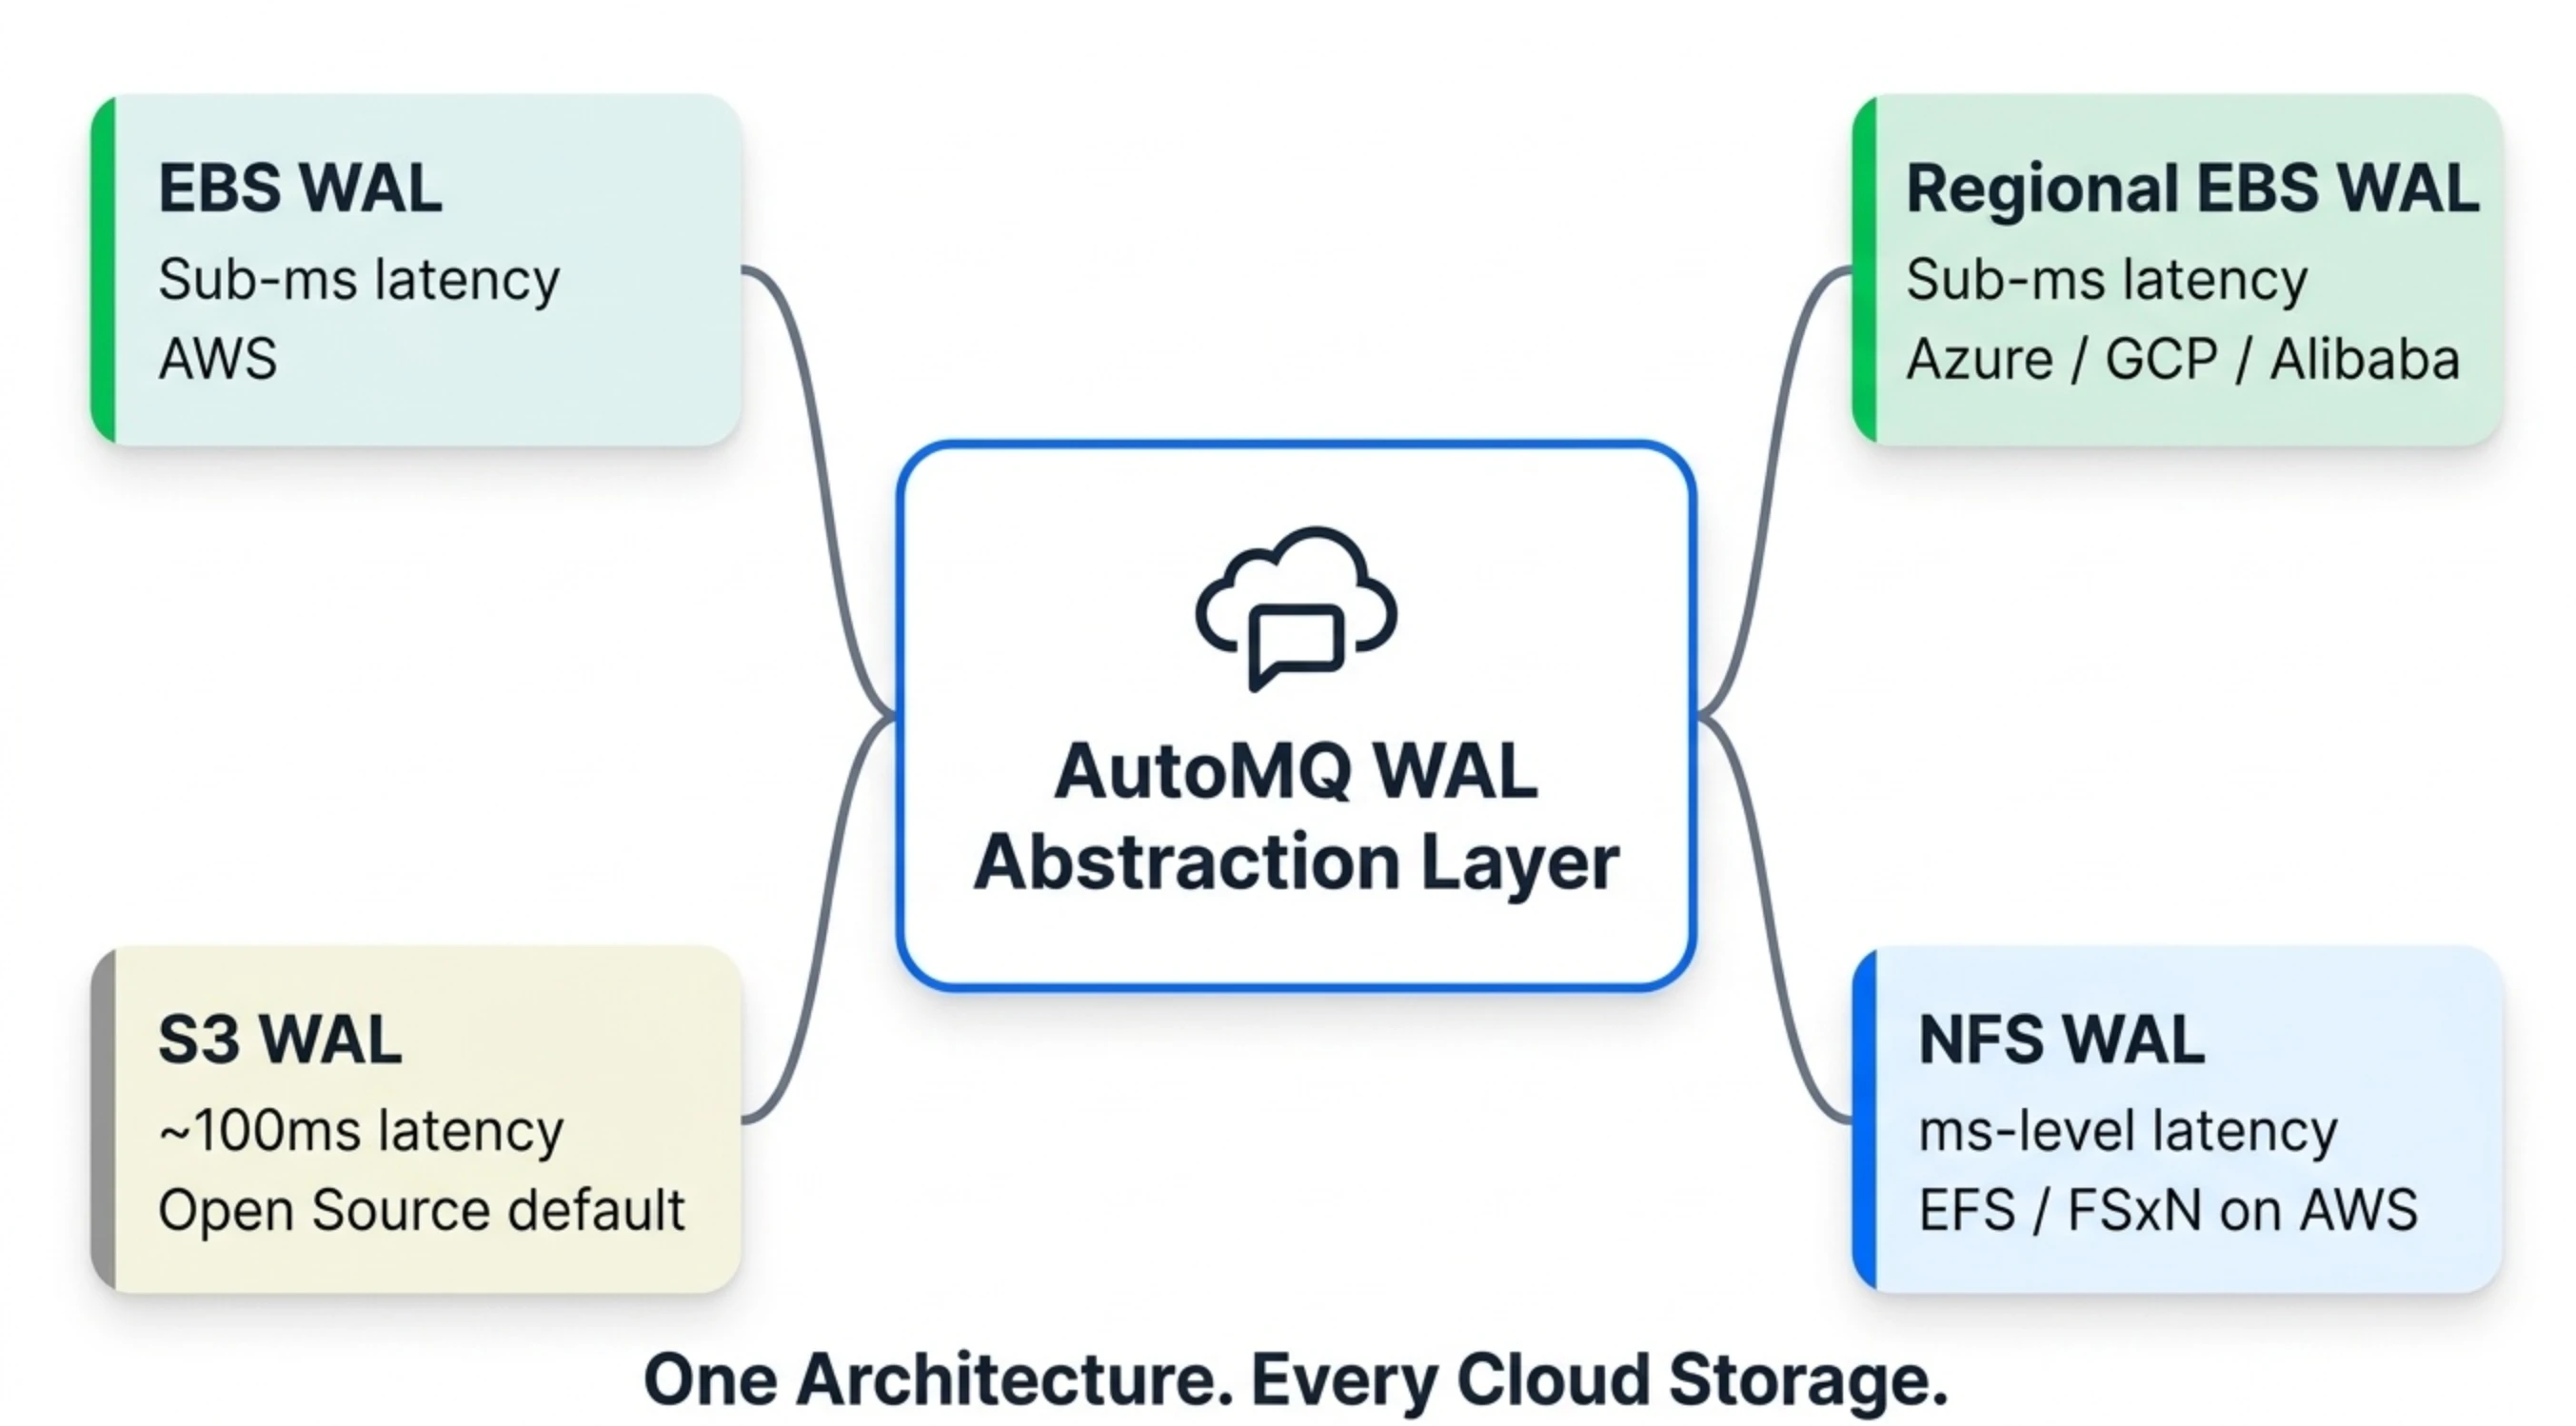
WAL 带来的另一个关键好处是让用户可以在延迟和成本之间做 trade-off。WAL 层是可插拔的,不同的云存储后端对应不同的延迟和成本特征:EBS/Regional EBS WAL 提供亚毫秒延迟,NFS WAL(AWS 上基于 FSx for NetApp ONTAP)提供平均 6ms、P99 约 13ms 的写入延迟。Producer 的体验和原生 Kafka 没有区别。

而且 WAL 的成本很低。它只需要一小块固定大小的存储空间——不是存全量数据,只是一个循环写入的缓冲区。对于大部分云存储的定价模型来说,这非常友好:每月几美元到几十美元的 WAL 支出,就能换来低延迟持久化、S3 API 成本优化、以及真正的无状态 Broker。

因为所有持久化状态都在 WAL 和 S3 中,Broker 是真正无状态的。一个 Broker 故障时,另一个 Broker 在秒级内接管分区映射,不需要数据迁移,Zero RPO——这解决了可用性耦合的问题。

最终效果是 Kafka on S3 Files 所承诺的一切——零跨 AZ 流量、无副本复制、弹性无状态 Broker——但没有持久性缺口、秒级尾延迟和高昂的流量成本。

S3 Files 作为 WAL:技术上可行,经济上还不成熟

既然 AutoMQ 的 WAL 层是可插拔的,S3 Files 能不能作为又一个 WAL 后端?从架构上看,答案是肯定的。S3 Files 提供 NFS 接口,底层基于 EFS 构建——而 AutoMQ 的 NFS WAL 已经支持 EFS 和 FSx for NetApp ONTAP 作为实现,技术路径是通的。

但当前的定价模型让这个方案的经济账算不过来。Kafka 不是一个轻量级的应用层服务,它是数据密集型的基础设施——AutoMQ 的一些生产客户集群吞吐超过 1 GiB/s,7×24 小时不间断写入。在这个量级下,S3 Files 的纯按量计费模型会产生惊人的费用。

以一个相对温和的工作负载为例——写入吞吐 100 MB/s、平均消息大小 4 KiB:

维度EFS(作为 WAL)S3 Files(作为 WAL)
写入定价EFS 弹性吞吐计费$0.06/GB 写入 + $0.03/GB 同步回 S3
高性能存储驻留费包含在 EFS 定价中$0.30/GB-月(默认驻留 30 天)
月成本估算(100 MB/s)~$15,500~$100,000(流量费 + 存储驻留费)

100 MB/s 已经是一个保守的数字了。如果换成 1 GiB/s 的生产集群,S3 Files 的月成本会突破百万美元——流量费和 EFS 存储驻留费都随吞吐量线性增长。核心问题在于 S3 Files 的定价模型是为"读多写少、活跃工作集小"的场景设计的,而 Kafka 恰好相反:持续高吞吐写入,所有数据都是"活跃"的。S3 Files 作为 WAL 的开销远高于直接使用 EFS,而延迟上并没有优势。

不过云存储的定价在持续演进。如果 AWS 为 S3 Files 引入预置吞吐模型或降低最小计费 I/O,这笔账可能很快就会变。AutoMQ 的架构已经为那一天做好了准备。

一套架构,适配所有云存储

S3 Files 的故事其实揭示了一个更大的趋势:云存储在加速分化。AWS 在过去两年推出了 S3 Express One Zone(个位数毫秒延迟的 S3)、S3 Files(NFS over S3)、以及对 EFS 和 FSx for NetApp ONTAP 的持续改进。GCP 和 Azure 也在各自的存储服务上走着类似的路线。每种存储服务针对不同的访问模式、成本模型和持久性保障做了优化。
可插拔 WAL 架构

AutoMQ 的可插拔 WAL 架构意味着我们不需要押注某一个赢家——每一次云存储创新都会成为 WAL 后端菜单上的一个新选项:

WAL 后端延迟多 AZ成本适合场景
EBS WAL亚毫秒单 AZ(多副本)低AWS 上所有 Kafka 工作负载
Regional EBS WAL亚毫秒多 AZ(多副本)低Azure / GCP / 阿里云上的生产环境(推荐)
S3 WAL百毫秒级多 AZ低延迟不敏感场景(日志、监控),开源版默认
NFS WAL(AWS 上使用 EFS / FSxN)毫秒级多 AZ中等AWS 上的低延迟场景(核心交易撮合等)

用户不需要被锁定在某一种存储方案上,而是可以根据自己的延迟要求和成本预算自由选择——并且随着需求变化或云定价演进随时切换。在 AWS 上,NFS WAL 已经支持 EFS 和 FSx for NetApp ONTAP 两种实现;在 Azure 和 GCP 上,Regional EBS WAL 利用各自的多 AZ 块存储提供亚毫秒延迟。让这一切成为可能的 WAL 抽象层,从第一天起就是这么设计的。

回到最初的问题

Kafka 构建在 S3 Files 上,是个好主意吗?如果说的是把原生 Kafka 直接挂载上去——不是。Kafka 的异步 I/O、基于副本的 HA、对本地存储的假设,这些设计决策会让你回到原点:还是要管副本、管故障转移、管容量规划。共享存储就在那里,但 Kafka 的架构用不上。

但 Kafka 向 Shared Storage 架构演进的方向是确定的——经济账和运维收益太有说服力了。AutoMQ 基于 WAL 的 Shared Storage 架构已经交付了这个承诺,而且每当云存储向前迈进一步,可插拔的 WAL 层就把这次创新变成用户的一个新选项。一套架构,适配所有云存储。

Debian 10 生产级 Kafka 手动部署指南:从 JDK 调优到 systemd 深度管控 Apache Kafka 是一种高吞吐、低延迟的分布式流处理平台,其稳定运行高度依赖底层操作系统与 JVM 的协同调优。理解 Kafka 原理需掌握其核心组件(Broker、Producer/Consumer、Controller)与协调机制(如 KRaft 或 ZooKeeper),而技术价值体现在实时数据管道、事件驱动架构和弹性水平扩展能力。典型应用场景包括支付对账、IoT 设备上报和实时风控系统,这些场景对消息持久性、端到端延迟和集群可用性提出严苛要求。在 Debian 10 这类以稳定性见长的 LT 阅读详情

相关推荐

Lakehouse架构实战:云原生实时数仓与SQL化治理落地指南

Lakehouse作为融合数据湖弹性与数仓管理能力的新一代架构,其核心在于通过Delta Lake/Iceberg等开放表格式实现ACID事务、Schema演化与时间旅行,结合Flink/Trino/Spark等引擎协同完成批流一体计算。技术价值体现在显著降低数据错乱率、支持声明式SQL建模及自动血缘追踪,广泛应用于实时风控、电商GMV分析、用户行为洞察等高时效性场景。本文聚焦Lakehouse在云原生环境下的真实落地路径,涵盖S3存储优化、Flink实时建模、dbt SQL化治理、Delta元数据协同等关

chupu2979的博客 337

PySpark 读写 AWS S3 生产级配置与避坑指南

Apache Spark 通过 Hadoop FileSystem 接口与对象存储交互,其中 s3a 协议是当前唯一支持完整目录语义、分片上传和最终一致性校验的生产就绪方案。其底层依赖 aws-java-sdk-bundle 与 hadoop-aws 的严格版本协同,任何不匹配都可能引发 NoSuchMethodError 或元数据不一致。认证环节需优先采用 IAM Role(InstanceProfileCredentialsProvider),规避密钥硬编码与权限泄露风险;而性能瓶颈80%源于 LIST

weixin_34166472的博客 428

Delta Lake:数据湖的ACID临界点与事务层本质

数据湖架构长期面临可信性缺失、并发写入冲突、历史数据不可溯等核心挑战。Delta Lake并非新型存储格式,而是构建于Parquet之上的轻量级事务日志协议,将数据库级ACID、Schema强约束与Time Travel能力原生注入对象存储。其技术价值在于实现数据版本化、可测试、可回滚的工程化治理,支撑AI驱动的实时决策场景。典型应用场景包括银行级转账一致性保障、分钟级数据事故恢复、流批一体ETL自动化(Delta Live Tables)及变更数据捕获(CDF)。本文深入解析其日志协议设计、S3原子性实现

weixin_34295316的博客 457

MySQL与MinIO数据存储选型指南:从核心原理到工程实践

在数据存储领域,理解不同技术的核心原理是做出正确技术选型的基础。关系型数据库通过ACID事务、SQL查询和数据关联机制,为结构化数据提供强一致性和复杂查询能力,是处理交易、用户信息等核心业务数据的基石。对象存储则采用扁平化架构和分布式设计,专为海量非结构化数据而生,提供高吞吐、高扩展的文件存取服务,适用于图片、视频、日志等静态资源存储。从技术价值看,关系型数据库确保数据精确与完整,而对象存储追求规模与成本效率。在实际应用场景中,现代应用架构常将两者结合使用,例如用户信息存于MySQL,而用户上传的文件则由M

cuanji3287的博客 488

Data Engineering Pipeline:数据生命体征监护系统架构实践

Data Engineering Pipeline(数据工程流水线)是现代数据平台的核心基础设施,其本质远超传统ETL脚本或黑盒工具——它是一套具备可追溯性、可观测性与可演进性的数据生命体征监护系统。基于Flink、Kafka、Delta Lake和dbt的分层服务网格架构,通过采集层、缓冲层、计算层和服务层解耦,实现故障域隔离、弹性扩缩与秒级异常感知。该架构支撑实时风控、BI报表、CDC同步等关键场景,显著提升数据质量、降低运维成本,并为审计合规与业务迭代提供坚实底座。

weixin_34387468的博客 822

数据工程Pipeline实战:从高可用设计到生产级运维

数据工程Pipeline是支撑实时分析、AI模型与业务决策的核心基础设施,其本质并非简单ETL流程,而是融合事件驱动、状态管理、不可变存储与端到端SLA保障的协同系统。基于Flink实时计算、Delta Lake事务存储、Kafka流式传输等关键技术,Pipeline需兼顾低延迟(如风控毫秒级响应)、高可靠(exactly-once语义)与强可观测性(血缘追踪+多维监控)。它广泛应用于电商实时大促、金融风控特征更新、SaaS用户行为分析等场景,核心价值在于将原始数据转化为可信、及时、可解释的业务资产。本文聚

dienangpiao2051的博客 459

Kafka零ETL写入Iceberg:从数据管道到数据直通车的架构演进与实践

在实时数据集成领域,数据管道是连接消息队列与数据存储的核心组件,其设计直接影响数据处理的时效性与运维复杂度。传统基于Flink或Spark Streaming的ETL链路,虽能实现数据流转,但常伴随开发运维成本高、数据延迟与端到端一致性难保证等挑战。其技术价值在于通过简化架构,降低运维负担,提升数据入湖效率。具体原理是借助Kafka Connect框架与Iceberg Sink Connector,将Kafka中的消息自动解析、映射并写入Iceberg表,实现近乎实时的结构化数据同步。这一方案尤其适用于日志

快马扬鞭须努力! 350

Apache Iceberg:数据湖的ACID操作系统与生产落地指南

数据湖表格式是支撑现代湖仓一体架构的基础技术,其核心能力包括ACID事务、Schema演进、时间旅行和隐藏分区。Apache Iceberg作为开放表格式标准,通过元数据分层、快照隔离与乐观并发,在对象存储上低成本实现数据库级数据可靠性。相比Hive的强耦合文件路径与锁机制,Iceberg以松耦合元数据协议解耦存储与计算,显著提升并发写入性能、查询裁剪效率与跨引擎兼容性。本文聚焦Iceberg在Spark/Flink/Trino多引擎环境下的生产部署、核心操作、避坑实践与湖仓落地验证,涵盖隐藏分区、MERG

weixin_30607659的博客 324

数据科学家的云原生能力三维模型:管道、训练、服务实战

云原生已成为数据科学落地的核心基础设施,其本质是将算法能力与分布式系统工程深度耦合。理解S3数据湖分层、EMR/YARN资源调度、Kubernetes模型服务等底层原理,才能突破本地开发到生产部署的断层。本文聚焦数据科学家必须掌握的三大云场景:云原生数据管道构建(含权限、缓存、熔断)、弹性模型训练编排(含内存墙、网络墙、存储墙应对)、灰度模型服务契约(含版本管理、流量路由、健康探针)。所有方案均源自12个脱敏企业级项目,强调可验证、可拆解、可复现,拒绝课程推荐话术,直击从Scikit-learn到SageM

weixin_30352645的博客 410

现代数据Pipeline:分段自治与全局可观测性架构实践

数据Pipeline已从传统ETL流水线演进为支撑企业实时决策的‘数据生命体征监护系统’。其核心原理在于放弃端到端强一致性,转向分段自治(采集、缓冲、计算、治理)与全局可观测性(Metrics/Logs/Traces+血缘)协同设计,以应对业务混沌、规模扩张与质量可信的三重挑战。该架构显著提升故障定位效率(MTTR从23分钟降至47秒)、保障SLA分级执行,并为数据血缘、质量门禁、智能预警等高阶能力奠定基础。本文聚焦Kafka Schema注册、Flink状态管理、DataHub元数据自动注册等硬核落地细节

weixin_33912246的博客 417

Lakehouse架构核心原理与生产落地实践

Lakehouse是一种融合数据湖灵活性与数据仓库可靠性的现代数据架构,其本质是以开放表格式(如Delta Lake、Iceberg)为底座,依托ACID事务保障、统一元数据管理和分层解耦设计,在对象存储上实现批流一体、BI与AI协同的数据管理能力。它解决了传统数据湖数据可信度低、计算耦合强、治理失效等核心痛点,技术价值体现在存储计算分离、Schema演化可控、细粒度权限可实施。典型应用场景包括实时风控、电商推荐、IoT日志分析等需要高一致性、低延迟和强治理的业务领域。本文聚焦Lakehouse在真实生产环

weixin_30357231的博客 687

【springboot】万字操作指南 Spring Boot 2.x 升级到 3.x:微服务项目实战

摘要: 本文提供Spring Boot 2.x升级到3.x的实战指南,重点针对微服务项目。升级涉及JDK 17、Spring Framework 6、Jakarta EE等连锁变化,需系统规划版本矩阵(如Spring Boot 3.5.x + Spring Cloud 2025.0.x)。建议升级路线:先统一JDK 17环境,再处理依赖迁移(javax→jakarta)、Spring Security 6适配、OAuth2授权服务器改造等关键步骤。

Cjh20pan的博客 975

【信息科学与工程学】【数据中心】 第二十三篇 DDC网络-满足大规模训练、推理、存储区网络(Roce2组网)

特征维度具体特征网络影响设计考虑通信模式​集体通信为主(All-Reduce/All-Gather)多对多通信模式需要高带宽、低延迟的All-to-All连接流量模式​同步、周期性、模式可预测突发带宽需求高需要高效的拥塞控制和流量调度延迟敏感性​端到端延迟敏感(μs级)尾延迟影响训练时间需要无损网络、确定性延迟带宽需求​持续高带宽(100-400Gbps/节点)网络容量压力大需要高带宽、无阻塞网络扩展规模​数千到数万GPU节点可扩展性挑战需要层次化、模块化设计存储访问​大块顺序读写为主存储带宽需求高需要高带

weixin_49199313的博客 1880

腾讯AI新底座磐石:面向生产的模型可编排与治理实践

大模型工程化正从‘能跑’迈向‘稳用’,核心挑战在于模型生命周期管理、推理可靠性保障与数据可信溯源。AI原生基础设施(AI-Native Infrastructure)通过模型编排、推理治理和数据契约三大控制平面,实现对模型版本灰度、链路熔断、血缘追踪等关键能力的标准化封装。它不依赖堆砌参数或算力,而是以声明式CRD、硬编码SLA规则和轻量日志染色等工程手段,解决GPU显存碎片、语义漂移、输入类型错位等高频生产问题。适用于企业级AI平台建设者、MLOps工程师及算法团队技术负责人,尤其关注模型上线周期压缩、M

weixin_34080951的博客 339

云服务器安装ros教程

要在 CentOS 7 系统上安装 RouterOS,您需要将 RouterOS 安装为虚拟机或直接安装到物理硬盘上。这里提供的是将 RouterOS 安装到物理硬盘上的步骤,这将完全替换现有的 CentOS 7 系统。请确保您已经备份了所有重要数据。

qq_37662563的博客 2145

4.图像sensor的特性和驱动解析

例子:sensor驱动自己提供操作曝光时间的函数和获取曝光时间的函数,然后将这个函数注册到ISP库和3A算法库,3A算法库根据外部光照强度计算出一个Sensor曝光时间的设置值,ISP库得到这个设置值,然后通过Sensor之前注册的回调函数,把这个值设置到Sensor的硬件寄存器中去,实现整个过程。是为 ISP 配置正确的输入时序。(1)修改驱动源码(sambashar\Hi3518E_SDK_V1.0.3.0\package\mpp\component\isp\sensor\ar0130)

weixin_53762042的博客 3566

Delta lake第一稿个人翻译和注释(第四章)

亚马逊S3等云对象存储是全球规模最大、最具成本效益的存储系统之一,因此成为存储大型数据仓库和数据湖的理想之选。遗憾的是,它们作为键值存储的实现使得实现ACID事务和高性能变得困难:元数据操作(如列出对象)成本高昂**(解释:对象存储在云上面list操作费用是get操作的10倍,并且抽取类似元数据次数多了,费用很贵;所以整体思想是减少list操作,有个元数据管理文件,然后从文件抽取必要文件然后采取 get操作),一致性保证也有限。

knowcai126的博客 291

C语言实验——各位数字之和排序

C语言实验——各位数字之和排序Time Limit: 1000 ms Memory Limit: 65536 KiB Submit Statistic Discuss Problem Description给定n个正整数,根据各位数字之和从小到大进行排序。 Input输入数据有多组,每组数据占一行,每行的第一个数正整数n,表示整数个数,后面...

aiLMengi000的博客 1243

去IOE终极无状态化改造:PHP在国产云原生环境下的状态剥离、分布式Session路由与本地文件存储的底层解耦》

比如 一级域名:baidu.com 二级域名:www 三级域名_.www.baidu.com.三级域名就是_下划线的哪个

qq_37805832的博客 1万+

ADS 使用教程(十八)Encrypting Designs using RFIP Encoder in ADS

在这一节,我们使用RFIP Encoder进行设计加密,这是一种保护知识产权和敏感设计数据的重要方法。RFIP Encoder提供了一种安全的方式来加密设计文件,确保只有授权人员能够访问和使用这些文件。

Dirge19的博客 1169

CoDeSys系列-3、Windows运行时软PLC主站和p-net从站IO设备组网测试

前面CODESY下载安装并熟悉了,p-net搭建从站也已经跑在虚拟机树莓派上了,我们只需要快速搭建一个profinet主站来和从站进行交互即可,这里我们直接用Windows下带的软PLC搭建profinet主站并和p-net的demo从站程序进行IO交互。评估是否进行Windows下的运行时PLC前先看一下注意事项,Windows下安装配置会需要修改boot及防火墙等,可能会影响Windows电脑的正常使用,所以创建项目时的设备可以选择非RTE的。

逍遥游的博客 7313

智能体会话状态管理:事件日志驱动的运行时架构

智能体(Agent)系统的核心挑战在于状态持久化与上下文管理。传统方案将状态强耦合于模型上下文窗口,受限于Transformer的O(n²)计算复杂度和显存瓶颈,易引发静默截断、历史丢失与不可回溯等生产事故。'会话即事件日志'是一种基于CQRS(命令-查询职责分离)原理的工程范式,通过将状态抽象为只追加、不可变的分布式事件流(如Kafka),实现状态与行为解耦,显著提升系统韧性、可审计性与水平扩展能力。该架构天然支持会话断点续跑、跨模型迁移与细粒度安全隔离,已成为高可靠AI应用的事实标准。本文深入解析其在M

weixin_30599769的博客 431

(MATLAB)一维信号峰值检测findpeaks

一维信号波峰波谷检测,峰值、峰宽、到达时间计算。MATLAB自带的findpeaks函数能完成这一任务,在这里分享其基本用法与特殊用法。

HPC_ZY 2万+

AI代理运行时基础设施:从上下文坍塌到事件日志驱动的生产级演进

AI代理(Agent)作为大模型落地的核心范式,其稳定性和可运维性高度依赖底层运行时(Runtime)设计。传统‘上下文即一切’模式受限于token物理上限、长程记忆衰减与调试不可见等根本缺陷,导致逻辑断裂、审计失能与成本失控。新一代Agent Runtime通过‘Session-As-Event-Log’架构实现状态、执行、凭证与可观测性的四重解耦,将会话转化为结构化、持久化、可查询的事件流,支撑高可靠、可审计、可恢复的生产实践。该范式已成Anthropic Managed Agents、AWS Agen

chouzu8463的博客 384

SCADA|KingSCADA通过组合框选择修改变量的值

《SCADA项目中组合框控件的使用方法》 本文详细介绍了SCADA系统中组合框(下拉框)控件的应用方法。通过具体示例演示如何实现:当选择"雷工笔记"时变量值为100,选择"雷工杂谈"时为200,选择"小李食代"时为300的功能。主要实现步骤包括:1)创建项目并添加组合框控件;2)设置Items选项及对应数值;3)创建内存变量;4)使用GetCurrentIndex()和GetItemData()方法;5)在选项变化事件中编写脚本。该控件在SCADA

做有价值的事,积累有价值的笔记! 864

YOLOv11 改进 - 特征融合 | 小目标检测救星:DySample动态上采样减少特征丢失

本文介绍了超轻量且高效的动态上采样器DySample与YOLOv11的结合,以解决传统上采样器工作负载大、应用场景受限的问题。DySample从点采样角度构建上采样,绕过动态卷积,使用PyTorch标准内置函数实现,无需定制CUDA包,能大幅减少参数、FLOPs等资源消耗。我们将DySample代码集成进YOLOv11。实验脚本显示,结合DySample的YOLOv11在多个密集预测任务中或表现出色。

魔改工程师的博客 1415
上一篇: 别再每月浪费数千美元:拆解 AWS/GCP Kafka 背后的隐性账单
AutoMQ
博客等级 码龄3年 1206粉丝 157原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值