技术干货|为什么越来越多企业放弃 Flink/Spark,用 AutoMQ 替代传统 ETL?

基于Arduino的智能垃圾桶 通过本次简单的Arduino智能垃圾桶小实验可以快速了解Arduino的基本用法 1、材料准备 Arduino UNO HC-SR04超声波模块 SG90舵机 杜邦线 电源 电脑 2、代码分析 电机的控制 #include<Servo.h> #define duoji D5 Servo myduoji; void setup() { myduoji.attach(duoji); //舵机连接 Serial.begin(115200); } void loop() { myduoji.w 阅读详情

![Image]( https://image.automq.com/20250728bot/76nq60.png)


**文章导读**


在云原生架构逐渐成为主流的今天,越来越多企业开始将 Apache Kafka 与数据湖、Lakehouse 结合,构建实时数据分析能力。然而,Kafka 到 Iceberg 的这条链路却并不轻松:需要依赖 Flink、Spark 等复杂 ETL 工具,开发与运维成本都不低。

有没有更简单的解法?

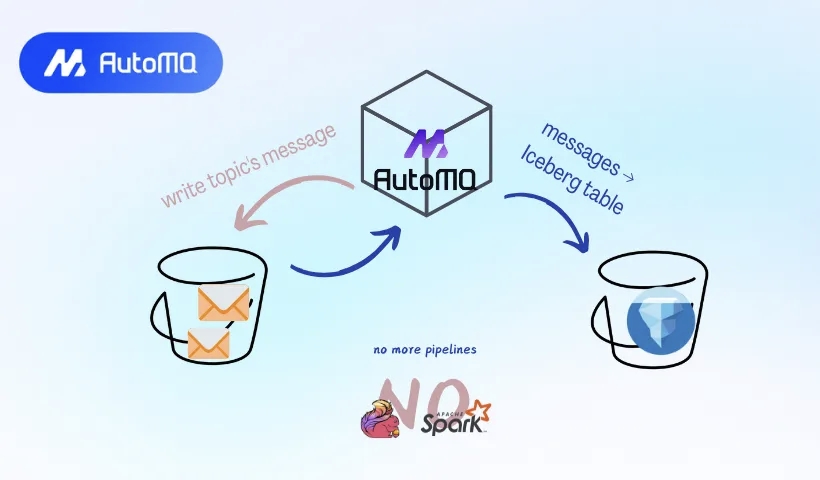
今天这篇来自海外开发者的深度好文,将带你深入了解 AutoMQ 推出的 Table Topic 功能——只需一个配置开关,就能自动将 Kafka Topic 中的数据转换为 Iceberg 表,无需任何额外 ETL 工具。

作为一款专为云而生的 Kafka,AutoMQ 在 GitHub 上已接近 6.8k Star,凭借高度兼容 Kafka 协议和对象存储优先的架构设计,正成为云上 Kafka 替代方案的新选择。

如果你正在关注 Kafka 入湖、Iceberg 实践,这篇文章值得一读。

注意:内容原始内容为英文,如需追求最原汁原味和准确的阅读体验,请直接点击底部 \[查看原文\] 阅读原始英文素材。


## **引言**


长期以来,Kafka 一直是分布式消息系统的标准。它被广泛用于服务之间的通信场景,使得某个服务无需直接与数百个其他服务通信。

“我把想说的内容写入一个 Kafka 的 Topic。如果你们想看,就从 Kafka 里消费它们。”

许多公司依赖 Kafka 协议。人们也使用 Kafka 将数据导入分析系统,比如数据仓库、数据湖或 Lakehouse。

假设我们想要通过 Kafka 的 Record 构建一个分析 Dashboard,我们就必须构建一条数据链路,使用 Kafka Connect、Spark 或 Flink 从 Kafka 的 Topic 消费数据,写入文件,并将这些文件推送到数据湖。

我们需要管理整个链路,并确保文件的物理布局是最优的。

除了 Kafka 开始使用 Object Storage 外,还有不少努力致力于简化 Kafka 的 Topic 数据到 Iceberg 表的转换过程。

本文将探讨 Kafka 架构从最初的 Shared Nothing 到 Shared Data 架构的演进。然后,我们将介绍 AutoMQ 推出的开源特性 Table Topic 背后的设计背景与实现原理,它帮助用户无需介入即可管理从 Kafka 到 Iceberg 的全链路。


## **Kafka 最初的设计**

LinkedIn 产生了大量日志数据,既包括用户行为事件(如登录、页面浏览和点击),也包括运维指标(服务调用延迟、错误或者系统资源使用情况)。

这些日志数据最初用于跟踪用户参与度和系统性能,现在也用于提升搜索相关性、推荐系统和广告投放效果等功能。

为满足 LinkedIn 在日志处理方面的需求,Jay Kreps 领导的团队构建了一个叫做 Kafka 的消息系统。这个系统融合了传统日志聚合器与发布/订阅消息系统的优势。它被设计成具有高吞吐和可扩展性。

Kafka 提供了一个类似消息系统的 API,允许应用程序实时消费日志事件。

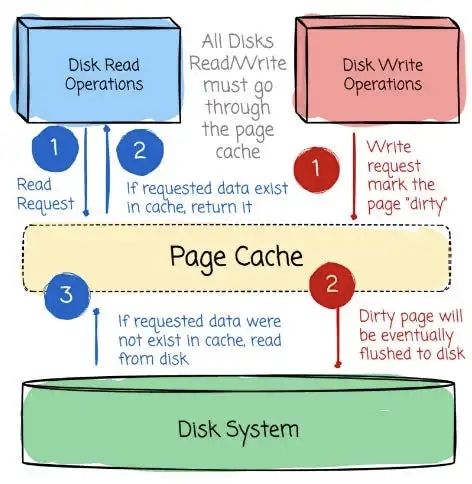
Kafka 的设计将计算和存储紧密耦合,这在当时是一种常见做法,因为那时的网络速度不像今天这么快。它通过利用操作系统的 Page Cache 和磁盘顺序访问模式实现高吞吐。

现代操作系统通常会使用未占用的内存(RAM)作为 Page Cache。这种缓存会存放频繁访问的磁盘数据,从而减少直接访问磁盘的次数。

因此,系统运行速度更快,降低了磁盘查找延迟带来的影响。

Kafka 的设计让写入(Producer 写数据)和读取(Consumer 读数据)都以顺序方式进行。
![Image](https://image.automq.com/20250728bot/3wkyyv.png)


毫无疑问,随机访问比顺序访问在磁盘上慢很多,但如果是顺序访问,有时候磁盘性能甚至可以略微超过内存。

然而,Kafka 的初始设计很快暴露出一些局限。


## **Uber 的分层存储(Tiered Storage)**

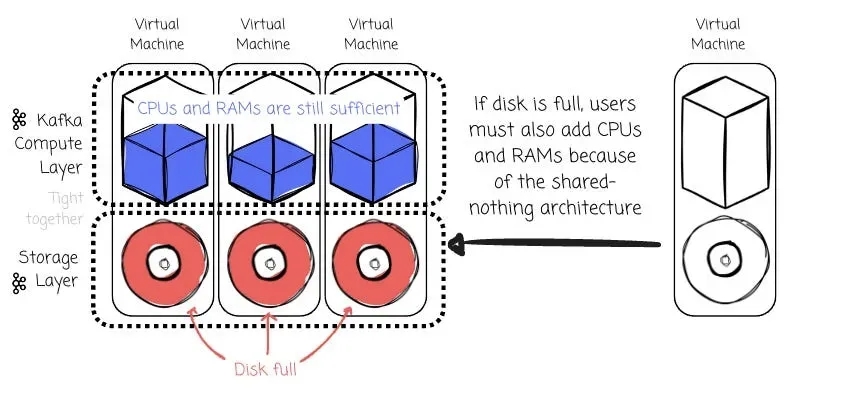
这种紧耦合设计意味着如果要扩展存储,就必须添加更多机器,这会导致资源利用效率低下。
![Image]( https://image.automq.com/20250728bot/1da4gq.png)


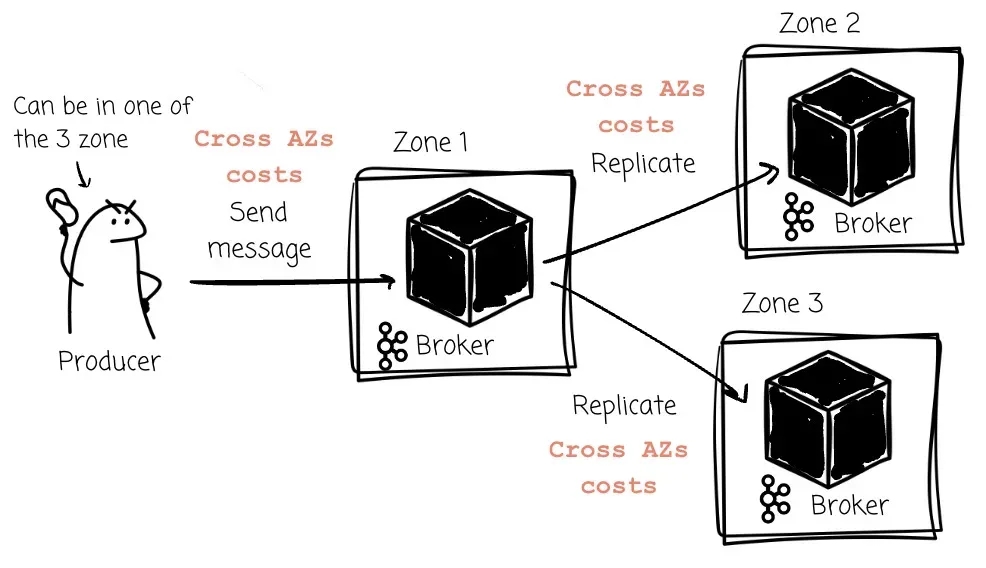
Kafka 的设计也依赖副本机制来保证 Record 的持久性。每个 Partition 有一个 Leader 和若干 Follower(用于存储副本)。所有写入都必须发给该 Partition 的 Leader,而读取可以由 Leader 或 Follower 提供。
![Image](https://image.automq.com/20250728bot/bxzy5v.png)


当 Leader 接收到 Producer 发来的 Record 后,它会将这些 Record 同步到 Follower。这保证了数据的持久性与可用性。

由于 Kafka 的存储与计算是耦合的,所以每当集群成员发生变更时,数据必须在网络中进行迁移。

当公司在云上运行 Kafka 时,这些问题会进一步放大:

ꔷ 由于计算和存储无法独立扩展,它无法充分利用云上按需计费的优势。

ꔷ 因为消息要跨不同的可用区(AZ)复制,可能会带来很高的跨 AZ 数据传输费用。

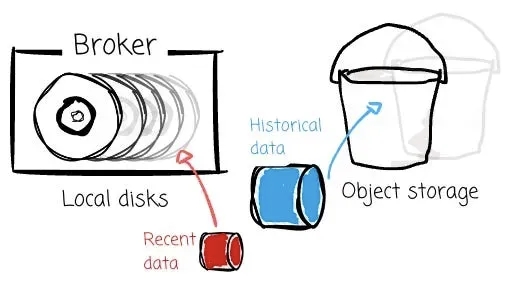
为了应对这些限制,Uber 提出了 Kafka 的 Tiered Storage(KIP-405),引入了两级存储体系:
![Image](https://image.automq.com/20250728bot/szvvli.png)


ꔷ 本地存储(Broker 磁盘)保存最近的数据;

ꔷ 远程存储(HDFS/S3/GCS)保存历史数据。

然而,这个问题并没有被完全解决,因为 Broker 依然是有状态的。


## **共享数据的趋势**


2023 年,构建基于 Object Storage 的 Kafka 架构开始兴起。自那时以来,已有至少五家厂商推出了类似的解决方案。2023 年,我们看到了 WarpStream 和 AutoMQ 的发布;2024 年,又有 Confluent Freight Clusters、Bufstream 和 Redpanda Cloud Topics 的加入。
![Image](https://image.automq.com/20250728bot/0k0fiy.png)


这些新系统承诺作为 Kafka 的替代方案,可以:

ꔷ 成本更低;

ꔷ 更易于维护和运维。

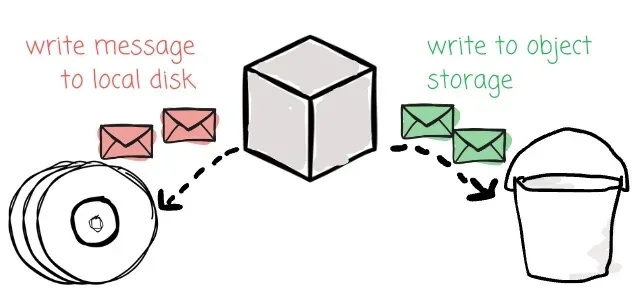
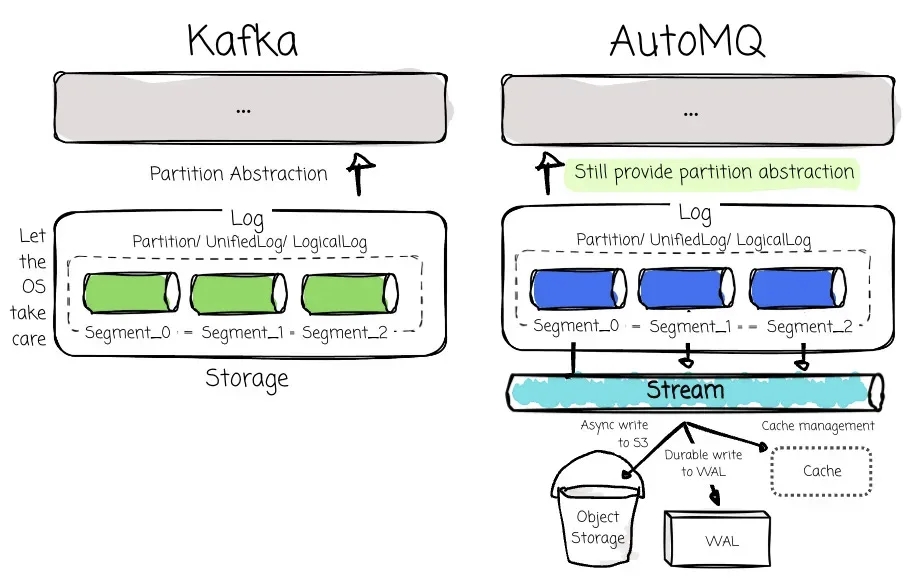
每家厂商都有自己的实现方式。从整体来看,这些系统都尝试兼容 Kafka 协议,并将完整数据存储到 Object Storage 中。Bufstream 和 WarpStream 从头开始重写 Kafka 协议;而 AutoMQ 则选择了一种完全不同的方法——复用 Kafka 协议层代码,以确保 100% 兼容性,同时重构底层存储,使 Broker 能够直接将数据写入 Object Storage,并通过引入 Write-Ahead Log 来避免带来额外延迟。
![Image](https://image.automq.com/20250728bot/rbebwx.png)


当然,在 Object Storage 上构建兼容 Kafka 的解决方案并非易事。确保 Kafka 协议兼容性本身就是一个挑战,因为它的核心技术设计就是基于本地磁盘:包括将 Record 追加到物理日志中、将 Topic 拆分为多个 Partition、在 Broker 之间进行副本复制、负载均衡、请求 Leader 信息进行写入、以及通过 Segment file 定位 Offset 来服务消费者等等。

因此,迁移至另一种存储介质(例如 Object Storage)并不容易。此外,还要考虑延迟、元数据管理、吞吐能力、缓存管理等多个方面。

> 如果你感兴趣,我曾写过一篇专门的文章,深入探讨构建像 AutoMQ 或 WarpStream 这类系统可能遇到的所有挑战:[Deep dive into the challenges of building Kafka on top of S3](https://mp.weixin.qq.com/s?__biz=MzkxNzY0ODE2Ng==&mid=2247487818&idx=1&sn=c1a702155669d049a8f78fa64b9c9c19&scene=21#wechat_redirect)。


## **共享数据**


数据是新时代的石油。

每家公司都希望具备捕获、存储、处理和服务数据的能力,以支持关键业务决策。数据工程师需要整合来自多个来源的数据,对其进行存储、转换,并通过统一的数据平台对外提供服务。

过去,在构建分析数据仓库时,数据仓库通常是不二之选。但随着现代表格式的发展,这一格局正在被一种新方案取代——Lakehouse。\[1\]

![Image](ttps://image.automq.com/20250728bot/d9wnl2.png)


Lakehouse 提出了一个简单的理念:使用一个巨大的存储(Object Storage)来无限存储数据(除了预算限制),你可以任意选择查询引擎进行处理。用户对数据拥有更多的控制权,同时具备更灵活的引擎选择空间。它融合了数据湖和数据仓库的优势。

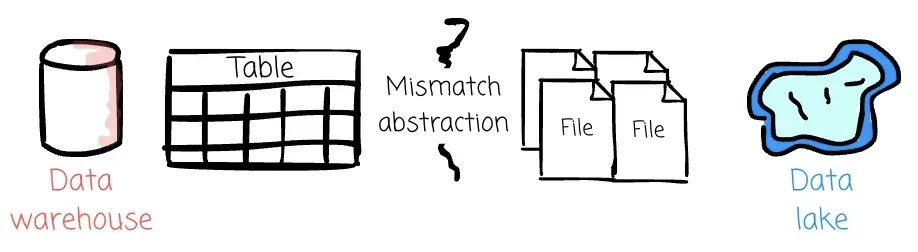
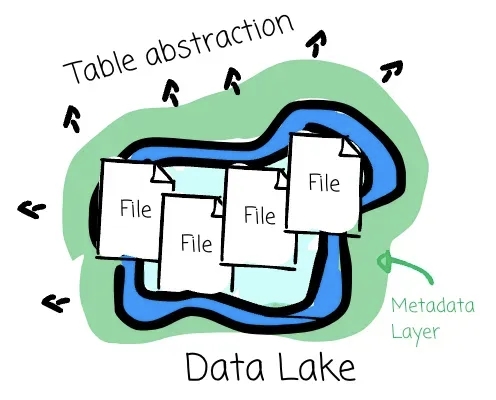
然而,要将数据仓库的特性(如 ACID 事务语义、时间旅行等)引入数据湖并不容易。这两个系统的抽象方式不同:数据仓库面向的是表,而数据湖管理的则是文件。
![Image](https://image.automq.com/20250728bot/be3n1i.png)


我们需要一个元数据层,把表的抽象带入数据湖。这正是 Delta Lake、Hudi 或 Iceberg 等表格式的价值所在。
![Image](https://image.automq.com/20250728bot/ur8nb3.png)


它们提供了 ACID 事务语义,并支持多种数据仓库功能,例如 Schema 演进、数据版本控制、时间旅行,以及针对性能的优化技术。

>如果你想进一步了解这些开放表格式的兴起,可阅读这篇文章:\[2\]

>Iceberg 正受到越来越多的关注,因为它能够良好地与多种系统协同工作。像 Google、Amazon、

Databricks、Snowflake 等厂商都原生支持与 Iceberg 表的交互。\[3\]

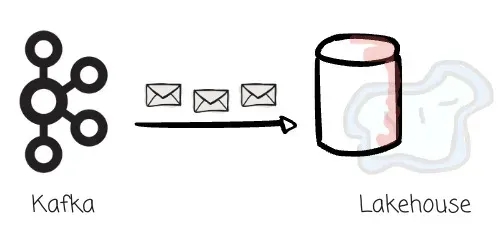
一家使用 Kafka 的公司,往往也会使用它将数据流式写入分析系统。随着 Lakehouse 模式的兴起,企业对将 Kafka 的 Record 写入 Iceberg 表的需求也在不断增长。
![Image](https://image.automq.com/20250728bot/thfoou.png)


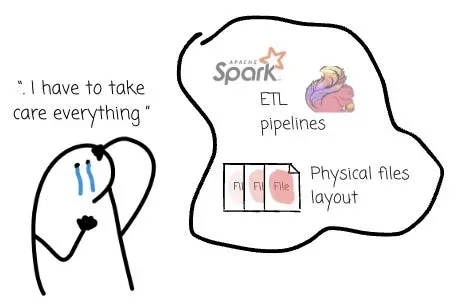
然而,Kafka 到 Iceberg 的数据链路并不简单。用户需要使用 Flink、Spark 或 Kafka Connect 等工具定义处理逻辑,还要运维这些系统,并确保 Iceberg 表的物理布局最优。
![Image](https://image.automq.com/20250728bot/t2mpwb.png)


这也是为什么越来越多 Kafka 替代产品开始支持将 Kafka Topic Record 写入 Iceberg 表这一功能。
![Image]( https://image.automq.com/20250728bot/ix2atw.png)

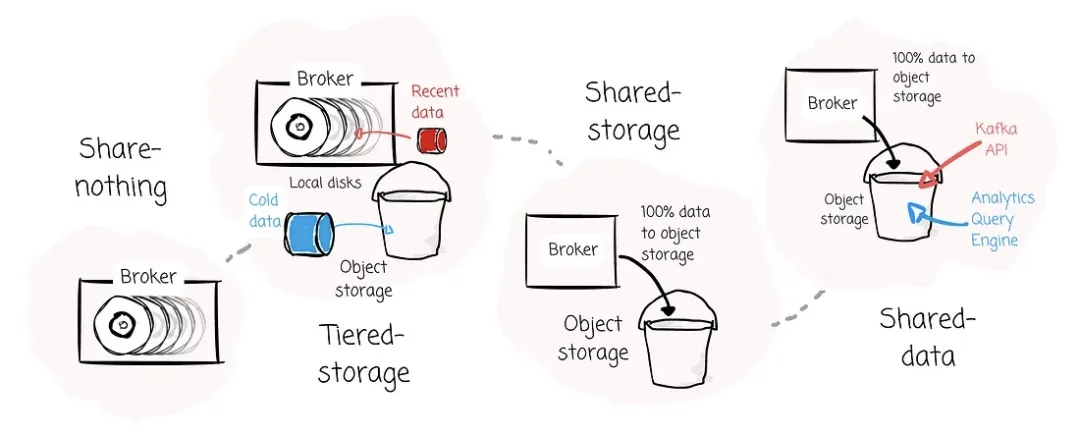
从最初的 Shared Nothing 架构,到 Tiered Storage(broker 仅保存部分数据),再到 Shared Storage(数据 100% offload 到 Object Storage),Kafka 的架构正在不断演进。现在,我们可能正处于下一阶段的开端——Shared Data 架构,数据既通过 Kafka API 提供实时访问,也可以作为 Iceberg 表被分析引擎消费。

鲜为人知的是,AutoMQ 是业内首个公开提出 Shared Data 架构的厂商。


## **AutoMQ 的 Kafka → Iceberg 路径**


当 S3 TABLE 功能首次发布时,AutoMQ 同步推出了 Table Topic 功能,借助 S3 TABLE,可将 Kafka Topics 自动转换为 Iceberg Tables。

这一功能最初仅在企业版中可用。近期,AutoMQ 正式将 Table Topic 功能引入了开源版本(PR-2513)。他们认为,流到表(stream-to-table)能力将是 Kafka 的下一个关键趋势。


### **动机**

AutoMQ 在与客户合作过程中观察到两个核心问题。

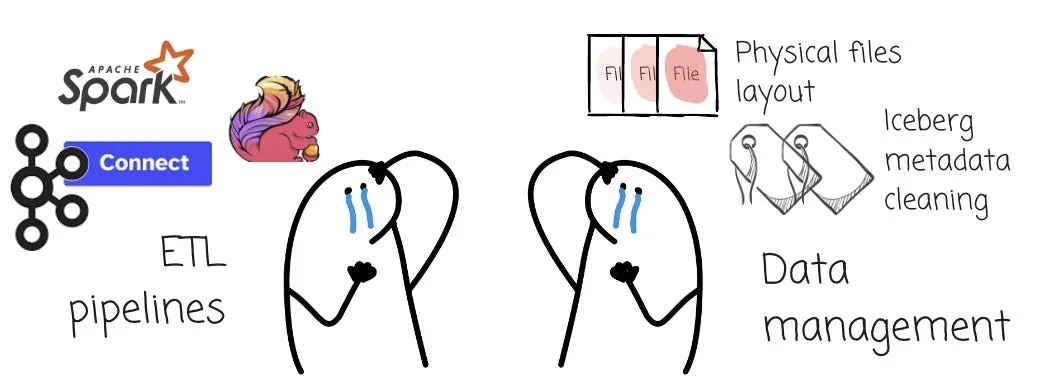
**首先**,企业在使用 Kafka 将数据写入 Lakehouse 时,存在真实的痛点,主要集中在 ETL 流程和数据管理层面。
![Image](https://image.automq.com/20250728bot/8lp03z.png)


每个 Kafka Topic 都需要一条 ETL 流水线,将数据消费并转换为开放表格式。大量的 Topic 会产生大量 Spark/Flink 作业任务。管理、监控、运维和治理这些作业并不容易。而数据管理也同样棘手:如何处理脏数据或损坏的数据?如何应对 schema 的变更?

除了构建 ETL 所需的资源,每张表还需要独立资源来管理 Object Storage 上的数据:包括清理过期数据/元数据、合并小文件,以及优化读取性能等。

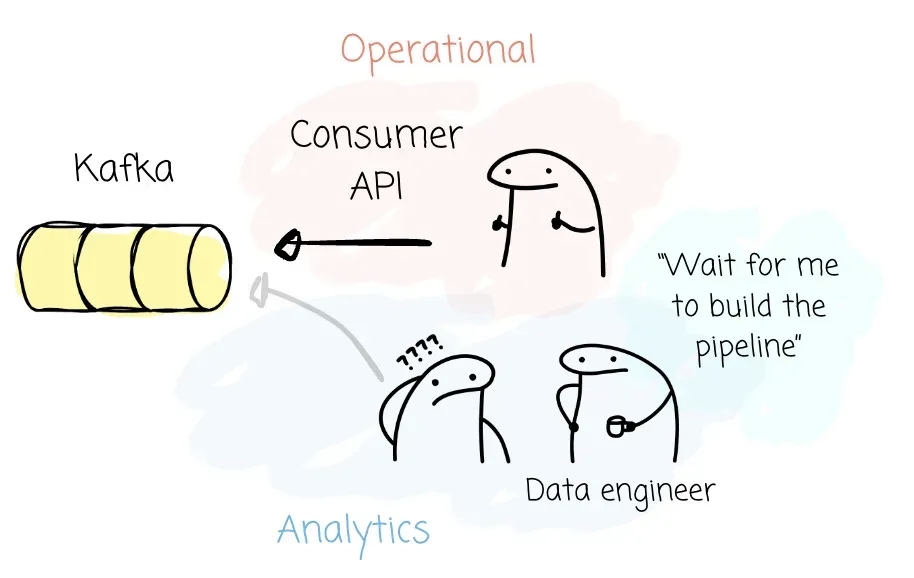
**其次**,企业内部存在数据共享的需求,需要在 API 与服务之间进行数据的共享与理解。Kafka 在业务数据共享场景中表现良好,微服务之间可以通过 Kafka 协议交换数据。
![Image](https://image.automq.com/20250728bot/bf21rm.png)


但在分析场景下,这远远不够。Apache Kafka 只是将你的 Record 视为字节数组,并不了解数据的 Schema 与语义。人们需要将 Kafka 中的数据转换成更适合分析的结构化格式,而 Iceberg 就是当前最有力的候选方案之一,因其在生态中的广泛适配。


### **概述**

用户只需设置 **automq.table.topic.enable** 这一配置,即可启用 Kafka-Iceberg 的能力。

启用后,Producer 仍通过 Kafka 协议向 AutoMQ 写入数据。Broker 先将数据写入 Kafka Topic,然后在后台进行批量聚合后转换为 Iceberg 表。从此,查询引擎便可直接消费这张表,满足分析需求。
![Image](https://image.automq.com/20250728bot/j7l4l8.png)


AutoMQ 会自动处理从 Schema 提取到写入 Iceberg catalog 的整个流程。用户无需再维护复杂的 ETL 作业,只需使用 Kafka API 生产数据,AutoMQ 就能自动将其转换为 Iceberg 表。

目前,AutoMQ 仅在 AWS 上支持 Table Topic,兼容的 Catalog 包括 REST、Glue、Nessie 和 Hive Metastore。未来还计划拓展至更多云平台。


### **自动管理 Schema**

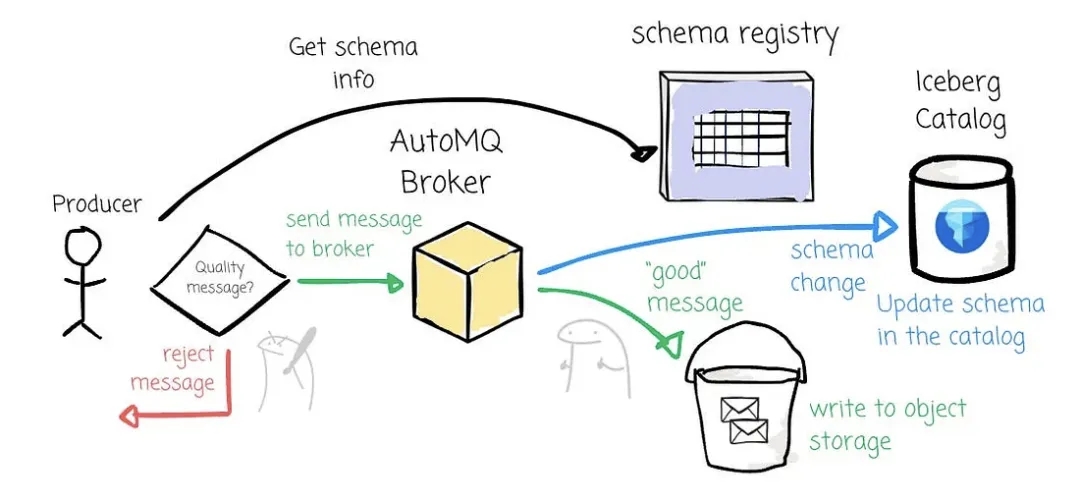
AutoMQ 使用 Kafka 原生的 Schema Registry 作为数据质量的守门机制。当 Producer 发送数据时,系统会检查其是否符合从 Schema Registry 获取的 Schema,如果不符合,则拒绝该条 Record。
![Image](https://image.automq.com/20250728bot/8g9orj.png)


当 Schema 发生变更时,AutoMQ 会从 Kafka Record 中提取 Schema version,并通过 Schema Registry 获取新的 Schema 信息。随后更新 Iceberg 表的 Schema,从而实现数据持续写入不中断。

这得益于 Iceberg 等表格式对 Schema 演进的原生支持,允许在不重写整个数据集或中断下游任务的情况下,完成新增字段、删除字段、修改字段类型等变更。

与在 Flink/Spark 作业中硬编码表结构不同,AutoMQ 通过 Kafka Schema Registry 将原本分散在各处的 Schema 定义集中管理,构建统一的“单一事实源”。这显著减少了元数据维护工作,并确保 Kafka API 的实时访问与底层 Iceberg 表之间 Schema 的一致性。


### **Iceberg 分区**

注意:这里的 Partition 概念描述的是 Iceberg 表中物理数据的组织方式,并非 Kafka 的 Partition。

在 OLAP 系统中,最常见的性能优化方式就是尽可能减少数据扫描量。为此,数据分区是一种广泛推荐的策略。假设一张表包含 6 年的数据,而用户只需查询最近一个月的数据,分区策略能帮助系统仅读取这部分数据,而无需全表扫描。

分区的作用就在于此:你可以配置某个字段(例如 Month 字段)为分区列,系统会将表拆分成多个独立区域并分别存储。这样,查询引擎就可以根据用户的查询条件,仅读取所需的分区数据。
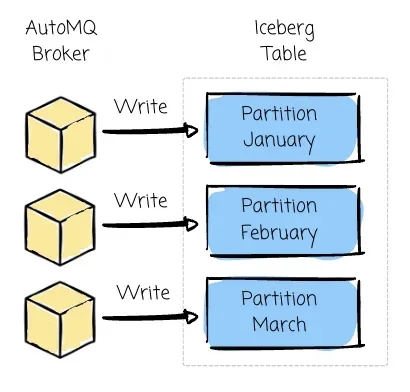
![Image](https://image.automq.com/20250728bot/4ea04v.png)


用户可以在 AutoMQ 中定义包含多列的 Iceberg 表分区方案,以便将 Kafka 的主题数据写入 Iceberg 的关联分区中。用户可以使用设置来配置分区策略 automq.table.topic.partition.by,例如 automq.table.topic.partition.by=\[month(date)\]。


### **高效的 Upsert**

AutoMQ 还支持 Upsert 操作,用户可以指定 key 字段,Broker 将使用该 Key 进行插入、删除和修改操作。Iceberg 对数据修改的高效支持在这里起到关键作用。

多亏了 Iceberg,这一过程非常高效。数据修改可以通过写入包含变更记录的增量文件(Delta file)来完成,而不需要重写整个表。


### **无管理开销**

为支持 Table Topic 功能,AutoMQ 引入了额外的系统组件:
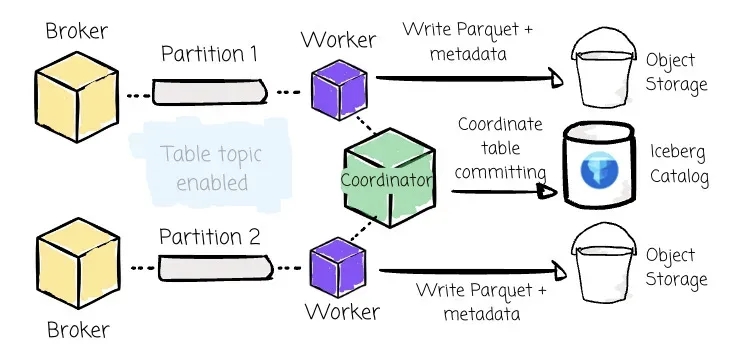
![Image](https://image.automq.com/20250728bot/d0v13p.png)


ꔷ Coordinator:负责同步进度与表提交。每个 Table Topic 的 partition 0 上绑定一个专属的 Coordinator,其职责是避免多个 Worker 独立提交带来的冲突和元数据膨胀。

ꔷ Worker:负责实际写入流程,包括将 Kafka record 转换为 Parquet 数据文件、上传至 Object Storage(如 S3)、并将元数据提交到 Iceberg catalog。当启用 Table Topic 功能时,AutoMQ 中每个 Partition 都会在同一进程中拥有一个对应的 Worker。

用户无需部署 Spark、Flink 或 Kafka Connect 作业。


### **成本效益**

通过将 Worker 与特定的 AutoMQ partition 绑定,可确保 Iceberg 表的读写操作发生在同一个可用区(AZ),从而避免跨 AZ 成本。
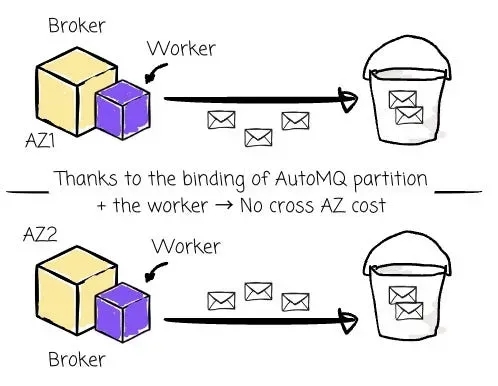
![Image](https://image.automq.com/20250728bot/c3vnxe.png)


在传统架构下,从 Kafka 消费数据并写入 Iceberg 表时,数据工程师需要同时维护 Kafka Topic 存储与 Lakehouse 数据存储这两层系统。而在 AutoMQ 中,数据转换为 Iceberg 表之后,Broker 即可同时通过 Kafka API 服务 AutoMQ 消费者,也能被分析型引擎直接读取。
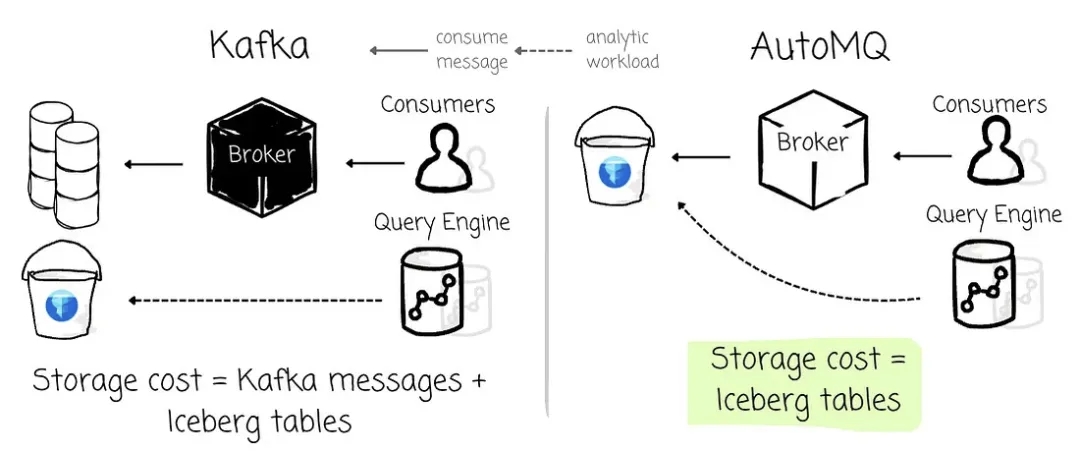
![Image](https://image.automq.com/20250728bot/dgtqqc.png)


## **结语**


本文带你回顾了 Kafka 架构的发展路径:从最初各自为战的 Shared Nothing 架构,到分层存储(Tiered Storage)、共享存储(Shared Storage),再到如今逐步落地的共享数据(Shared Data)模式。

随着数据湖和 Lakehouse 架构的兴起,像 Delta Lake、Apache Hudi,尤其是 Apache Iceberg 这样的开源表格式越来越受到青睐,让原本难以落地的湖仓分析变得可行。

Kafka 在这一过程中扮演了连接数据实时采集与分析的桥梁角色,Kafka → Iceberg 的数据流也因此成为热点话题,许多新一代 Kafka 系统都将其视为核心能力。

我们也进一步介绍了 AutoMQ 是如何提出 Shared Data 架构这一理念,以及它是如何实现将 Kafka 数据自动写入 Iceberg 表的关键技术路径。

希望这篇文章能帮你更好理解 Kafka 与 Iceberg 的融合趋势,我们下篇见!


**参考资料**


\[1\]  thanks to the evolution of modern table formats.

\[2\] Why do we need open table formats like Delta Lake or Iceberg?

\[3\] I spent 7 hours diving deep into Apache Iceberg.

\[4\] AutoMQ | Streaming from Kafka Topic to Iceberg® Table

\[5\] Jack Vanlightly, Tableflow: the stream/table, Kafka/Iceberg duality (2024)


Python 使用Pygame库实现足球游戏:创建一个球员和一个足球,并使玩家能够控制球员的移动。游戏将包括碰撞检测、简单的物理模拟,以及基本的用户输入处理 本文将介绍如何使用Python和Pygame库创建一个简单的足球游戏。我们将搭建一个基本的游戏环境,创建一个球员和一个足球,并使玩家能够控制球员的移动。游戏将包括碰撞检测、简单的物理模拟,以及基本的用户输入处理。这个简单的足球游戏展示了Pygame的一些基本功能。虽然这是一个简单的游戏,但它包含了创建游戏循环、用户输入处理、物理模拟、碰撞检测等重要概念。 阅读详情

相关推荐

ESD放电路径分析

当金属外壳接地情况下,大部分外部干扰信号将会通过外壳,外壳到接地点,再由接地点回到干扰信号的地,实现干扰信号的回流,这点不仅仅适用于​ESD,对于其他的RI类干扰,也同样适合。发现内部金属板跟外壳的搭接处存在较多的缝隙点,该缝隙点对于频率较高的信号能够实现较为理想的回流,但是对于频率没有那么高的信号,则较难以实现回流,我们尝试将这些缝隙用铜箔包裹住,充分降低该金属板跟外壳的接触阻抗​。我们分析,路径3其实是不期望的路径,我们最期望的路径是1,或者2的内部金属部件跟外壳良好接触情况下的路径。

domen_pan的博客 2228

Spark作为ETL工具与SequoiaDB的结合应用

一、前言 ETL一词较常用于数据仓库,但其对象并不仅限于数据仓库。ETL是指将数据从源系统中经过抽取(Extract)、转换(Transform)、加载(Load)到目标数据存储区的过程。常见的ETL工具有Oracle Data Integrator、Informatica PowerCenter、DataStage、Kettle、Dat...

weixin_33976072的博客 251

Android双目摄像头(RGB+IR)实时预览与人脸活体检测实战指南

本文详细介绍了Android双目摄像头(RGB+IR)实时预览与人脸活体检测的实战指南。通过双摄同步预览、人脸检测与活体判断等技术实现,提升安全认证的准确性和鲁棒性。文章还提供了开发环境搭建、常见问题解决方案及性能优化建议,帮助开发者快速掌握双目摄像头在Android平台的应用。

vulkan6gpu的博客 699

使用Spark集群进行ETL的架构介绍

什么是ETL:ETL(extract提取、transform转换、load加载)。ETL负责将分散的、异构数据源中的数据如关系数据、平面数据文件等抽取到临时中间层后,进行清洗、转换、集成,最后加载到数据仓库或数据集市中,成为联机分析处理、数据挖掘提供决策支持的数据。使用Spark开发ETL系统的优势:1、由于海量的日志记录、交易记录,单机进行ETL变得越来越困难。搭建一套具备大规模数据处理能力的E

Forever-守望 2万+

LangChain学习及应用(超详细)

Model I/O 部分是与语言模型进行交互的核心组件,包括输入提示(Prompt Template)、调用模型(Model)、输出解析(Output Parser)。简单来说,就是输入、处理、输出这三个步骤。LLM 因其具有海量参数,需要花费相当的物力与时间成本进行预训练和微调,同时商用 LLM 还需要进行各种安全测试与风险评估等。因此 LLM 会存在知识滞后的问题。在专有领域,LLM 无法学习到所有的专业知识细节,因此在面向专业领域知识的提问时,无法给出可靠准确的回答。

weixin_39764056的博客 4257

containerd镜像加速配置全解析:从host.toml到config.toml的演进与实践

本文全面解析了containerd镜像加速的配置方法,重点对比了传统的config.toml集中式配置与现代的host.toml模块化配置的演进与优劣。文章通过实战演示,详细指导如何为docker.io、registry.k8s.io等常见仓库配置host.toml加速,并提供了生产环境下的最佳实践、故障排查与性能优化建议,帮助用户显著提升镜像拉取效率与系统稳定性。

jenkins8butler的博客 698

消费回调固定 return nil:错误传播与 Kafka 位点提交的区别

Mongo 写入失败时处理器记录错误但不 Mark,外层回调仍返回 nil;返回值与 Kafka 位点提交是不同动作。失败消息是否重投或被后续位点越过,需要结合分区水位分析。

2501_92769340的博客 168

ArcGIS Pro MCP 开源:自然语言驱动的 AI 制图与分析

人工智能与大模型的快速发展,正推动专业软件从“手动操作”走向“自然语言控制”。模型上下文协议(MCP)作为连接 AI 与外部工具的标准接口,类似为 AI 安装的“USB 接口”,让大模型可以通过统一协议调用 GIS 软件能力。基于 ArcPy 构建的 ArcGIS Pro MCP 项目,将复杂的地图制图与空间分析封装为 112 个可被 AI 调用的工具,使文本指令直接驱动软件完成数据加载、符号化、出图乃至叠加统计等任务。对 GIS 工程师、数据分析师与测绘规划从业者而言,该开源项目显著降低专业软件使用门槛,

weixin_29054195的博客 276

Kafka 如何实现顺序消费?

Kafka仅保证分区内消息有序,不支持全局有序。实现顺序的关键是:生产端通过相同Key确保消息进入同一分区(配合幂等生产者防重试乱序),消费端保证分区独占且按Key路由至内存队列,由单线程串行处理。吞吐提升可按Key拆分队列并行处理,避免并行导致乱序。核心口诀:同Key同分区,同分区同线程。

207

医疗AI多智能体资源调度:用Python构建高性能MCU资源池

本文介绍了医疗AI服务平台中多智能体资源争用问题的解决方案。作者设计了一个基于MCU(多点控制单元)理念的中央资源调度器,通过三层架构(资源抽象层、调度策略层、执行控制层)实现对GPU、API、数据库等医疗资源的统一管理。系统采用增强版信号量机制处理可计数并发资源,优化令牌桶算法管理速率资源,并支持急诊优先、配额限制、审计合规等医疗场景特殊需求。核心代码提供了带优先级抢占的并发控制和医疗专用令牌桶实现,可有效解决多智能体资源争用导致的优先级混乱、资源利用不均等问题。

AllenLV的博客 3219

Python爬虫实战:社交媒体热点事件追踪与情感分析可视化

本文探讨了如何利用Python爬虫技术从微博和Twitter等社交媒体平台抓取数据,进行热点事件追踪和情感分析,并通过可视化方式展示舆论情感变化。文章详细介绍了最新的爬虫技术、数据处理方法和可视化实现,提供了完整的代码示例,帮助读者构建自己的社交媒体分析系统。关键词:Python爬虫、社交媒体分析、情感分析、数据可视化、热点追踪爬虫框架:Requests-HTML、aiohttp、Twint(Twitter专用)数据处理文本处理:Jieba(中文分词)、NLTK(英文处理)情感分析。

2201_76125261的博客 1105

第十二篇:《完整实战:订单事件驱动系统(Kafka + 消费者 + 死信队列)》

这篇按一条完整的订单链路来搭:订单服务写库 + 发事件,库存服务消费并扣减,失败走指数退避重试,重试耗尽后进入死信队列,消费端全程幂等去重。Outbox 的 relay 是至少一次,DLQ 的重试也是至少一次。重试消费组的 Lag 速率:order-events.retry 的消费 lag 如果持续增长且不回落,说明重试没有收敛,可能正在走向“重试爆炸”的早期形态。retries=MAX_VALUE 配合幂等生产者,解决的是生产者重试导致的 Broker 端重复,不解决消费端业务重复——后者是下一节的事。

qq_45239623的博客 393

【测开求职】面试题:数据结构 吐血整理

本篇文章是笔者为准备研究生复试以及校招而写,因此主要针对问答,注重理解,而不在于细节计算。涵盖考研范围内的所有知识内容,读者可以先查看上面的链接走一遍数据结构的整体框架结构。其中,重点难点以及易混淆的知识点,笔者用其他近30篇文章进行了详述,在知识点处贴好了链接,有需要的可以查阅。

vector的博客 7065

Flink 连接器选型实战:HDFS、Kafka、MySQL 与 Doris 的分层数据架构

连接器选型不是技术炫技,而是对数据特征的准确判断。HDFS承担离线归档与批处理,靠分区和滚动策略控制文件质量。Kafka是实时链路的中枢,靠分区、攒批和事务保证吞吐与一致性。MySQL只做维表和小结果集,靠缓存和限流保护在线库。Doris承接大数据量分析写入,靠分桶、攒批和两阶段提交保证性能与准确。把这四者按数据规模、延迟要求和一致性要求分层组合,就能搭出一套既稳定又可扩展的 Flink 数据架构。

2401_83857914的博客 805

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

Kafka 的存储也能进对象存储:用 AutoMQ 把日志流写进 RustFS

Kafka 的痛点是存储和 broker 绑死在一起。topic 一多、留存一久,broker 本地盘就被日志段塞满,扩容不是加 broker 就是换更大的盘,数据还得在节点间搬来搬去。更麻烦的是 broker 一旦挂了,恢复全靠副本在别的节点重建,磁盘 IO 先爆一轮。AutoMQ 是 Kafka 的一个云原生发行版,思路是把存储和 broker 彻底解耦:预写日志先在本地缓冲,随后作为不可变…

分布式存储与RustFS的博客 322

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

通过 Docker 快速搭建 Kafka 开发测试环境

本文介绍通过Docker快速搭建Kafka开发测试环境的两种模式:无认证PLAINTEXT与SCRAM认证SASL_PLAINTEXT。首先生成KRaft集群ID,配置数据目录并使用docker-compose启动单机Broker。在无认证模式下初始化后,创建SCRAM用户;随后通过修改监听器协议、JAAS配置及客户端认证文件,切换至SASL认证模式。利用持久化数据卷,凭据可跨重启保留。适用于开发调试,生产环境需增强安全配置。

333

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

kafka指定分区消费

【代码】kafka指定分区消费。

hy_208的博客 68

第八篇:《Kafka Connect 与 Kafka Streams:数据集成与流处理的两种路径》

还有 exactly.once.source.support 只覆盖 Source 侧的精确一次,Sink 侧的重复仍然要靠目标系统的幂等或 DLQ 兜底——这和第七篇的结论完全一致:框架不解决语义正确性,只解决工程效率。KRaft 和 EOS 让 Kafka 内部更可靠,但 Connect 和 Streams 的分工不会因此模糊:Connect 把数据搬进来搬出去,Streams 在 Kafka 内部算,算到边界之外仍然要自己兜底一致性。判断标准只有一句话:你是在“搬数据”,还是在“算数据”。

qq_45239623的博客 364

【Kafka 从入门到实战】从手写一个队列到生产级消息中间件:架构、分区、消费组、零拷贝全解析

本文从队列基础出发,层层解析Kafka架构与设计精髓,涵盖消息队列本质、核心术语、分区机制、生产者消费者模型及四大性能优化原理:顺序写入、批量压缩、页缓存、零拷贝。附完整可运行Python代码(建Topic、生产/消费),并总结12道高频面试题与踩坑记录,帮助读者真正理解Kafka“为何快”,而非仅背“零拷贝”一词。

wiwiwiwiooo的博客 336

只 Mark 最后一条:Kafka 跨分区消费水位的风险

历史快照中两个分区重启后 lag 为 1;当前批次回调只 Mark 最后一条,可能漏记其他分区的进度,但快照不足以证明永久停滞或唯一根因。

2501_92769340的博客 183

第九篇:《Kafka 监控与运维:Lag、Under-replicated Partition 与磁盘管理》

标签:Kafka | 监控 | Consumer Lag | Under-replicated Partition | 磁盘管理 | 运维 | SRE适合人群:负责 Kafka 集群稳定性的 SRE、后端开发,被“告警响了但不知道要不要起床”折磨过的同学阅读收益:搞清楚 Lag 告警为什么用绝对值会双向失效、URP 为什么不能一看到就重启、磁盘管理为什么“百分比告警”是错的,以及三条可以直接抄的运维规则前言:凌晨两点的两个告警,一个误报,一个差点搞出大事故先说两个真实场景。

qq_45239623的博客 444

第十篇:《Kafka 安全加固:SASL、SSL、ACL 与多租户隔离》

allow.everyone.if.no.acl.found 的生产语义必须理解清楚:默认 false 是安全的选择——如果一个资源没有任何 ACL,除了超级用户,谁都无权访问。最关键、也最容易被误解的语义是:配额是按 Broker 强制的,不是按集群强制的。另一个静默坑是后缀与格式不匹配:给 PKCS12 格式的密钥库文件用了 .jks 后缀,部分 Spring Boot 版本的 SSL 类型自动探测会按 JKS 格式加载,失败后直接返回空密钥库,启动时不抛异常,只在握手时表现为没有证书。

qq_45239623的博客 309

Kafka 消费者每 5 分钟触发一次 Rebalance,把 max.poll.interval.ms 调大仍然掉线

消费者加入消费组后每约 5 分钟被踢出一次。文中命令与代码块可直接复制执行,未实测的结论均已单独标注。文中给出了可复现的环境与操作步骤,并标注了哪些结论已经验证、哪些仍属推测。

昨日种种,皆成今我。今日种种,皆成新我。 181

第二篇:《CommitLog + ConsumeQueue:一条日志解决 Kafka 多分区随机写的难题》

RocketMQ 采用 CommitLog 全局顺序写 + ConsumeQueue 索引的存储模型,解决 Kafka 多 Topic 场景下跨 Partition 随机写问题。CommitLog 存所有消息,保证写入顺序;ConsumeQueue 为每 Topic+Queue 的 20 字节索引(偏移量、长度、Tag 哈希),支持消费者“读两次”定位消息。虽有读放大与异步重建代价,但通过顺序写与 mmap 零拷贝实现高性能,本质是用索引换写入可扩展性。

qq_45239623的博客 246

极致工程之美:Kafka 时间轮与 LevelDB LSM-Tree 的架构同构赏析

Kafka分层时间轮与LevelDB LSM-Tree虽服务于不同场景,却共享同一设计哲学:在高吞吐与有限资源的困境中,以幂次分层、局部吸收与级联下沉破局。二者均通过指数级扩张的层级结构,将高频操作限制于浅层,低频归并沉淀于深层,实现时间与空间维度的高效调度。其核心思想在于:允许局部无序以换取全局稳定,借由降频级联重构秩序,体现了系统工程中“以退为进”的极致优雅。

weixin_42418361的博客 192

消息队列入门:RabbitMQ 与 Kafka 核心概念与运维要点

BIOS→GRUB→内核→systemd→target 全链路解读,root 密码忘了解锁、文件系统损坏修复、单用户模式与救援模式实战,服务器起不来时的救命指南。

2502_91473995的博客 380
上一篇: AutoMQ 与 Lightstreamer 达成战略合作:NASA也在用的 Kafka 数据实时分享新架构
下一篇: AutoMQ × CloudCanal:打造秒级响应的实时数据架构!
AutoMQ
博客等级 码龄3年 1206粉丝 157原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值