ASCII,Unicode 和 UTF-8

字符编码(十六进制) 假设一个简易的变长编码规则XUTF:每个字符有一个唯一编号值 unicodeVal(如汉字“华”的编号十进制值是21326),使用1~6个字节进行编码,编码规则如下:编码过程:参考编号值范围,根据 unicodeVal 值判断需要几个字节进行编码,然后依次把 unicodeVal 的二进制比特填充到二进制格式中的有效位上:右侧对齐、左侧补 0;注意:固定位不变。现给定某个字符的十进制编号值 unicodeVal,请按XUTF编码规则对该字符进行编码,输出编码后的十六进制字符串(大写)。 阅读详情

一、ASCII 码

我们知道,计算机内部,所有信息最终都是一个二进制值。每一个二进制位(bit)有0和1两种状态,因此八个二进制位就可以组合出256种状态,这被称为一个字节(byte)。也就是说,一个字节一共可以用来表示256种不同的状态,每一个状态对应一个符号,就是256个符号,从00000000到11111111。

上个世纪60年代,美国制定了一套字符编码,对英语字符与二进制位之间的关系,做了统一规定。这被称为 ASCII 码,一直沿用至今。

ASCII 码一共规定了128个字符的编码,比如空格SPACE是32(二进制00100000),大写的字母A是65(二进制01000001)。这128个符号(包括32个不能打印出来的控制符号),只占用了一个字节的后面7位,最前面的一位统一规定为0。

二、非 ASCII 编码

英语用128个符号编码就够了,但是用来表示其他语言,128个符号是不够的。比如,在法语中,字母上方有注音符号,它就无法用 ASCII 码表示。于是,一些欧洲国家就决定,利用字节中闲置的最高位编入新的符号。比如,法语中的é的编码为130(二进制10000010)。这样一来,这些欧洲国家使用的编码体系,可以表示最多256个符号。

但是,这里又出现了新的问题。不同的国家有不同的字母,因此,哪怕它们都使用256个符号的编码方式,代表的字母却不一样。比如,130在法语编码中代表了é,在希伯来语编码中却代表了字母Gimel (ג),在俄语编码中又会代表另一个符号。但是不管怎样,所有这些编码方式中,0--127表示的符号是一样的,不一样的只是128--255的这一段。

至于亚洲国家的文字,使用的符号就更多了,汉字就多达10万左右。一个字节只能表示256种符号,肯定是不够的,就必须使用多个字节表达一个符号。比如,简体中文常见的编码方式是 GB2312,使用两个字节表示一个汉字,所以理论上最多可以表示 256 x 256 = 65536 个符号。

中文编码的问题需要专文讨论,这篇笔记不涉及。这里只指出,虽然都是用多个字节表示一个符号,但是GB类的汉字编码与后文的 Unicode 和 UTF-8 是毫无关系的。

三. Unicode

正如上一节所说,世界上存在着多种编码方式,同一个二进制数字可以被解释成不同的符号。因此,要想打开一个文本文件,就必须知道它的编码方式,否则用错误的编码方式解读,就会出现乱码。为什么电子邮件常常出现乱码?就是因为发信人和收信人使用的编码方式不一样。

可以想象,如果有一种编码,将世界上所有的符号都纳入其中。每一个符号都给予一个独一无二的编码,那么乱码问题就会消失。这就是 Unicode,就像它的名字都表示的,这是一种所有符号的编码。

Unicode 当然是一个很大的集合,现在的规模可以容纳100多万个符号。每个符号的编码都不一样,比如,U+0639表示阿拉伯字母Ain,U+0041表示英语的大写字母A,U+4E25表示汉字严。具体的符号对应表,可以查询unicode.org,或者专门的汉字对应表。

四、Unicode 的问题

需要注意的是,Unicode 只是一个符号集,它只规定了符号的二进制代码,却没有规定这个二进制代码应该如何存储。

比如,汉字严的 Unicode 是十六进制数4E25,转换成二进制数足足有15位(100111000100101),也就是说,这个符号的表示至少需要2个字节。表示其他更大的符号,可能需要3个字节或者4个字节,甚至更多。

这里就有两个严重的问题,第一个问题是,如何才能区别 Unicode 和 ASCII ?计算机怎么知道三个字节表示一个符号,而不是分别表示三个符号呢?第二个问题是,我们已经知道,英文字母只用一个字节表示就够了,如果 Unicode 统一规定,每个符号用三个或四个字节表示,那么每个英文字母前都必然有二到三个字节是0,这对于存储来说是极大的浪费,文本文件的大小会因此大出二三倍,这是无法接受的。

它们造成的结果是:1)出现了 Unicode 的多种存储方式,也就是说有许多种不同的二进制格式,可以用来表示 Unicode。2)Unicode 在很长一段时间内无法推广,直到互联网的出现。

五、UTF-8

互联网的普及,强烈要求出现一种统一的编码方式。UTF-8 就是在互联网上使用最广的一种 Unicode 的实现方式。其他实现方式还包括 UTF-16(字符用两个字节或四个字节表示)和 UTF-32(字符用四个字节表示),不过在互联网上基本不用。重复一遍,这里的关系是,UTF-8 是 Unicode 的实现方式之一。

UTF-8 最大的一个特点,就是它是一种变长的编码方式。它可以使用1~4个字节表示一个符号,根据不同的符号而变化字节长度。

UTF-8 的编码规则很简单,只有二条:

1)对于单字节的符号,字节的第一位设为0,后面7位为这个符号的 Unicode 码。因此对于英语字母,UTF-8 编码和 ASCII 码是相同的。

2)对于n字节的符号(n > 1),第一个字节的前n位都设为1,第n + 1位设为0,后面字节的前两位一律设为10。剩下的没有提及的二进制位,全部为这个符号的 Unicode 码。

下表总结了编码规则,字母x表示可用编码的位。

Unicode符号范围     |        UTF-8编码方式
(十六进制)        |              (二进制)
----------------------+---------------------------------------------
0000 0000-0000 007F | 0xxxxxxx
0000 0080-0000 07FF | 110xxxxx 10xxxxxx
0000 0800-0000 FFFF | 1110xxxx 10xxxxxx 10xxxxxx
0001 0000-0010 FFFF | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx

跟据上表,解读 UTF-8 编码非常简单。如果一个字节的第一位是0,则这个字节单独就是一个字符;如果第一位是1,则连续有多少个1,就表示当前字符占用多少个字节。

下面,还是以汉字严为例,演示如何实现 UTF-8 编码。

严的 Unicode 是4E25(100111000100101),根据上表,可以发现4E25处在第三行的范围内(0000 0800 - 0000 FFFF),因此严的 UTF-8 编码需要三个字节,即格式是1110xxxx 10xxxxxx 10xxxxxx。然后,从严的最后一个二进制位开始,依次从后向前填入格式中的x,多出的位补0。这样就得到了,严的 UTF-8 编码是11100100 10111000 10100101,转换成十六进制就是E4B8A5。

六、Unicode 与 UTF-8 之间的转换

通过上一节的例子,可以看到严的 Unicode码 是4E25,UTF-8 编码是E4B8A5,两者是不一样的。它们之间的转换可以通过程序实现。

Windows平台,有一个最简单的转化方法,就是使用内置的记事本小程序notepad.exe。打开文件后,点击文件菜单中的另存为命令,会跳出一个对话框,在最底部有一个编码的下拉条。
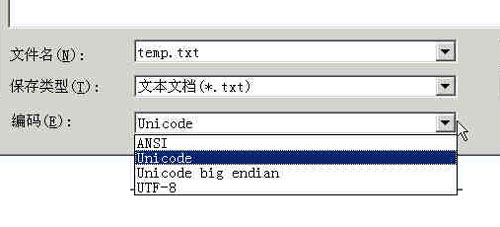
bg2007102801.jpg

里面有四个选项:ANSI,Unicode,Unicode big endian和UTF-8。

1)ANSI是默认的编码方式。对于英文文件是ASCII编码,对于简体中文文件是GB2312编码(只针对 Windows 简体中文版,如果是繁体中文版会采用 Big5 码)。

2)Unicode编码这里指的是notepad.exe使用的 UCS-2 编码方式,即直接用两个字节存入字符的 Unicode 码,这个选项用的 little endian 格式。

3)Unicode big endian编码与上一个选项相对应。我在下一节会解释 little endian 和 big endian 的涵义。

4)UTF-8编码,也就是上一节谈到的编码方法。

选择完"编码方式"后,点击"保存"按钮,文件的编码方式就立刻转换好了。

七、Little endian 和 Big endian

上一节已经提到,UCS-2 格式可以存储 Unicode 码(码点不超过0xFFFF)。以汉字严为例,Unicode 码是4E25,需要用两个字节存储,一个字节是4E,另一个字节是25。存储的时候,4E在前,25在后,这就是 Big endian 方式;25在前,4E在后,这是 Little endian 方式。

这两个古怪的名称来自英国作家斯威夫特的《格列佛游记》。在该书中,小人国里爆发了内战,战争起因是人们争论,吃鸡蛋时究竟是从大头(Big-endian)敲开还是从小头(Little-endian)敲开。为了这件事情,前后爆发了六次战争,一个皇帝送了命,另一个皇帝丢了王位。

第一个字节在前,就是"大头方式"(Big endian),第二个字节在前就是"小头方式"(Little endian)。

那么很自然的,就会出现一个问题:计算机怎么知道某一个文件到底采用哪一种方式编码?

Unicode 规范定义,每一个文件的最前面分别加入一个表示编码顺序的字符,这个字符的名字叫做"零宽度非换行空格"(zero width no-break space),用FEFF表示。这正好是两个字节,而且FF比FE大1。

如果一个文本文件的头两个字节是FE FF,就表示该文件采用大头方式;如果头两个字节是FF FE,就表示该文件采用小头方式。

八、实例

下面,举一个实例。

打开"记事本"程序notepad.exe,新建一个文本文件,内容就是一个严字,依次采用ANSI,Unicode,Unicode big endian和UTF-8编码方式保存。

然后,用文本编辑软件UltraEdit 中的"十六进制功能",观察该文件的内部编码方式。

1)ANSI:文件的编码就是两个字节D1 CF,这正是严的 GB2312 编码,这也暗示 GB2312 是采用大头方式存储的。

2)Unicode:编码是四个字节FF FE 25 4E,其中FF FE表明是小头方式存储,真正的编码是4E25。

3)Unicode big endian:编码是四个字节FE FF 4E 25,其中FE FF表明是大头方式存储。

4)UTF-8:编码是六个字节EF BB BF E4 B8 A5,前三个字节EF BB BF表示这是UTF-8编码,后三个E4B8A5就是严的具体编码,它的存储顺序与编码顺序是一致的。

字符编码:ASCII,GBK,Unicode 和 UTF-8 文章目录前言一、ASCII 码二、非 ASCII 编码三、GBK四、UnicodeUnicode 的问题五、UTF-8 前言 大家写程序时肯定有被编码问题困扰过,稍不注意,程序输出就可能是一堆乱码,目前世界上有 UTF-8、GBK、Unicode 等等编码方式,但你真的了解其中的原理吗? 一、ASCII 码 我们知道,计算机内部,所有信息最终都是一个二进制值。每一个二进制位(bit)有0和1两种状态,因此八个二进制位就可以组合出256种状态,这被称为一个字节(byte)。也就是说,一个字节一共可以用来表示 阅读详情

相关推荐

从 PFCG 角色维护看 SAP 授权治理,角色、菜单、授权 profile 和用户主记录到底怎么配合

SAP ABAP权限治理的核心:从业务职责出发的角色设计 在SAP系统中,权限治理的关键在于角色设计是否贴合组织分工,而非单纯分配事务码。通过PFCG工具,管理员可以基于岗位职责(如财务月结、采购审批等)构建角色,将业务活动、菜单入口和授权数据串联成可维护的链路,而非直接操作底层授权对象。 关键要点: 角色是职责的映射:角色不仅包含事务码,还需关联授权对象,确保用户既能访问功能,又受权限约束。 PFCG的层级优势:PFCG在高于底层对象的层级工作,自动生成授权建议,但需人工校验关键字段(如组织级别、ACTV

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 2095

【非数值数据的编码】西文字符和汉字的编码表示 汉字国标码、机内码详细理解

西文字符和汉字的编码表示西文字符概念ASCII码表特点西文字符特点西文字符表示(常用编码为7位ASCII码)西文字符操作汉字字符编码形式输入码字符集与汉字内码 西文字符 概念 西文字符由拉丁字母、数字、标点符号及一些特殊符号组成,称为“字符” 所有字符组成的集合称为“字符集” 字符不能在计算机中直接处理,需要对其进行数字化编码,字符集中每个字符都有一个编码(二进制0/1序列) 由字符二进制编码构成的字符集称为“码表” 字符集有很多种,每个字符集的编码方式也是多种多样,目前最广泛的字符集及其编码时ASCI

这道题我不会做...不会做啊..太难了!! 1万+

在ubuntu20.04上配置VINS_Fusion(亲测有效,一应俱全)

最近在做科研训练的时候配置了HKUST-Aerial-Robotics实验室的VINS_Fusion代码项目,经历了一些编译报错的问题,在网上查找的时候博客内容良莠不齐,且实质针对性意见不多,于是在此记录下自己配置期间遇到的一些共性问题,留作自己日后参考和大家的交流学习。

wyr1849089774的博客 8265

十六进制编码简介

十六进制是一个以16为基数的计数系统,这意味着每个数字代表16个不同的数字,而不是以10为基数的系统中的10个数字。系统通常用数字0-9表示前10位,然后用字母A-F表示后6位。它不是一种历史上的计数系统,但它起源于电子时代,因为它是一种对二进制系统相当友好的扩展方式。...

AI的博客 6144

SAP各模块表清单及逻辑关系介绍

分享韩国同行总结的各模块的表清单及逻辑关系,这对ABAP顾问和各模块业务顾问应该非常有用的 物料主数据 SD与MM PS模块 PP模块 QM模块 CO模块 FI模块

weixin_40672823的博客 9599

Open5GS实战:从零搭建树莓派5G核心网并与商用终端联调

本文详细介绍了如何在树莓派5上从零开始搭建基于Open5GS的5G核心网,涵盖系统准备、依赖安装、源码编译、关键配置修改及服务启动全流程。通过整合SDR基站与商用终端进行端到端联调,为开发者和研究者提供了一个低成本、可实践的5G网络实验平台,助力物联网与边缘计算应用的本地化测试与验证。

weixin_29194255的博客 157

Hex编码(也称为十六进制编码)是一种将数据转换为十六进制表示形式的编码方法

与Base64编码不同,Hex编码使用16个字符来表示数据,这16个字符分别是0-9的数字和A-F的字母(不区分大小写,即a-f和A-F是等价的)。需要注意的是,Hex编码和解码是可逆的,即可以通过编码将原始数据转换为Hex字符串,也可以通过解码将Hex字符串转换回原始数据,且不损失任何信息。ASCII主要用于文本字符的表示和交换,而Hex编码则更适用于二进制数据的表示和处理。ASCII主要用于文本字符的表示和交换,而Hex编码则更适用于二进制数据的表示和处理。它只是一种表示数据的方式,不改变数据的本质。

[Blog][Domain] programb.blog.youkuaiyun.com 8521

零基础学习CANoe Panel(5)——改变变量的值,控件图像也改变,这是怎么回事?

Panel 中控件的图像随着值变化,是怎么回事?

蚂蚁小兵 2144

ASCII和Unicode和Utf-8

是一种广泛使用的字符编码方式,它能够表示几乎所有语言的字符。UTF-8 是一种可变长度的编码方式,每个字符的编码长度可以从 1 到 4 字节不等,具体取决于字符的 Unicode 值。Unicode 是 ASCII 的超集,ASCII 字符集中的字符在 Unicode 中有相同的编码值,因此可以通过 Unicode 兼容 ASCII。,包括汉字、日文、阿拉伯文等各种符号,目的是消除不同编码方式(如 ASCII、GBK、ISO-8859 等)之间的兼容性问题。ASCII 仅能表示。

mx_2022的博客 2000

学习STM32的DS18B20温度传感器

该函数首先复位传感器,然后发送跳过ROM命令和转换命令,并等待转换完成。接下来,它再次复位传感器,发送跳过ROM命令和读取温度命令。最后,它读取温度值的最低字节和最高字节,并将其组合成16位温度值。传感器的VCC引脚连接到STM32的3.3V电源,GND引脚连接到GND,而数据引脚连接到任何一个IO引脚。需要注意的是,示例代码中使用了一个简单的延时函数来等待转换完成。实际上,您可能需要使用定时器或其他更精确的延时方法来实现更准确的延时。下面是一个示例代码,演示如何读取DS18B20传感器的温度值。

m0_75244442的博客 1182

【VS Code插件开发】通用功能(二)

本篇主要从command(命令)、menus(菜单)、快捷键三个方面讲解,都归于通用功能。

编码世界 1万+

关于ASCII,Unicode 和 UTF-8你看了这篇文章就懂了

专栏【Python - 100天从新手到大师】 前言 平时看的文章挺多的,但是关于ASCII,Unicode 和 UTF-8一直不是很懂。今天上午,我突然想搞清楚 Unicode 和 UTF-8 之间的关系,就开始查资料。这个问题比我想象的复杂,看了这篇文章才算初步搞清楚。字符编码是计算机技术的基石,想要熟练使用计算机,就必须懂得一点字符编码的知识,所以有了这个文章。 1、ASCII码 我们知道,...

种树最好的时间是10年前,其次是现在!!! 3566

2024 年 9 月青少年软编等考 C 语言三级真题解析

2024 年 9 月青少年软编等考 C 语言三级真题解析。

发布少儿编程考级的真题和优秀竞赛题解析,以及一些讲义。 1737

ASCII,Unicode 和 UTF-8的区别

ASCII,Unicode 和 UTF-8的区别

拾年一剑 的专栏 1346

R语言做一个 GM (1,1)灰色预测模型

累加生成是GM(1,1)模型的另一个重要步骤,它通过构造累加生成序列,把非线性非平稳时间序列转化为线性平稳时间序列。GM(1,1)是一种基于灰色系统理论的预测模型,通常用于中小样本的非线性、非平稳时间序列数据分析。灰色预测模型的核心是灰度处理,将原始时间序列转化为灰色时间序列。这里使用R语言中的diff函数对时间序列进行一次差分,然后对结果取累加和得到灰度序列。以上是GM(1,1)灰色预测模型在R语言中的实现步骤。需要注意的是,GM(1,1)模型适用于中小样本的时间序列预测,对于长期预测效果可能较差。

Mrrunsen的博客 3841

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

ASCII码、Unicode和UTF-8之间的转换

ASCII码:是指单字节字符集; Unicode:本文特指按Big Endian存储的字符集; UTF-8:一种变长的编码字符集。它可以使用1~6个字节表示一个符号, 根据不同的符号而变化字节长度。 UTF-8的编码规则如下: 1)对于单字节的符号, 字节的第一位设为0, 后面7位为这个符号的unicode码. 因此对于英语字母, UTF-8编码和ASCII码是相同的。 2)对于n字节的符号(n>1), 第一个字节的前n位都设为1, 第n+1位设为0, 后面字节的前两位一律设为10. 剩下的..

Santa_q的专栏 6316

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

ASCII,Unicode,UTF-8 和 GBK

转自http://www.ruanyifeng.com/blog/2007/10/ascii_unicode_and_utf-8.html。 如果我也有想阮一峰一样的探究总结能力,一定会变得越来越好。 简单来说,Unicode是最全的编码方式,囊括世界上所有的符号。 UTF-8 是 Unicode 的实现方式之一,它主要采用了变长存储的方式解决了Unicode 存储空间过大问题。 ASCI...

热勇的博客 305

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

ASCII,Unicode和UTF-8

来源:ruanyifeng.com 作者:阮一峰 看完了才发现是峰哥写的,怪不得这么经典!!! 原文地址:https://www.linuxidc.com/Linux/2015-07/119738.htm 字符编码笔记:ASCII,Unicode和UTF-8 [日期:2015-07-11] 来源:ruanyifeng.com 作者:阮一峰 [字体:大中小] 我突然想...

mab2hf的博客 179

ASCII、Unicode和UTF-8区别说明

由于计算机是美国人发明的,因此,最早只有127个字符被编码到计算机里,也就是大小写英文字母、数字和一些符号,这个编码表被称为ASCII编码,比如大写字母A的编码是65,小写字母z的编码是122。由于计算机是美国人发明的,因此,最早只有127个字符被编码到计算机里,也就是大小写英文字母、数字和一些符号,这个编码表被称为ASCII编码,比如大写字母A的编码是65,小写字母z的编码是122。现在,捋一捋ASCII编码和Unicode编码的区别:ASCII编码是1个字节,而Unicode编码通常是2个字节。

tanqili的博客 759

ASCII、Unicode、UTF-8 和 Base64 等编码

ASCII码 我们知道,在计算机内部,所有的信息最终都表示为一个二进制的字符串。每一个二进制位(bit)有0和1两种状态,因此八个二进制位就可以组合出256种状态(-128~127),这被称为一个字节(byte)。也就是说,一个字节一共可以用来表示256种不同的状态,每一个状态对应一个符号,就是256个符号,从0000000到11111111。 上个世纪60年代,美国制定了一套字符编码,对英语字符与二进制位之间的关系,做了统一规定。这被称为ASCII码,一直沿用至今。 ASCII码一共规定了128个字符.

weixin_42291794的博客 1320

ASCII、Unicode和UTF-8、UTF-16、UTF-32的关系

ASCII码 ASCII码表 计算机中任何信息都是用0和1来表示的。但是现实世界各种信息如图像、视频、音频、语言文字却不是用0和1表示的。为了计算机能够更加智能,我们需要让计算机能够识别人类世界的信息,所以我们需要将图像、视频、音频、语言文字等信息转换成二进制(0和1)存储到计算机中,这一过程也称之为编码。 编码是信息从一种形式或格式转换为另一种形式的过程。 如果只有一位二进制,那么可以代表两种情况,即2^1=2,可能是0或1。 如果有两位二进制,那么就可以代表四种情况,即2^2=4,可能是00、

二木成林 1966

Unicode、ASCII、UTF-8编码关系和底层原理

Unicode是一个字符集标准,ASCII则是Unicode的一个子集,包含最基本的字符,而UTF-8、UTF-16和UTF-32是实现Unicode这个标准的不同编码方式,UTF-8的底层原理参考上面我推荐的文章,我这里就不做详细的解释了。

Happy learning and coding journey! 2554

ASCII,Unicode 和 UTF-8

Unicode 和 UTF-8 之间的关系?

weixin_47450807的博客 695

ANSI和ASCII、GBK和GB2312、Unicode和UTF-8的区别

ANSI和ASCII区别 NSI码(American National Standards Institute) 美国国家标准学会的标准码 ASCII码(America Standard Code for Information Interchange)美国信息交换标准码 是基于拉丁字母的一套电脑编码系统,主要用于显示现代英语和其他西欧语言。它是现今最通用的单字节编码系统,并等同于国际标准...

在路上 2975
上一篇: 非对称加密算法--RSA加密原理
下一篇: 谈谈MVC模式
ArtisticProgramming
博客等级 码龄8年 1粉丝 6原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值