RAG知识库要被淘汰了?

从仓库到厨房:AI知识库搭建实战与运维指南 检索增强生成(RAG)是企业构建AI知识库的核心技术,其价值并不在于存储多少文档,而在于如何从海量信息中精准检索并生成可靠答案。理解RAG的完整流程——文档解析、语义分块、向量存储、检索重排序、提示词设计——是提升知识库效果的关键。实践中,许多知识库沦为“资料库”,导致AI回答偏离预期,根本原因在于缺乏对内容清洗、结构化处理与持续运营的重视。本文以厨房烹饪为类比,拆解知识库从搭建到运营的每一个环节,涵盖内容准入、解析切分、索引设计、召回优化、监测反馈等工程细节,并总结常见“翻车”场景与补救方案,帮助读者避开 阅读详情

最近"RAG已死"的论调又炸了!

说什么大模型上下文都到10M了还有Karpathy刚出的LLM WikiRAG可以直接扔垃圾桶了…

作为每天和AI检索打交道的工程师

今天说句大实话:

传统RAG确实在快速淘汰,但RAG的思想没死

而且市面上已经冒出了6个能打的替代方

案

看完这篇,你就知道2026年该怎么选了先搞懂:为什么大家都在说RAG不行了?

传统NaiveRAG(切块一向量化一检索拼接)的3大绝症:

  • 语义漂移:搜出来的东西经常不相关
  • 无法推理:只能找事实,不能做复杂关联
  • 维护麻烦:数据更新要重新嵌入,成本高

再加上大模型上下文窗口爆炸式增长。

和各种新检索技术的出现传统RAG确实已经跟不上时代了

2026年6大RAG替代方案,谁最能打?

一,LLM Wiki(Karpathy最新神作)

🔥核心:一次编译,永久复用

  1. 把原始文档提前编译成结构化的"知识维基"

  2. 不用每次查询都重新检索和推导

  3. 速度比传统RAG快10倍,成本低90%

⭕适合:静态知识库、公司内部文档

❌不适合:实时数据、频繁更新的内容

二,Graph RAG(微软主推)

🔥核心:从"搜文本“变成"搜关系"

  1. 把文档建成知识图谱,支持多跳推理

  2. 能回答"CEO的母校的校友创办了哪些公司"这种复杂问题

  3. 准确率比传统RAG高40%以上

⭕适合:法律、金融、医疗等需要深度推理的场景

❌不适合:简单问答、小体量知识库

三,Agentic RAG(智能体检索)3

核心:检索变成智能体的一个行动

  • 自动拆解问题、多轮检索、自我验证-会自己判断"这个问题要不要检索"
  • 复杂任务准确率能到99.5%

⭕适合:企业级Copilot、复杂数据分析

❌不适合:简单查询(成本太高)

四,RIG(Google最新)

🔥核心:检索和生成交错进行

  • 不是先搜完再生成,而是边生成边检索
  • 生成到一半发现缺信息,自动去补
  • 解决了长上下文遗忘的问题

⭕适合:长文档写作、研究报告生成

❌不适合:实时性要求极高的场景

五,MSA内存稀疏注意力

🔥核心:直接把大模型的"大脑"升级

  • 突破1亿tokens上下文,准确率几乎不下降
  • 不需要外接数据库,知识直接存在模型里
  • 真正实现了"过目不忘"

⭕适合:超大文档库、一次性导入的知识

❌不适合:需要频繁更新的内容

六,文件系统+grep(返璞归真)

🔥核心:用最简单的方式解决问题

  • 智能体像人类一样操作文件系统
  • 用ls、cd、cat、grep命令找信息
  • 零向量数据库、零嵌入模型,部署成本为0

⭕适合:小团队、快速原型、代码库检索

❌不适合:超大规模知识库

最后给大家一个清晰的决策框架

文档<100页,不常更新–直接用长上下文模型

100-10000页,静态知识–LLMWiki

需要复杂推理–>GraphRAG

企业级应用,需要自主决策–Agentic RAG

小团队快速上线–文件系统+grep

实时数据、动态内容–>还是得用RAG(但要升级到混合检索)

🎁一句话总结

淘汰的是"傻白甜"的传统RAG,不是RAG本身

现在的检索技术已经进化成了一个庞大的家族

没有最好的,只有最适合你的那些喊"RAG已死"的

要么是不懂技术,要么是想卖你新东西

别被带节奏了,选对技术才是王道

2026 技术圈彻底洗牌!传统岗位不断缩减,吃透 AI 大模型,手握高薪入场券

步入 2026,技术行业两极分化已经成为常态。

后端 CRUD、前端页面开发、软件测试、常规运维这类传统岗位持续缩招,降薪、人员优化早已变成家常便饭。不少深耕多年的技术兄弟陷入深深的职业焦虑,害怕年龄上涨之后,被低成本 AI 代码工具替代。

反观 AI 大模型赛道,各大企业正在疯狂招人。落地型大模型开发岗位薪资一路暴涨,头部大厂常年放出 70‑100W 年薪招揽实干人才。如今企业不再死板卡死年纪门槛,比起只会背诵理论的人,更渴求可以落地项目、解决企业业务难题的实战人才。

大批程序员、应届生、转行新人扎堆钻研大模型,并不是盲目跟风凑热闹,而是看清当下最实在的职业红利,这便是 2026 年普通人最该抓住的风口机遇。

- 转型窗口期充足,硬性门槛放宽

如今普通软件开发赛道内卷严重,学历、年纪、项目履历层层筛人。但眼下落地向的大模型人才缺口庞大,只要你掌握基础大模型开发、拥有完整实操项目,便能够投递岗位。零基础小白可以稳步入门,各类方向的开发从业者都能够顺利完成赛道跳转。

- 原有技术储备能够直接复用,不用从零起步

如果你做过后端接口、前端开发、数据库调试、数据分析、脚本编写,那么你上手提示词工程、知识库搭建、模型私有化部署、Agent 编排都会十分顺畅。不必耗费大量精力啃晦涩的深度学习底层,盘活现有的编程功底就能够快速进阶。

- 技术叠加行业业务,拉开薪资差距

现如今单纯会敲代码已经很难拉开竞争力。2026 年各大公司争抢的都是技术加业务的复合型人才。拥有金融、工业、政务、电商行业经验,可以排查模型落地 BUG、适配业务痛点的从业者,薪资待遇高出普通开发岗位三成往上。

就算你现阶段没有跳槽的打算,熟练使用大模型工具减负日常工作,已经成为绝大多数公司的硬性标准。不会借助 AI 简化重复工作,往后很容易被同行拉开差距,慢慢遭到行业淘汰。

2026 小白和在岗程序员该怎样系统学好 AI 大模型?

很多兄弟有心踏入大模型赛道,却总是卡在自学难题上面。

一部分人四处搜集零散网课、碎片化文档,知识结构杂乱无章,越学越迷茫;还有不少人冲动入手高价培训课程,花费不菲,学到的仅有演示 Demo,缺少企业级落地项目,白白浪费宝贵时间不停踩坑。

我这边整理好了一套适配 2026 行业招聘标准、免费且体系完整的 AI 大模型全套学习资源包。覆盖零基础入门、工程实战、底层原理深耕、大厂面试备考整条链路,所有资料已经规整完毕,不需要你到处搜集拼凑,拿到之后直接开启学习,小白循序渐进,老程序员专攻高阶内容实现薪资跃迁。
请添加图片描述

👇👇扫码免费领取全部内容👇👇
请添加图片描述

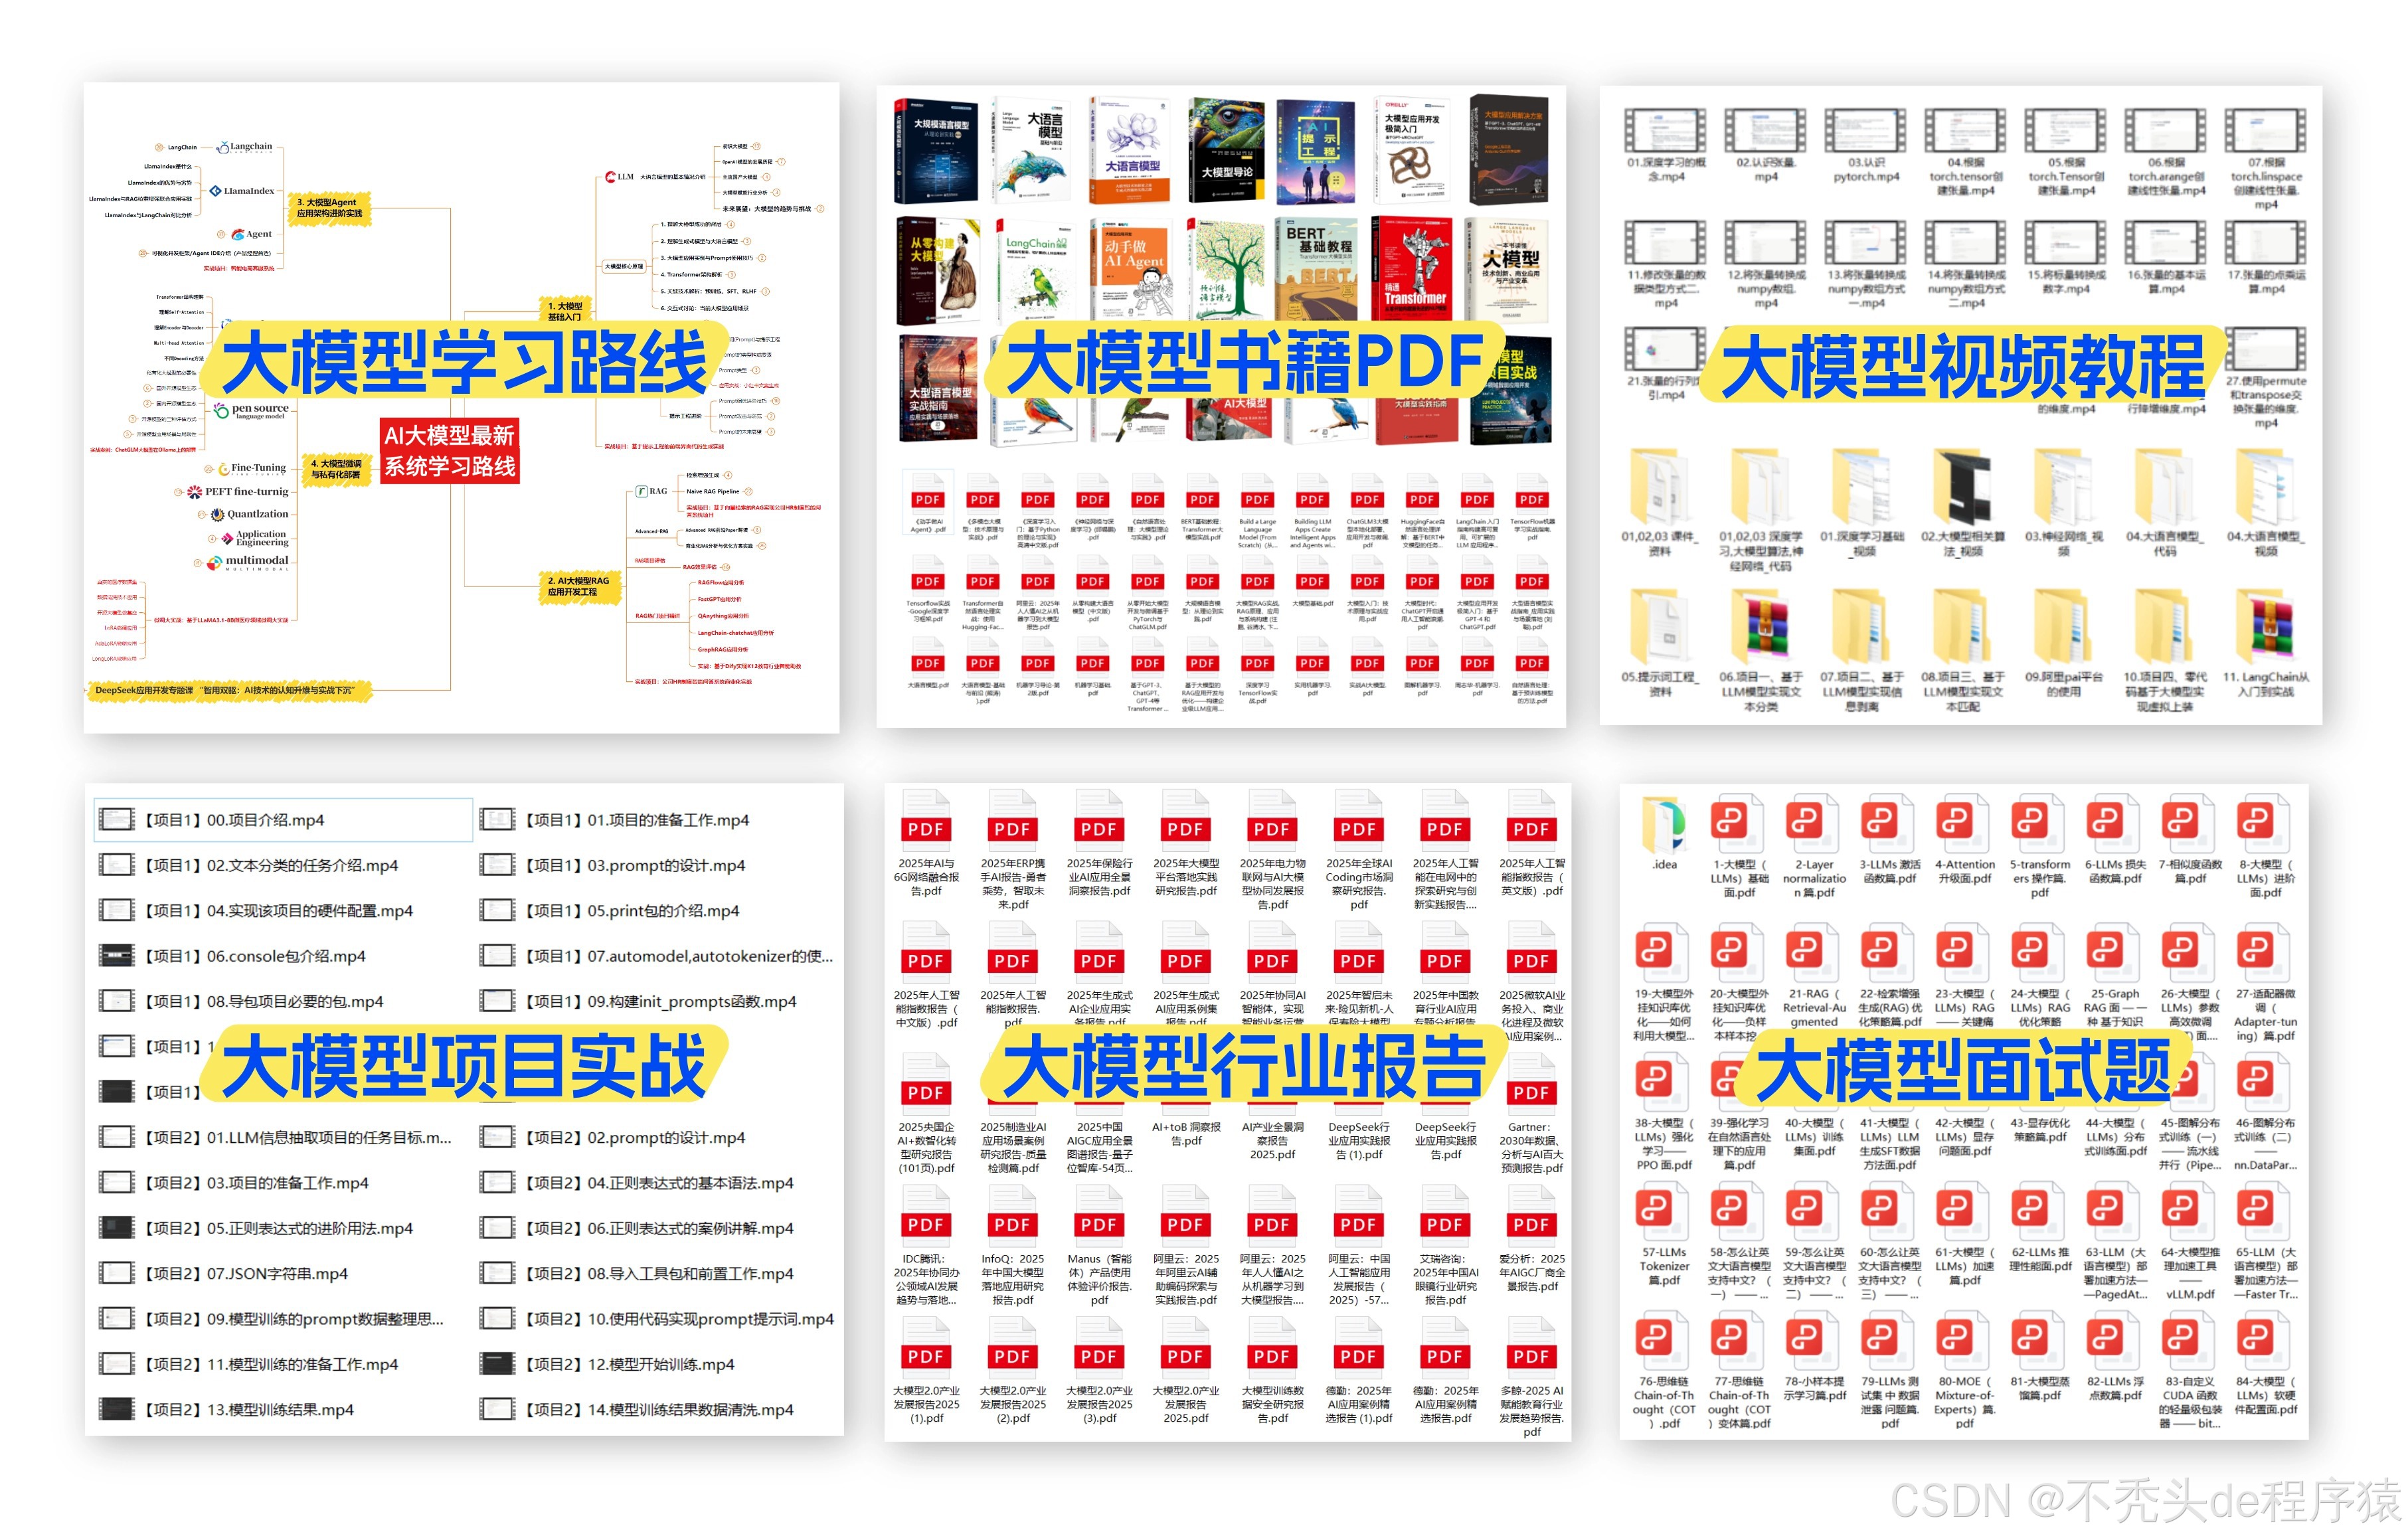
一、大模型专属系统化学习路线

整套学习路线参考今年企业用人标准和新手学习习惯定制,规划好从零基础到独立搭建企业级大模型项目的每一步,可以帮你规避八成以上无用功,躲开新手常见误区,高效完成技能升级。
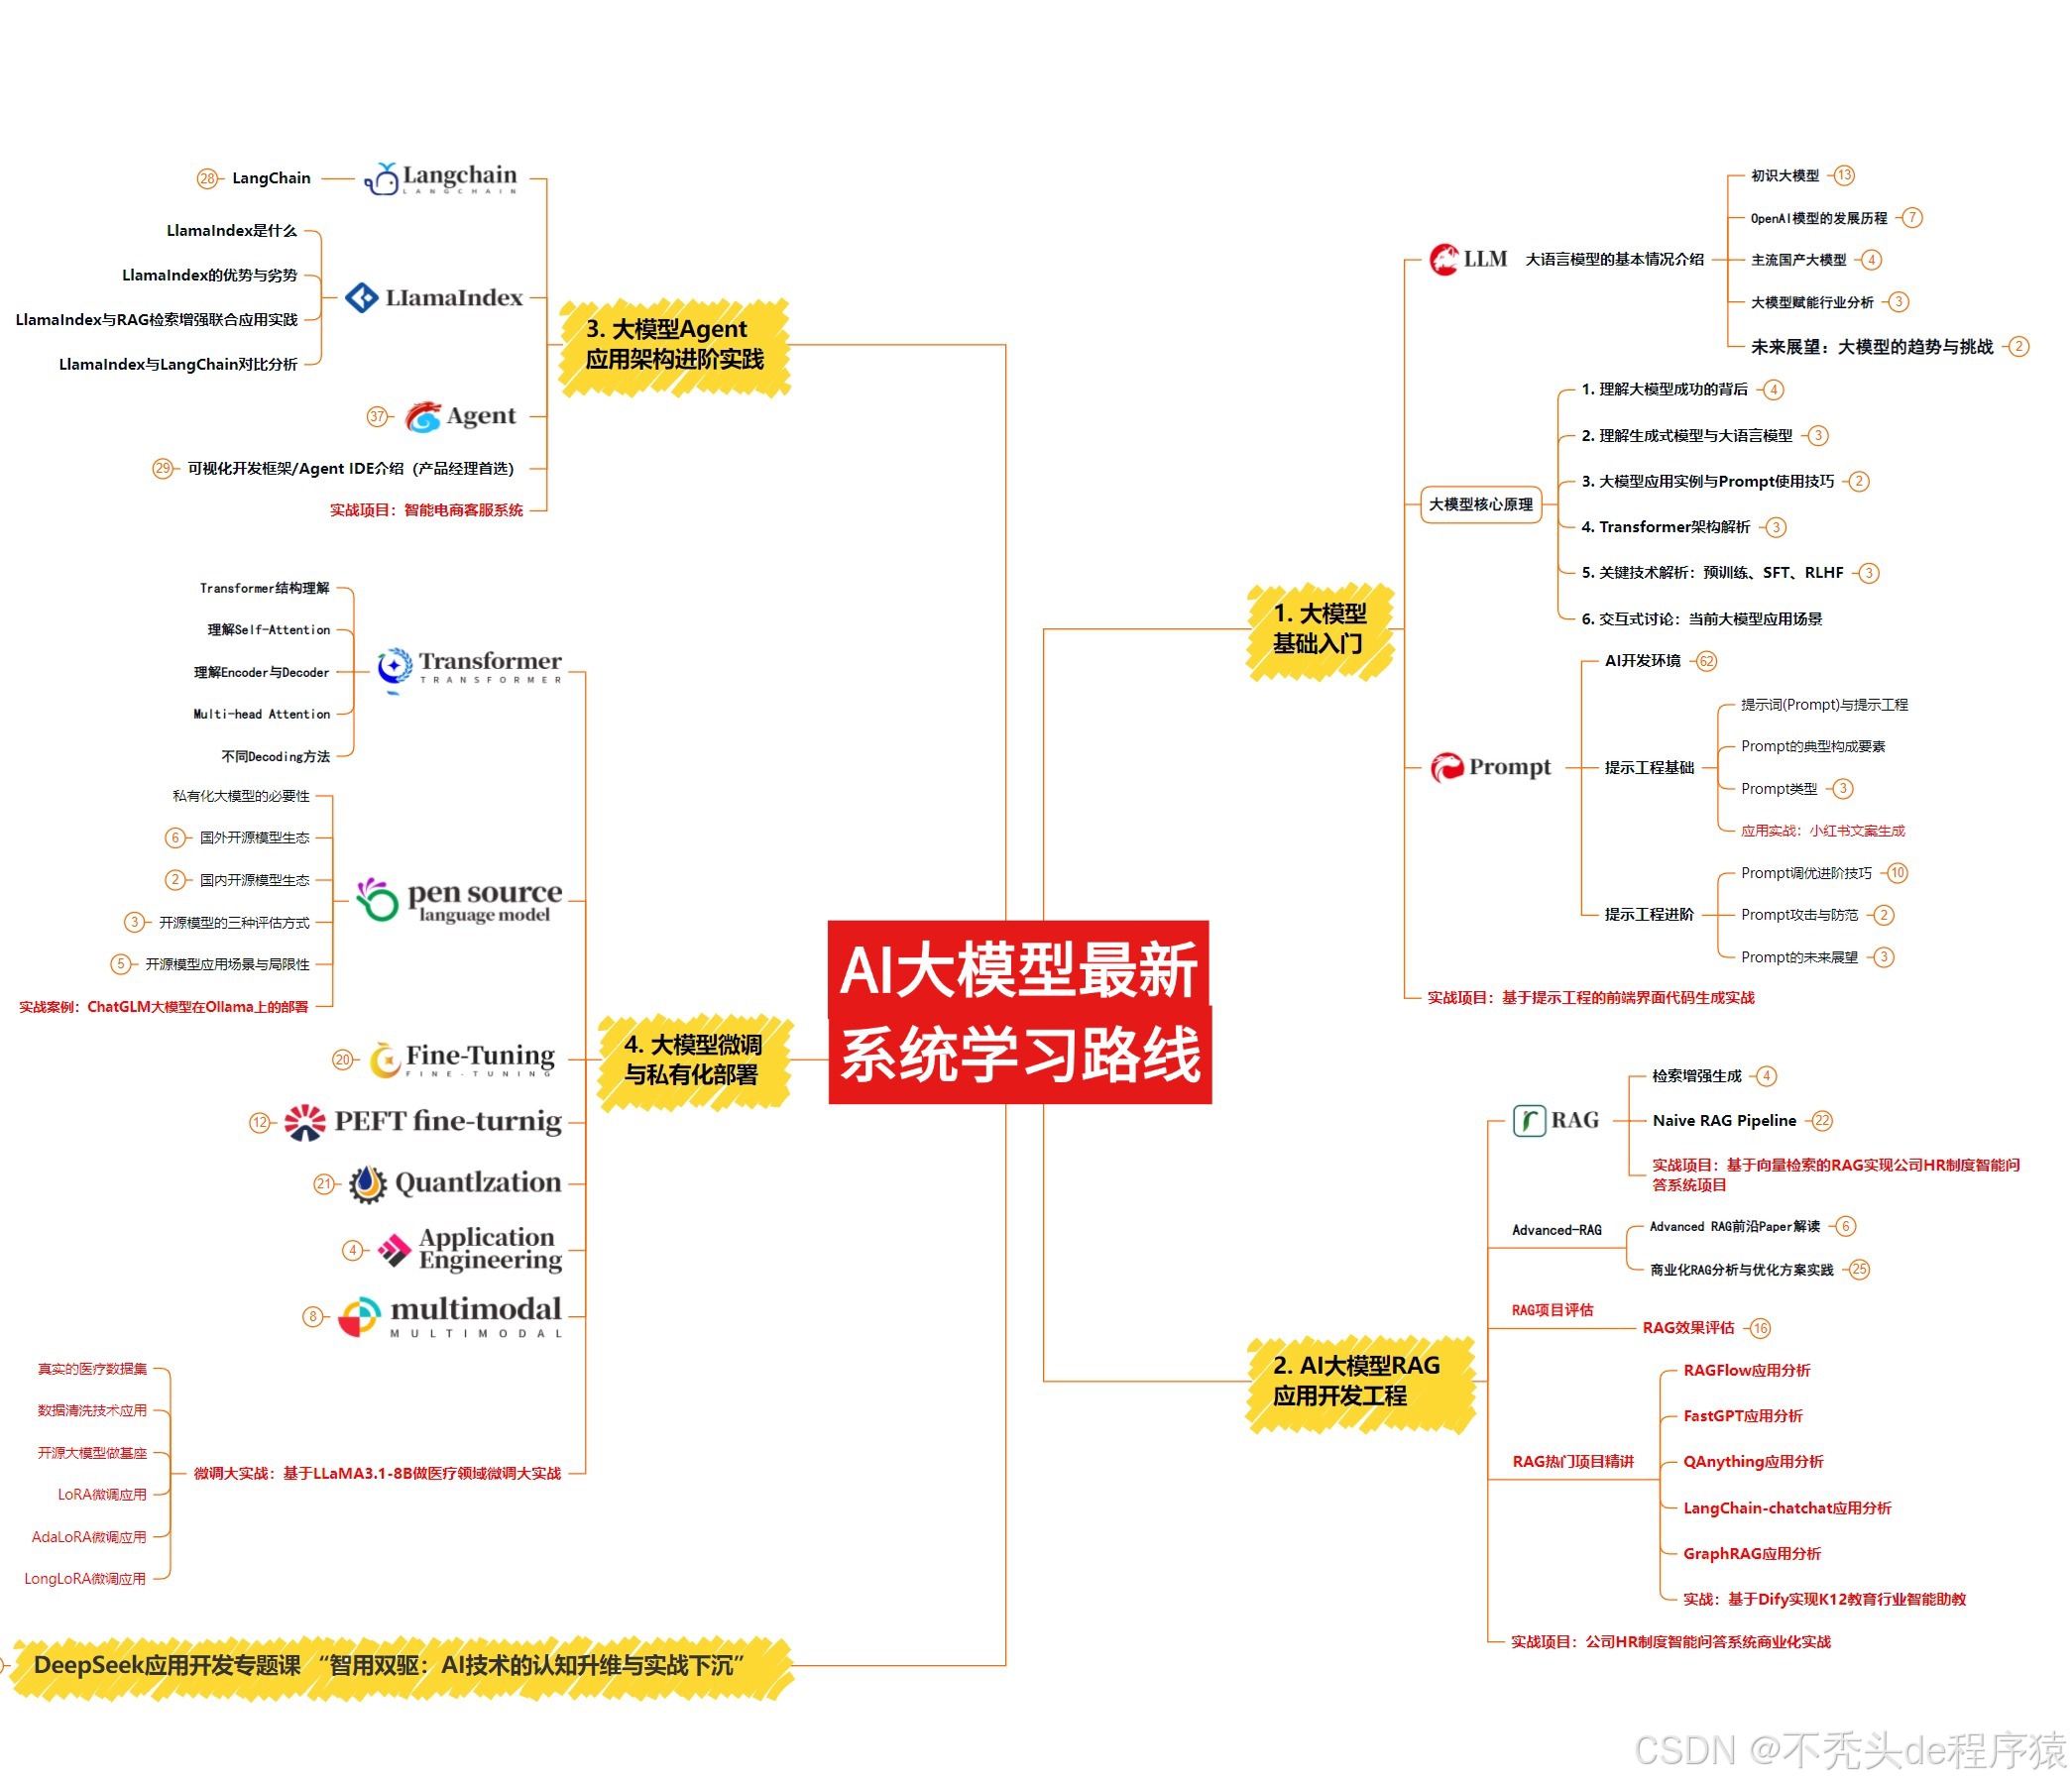
请添加图片描述

二、零基础到高阶实战全套视频教程

包含大模型基础认知、高阶提示词、RAG 检索增强、开源模型微调、向量数据库、私有化部署、AI‑Agent 智能体开发全套教学视频,跟着实操练习,降低自学门槛。
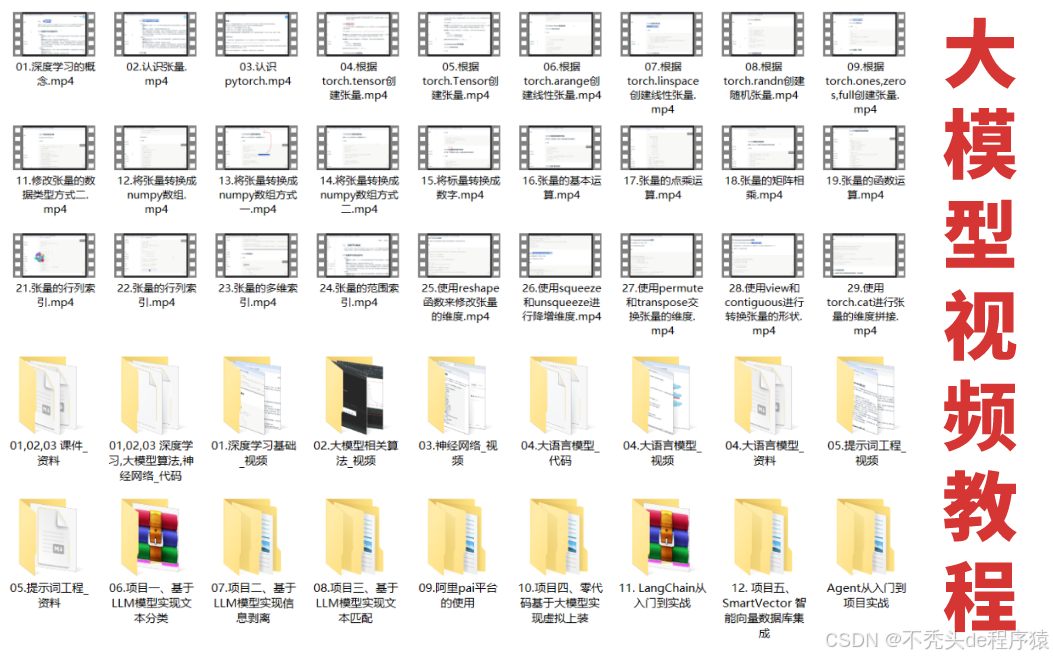
请添加图片描述

三、技术电子书与干货文档

收纳 2026 前沿技术要点,Transformer 底层架构、提示词工程、RAG 工程落地、轻量化微调、MCP 通信协议、vLLM 推理加速、大模型安全管控等全部具备详细讲解。
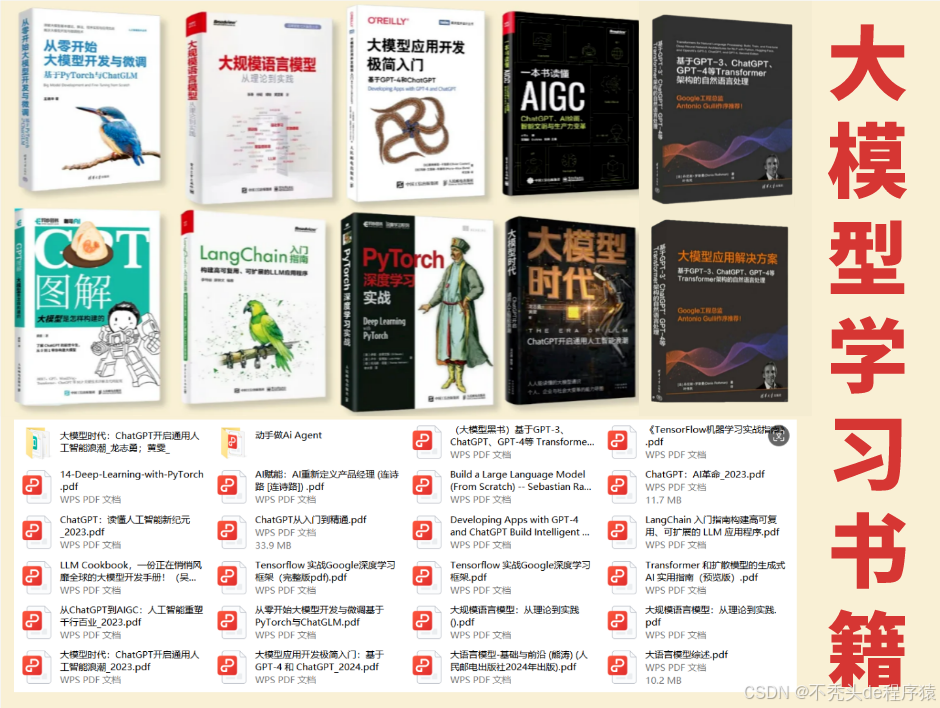
请添加图片描述

四、最新 AI 行业调研报告

汇集头部互联网厂商、第三方调研机构行业资料,国产主流大模型横向测评、企业 AI 落地白皮书、大模型岗位薪资调研报告,方便你紧跟行业风向,找准就业、副业方向。
请添加图片描述

五、可直接运行实战项目以及配套源码

内置 DeepSeek 私有知识库搭建、多模态微调、RAG 企业文档问答、本地开源大模型部署、多智能体协同等当下热门实战案例,附带完整可运行源码。做完之后既可以锻炼实操能力,项目案例还能够直接写到简历用来求职。
请添加图片描述

六、2026 大厂大模型岗位面试真题

现如今大模型岗位面试早已不再只考察枯燥的理论原理,面试官重点考察项目落地、线上故障排查、业务改造经验。很多技术功底过硬的兄弟缺少针对性刷题准备,面试屡屡碰壁,这份真题补齐你的备考短板。
请添加图片描述

适配学习人群

零基础转行新人、Java 后端开发者、前端工程师、测试工程师、运维、数据分析从业者、打算拓展 AI 副业的职场人。

九十天可落地分阶段学习计划

第一阶段(10 天・基础应用入门)

学完之后你的大模型认知已经超越绝大多数普通使用者。旁人只会和 AI 闲聊对话,你可以定制专业提示词,编写简易代码,打通业务系统和大模型。

  • 熟悉各大主流大模型的商业化落地场景
  • 搞懂大模型产生智能的底层逻辑
  • 掌握借助 AI 提升工作效率的核心思路
  • 吃透 AI 应用业务架构、技术架构
  • 学习提示词结构、思维链、思维树实操
  • 了解提示词攻击风险以及对应的防御手段

第二阶段(30 天・RAG 高阶实战阶段)

主攻私有知识库搭建,开发专属对话智能体,吃透主流大模型开发框架,适配 Python、JavaScript 两类开发者。

  • 弄懂什么时候需要搭建检索增强知识库
  • 动手搭建 PDF 企业文档问答系统
  • 吃透 Embedding 向量嵌入基础知识点
  • 向量数据库实操、混合检索优化方案
  • 本地部署向量模型、性能调优

第三阶段(30 天・模型训练微调阶段)

到此阶段学习完毕,你已经具备应聘大模型岗位的硬性实力,可以独立微调垂直行业专属大模型,上手开源多模态大模型。

  • 分清预训练、全量微调、轻量化微调之间区别
  • 动手搭建简易神经网络小实验
  • 训练数据集清洗、搭建规范
  • Transformer 架构逐层拆解
  • 低成本本地微调实操方案

第四阶段(20 天・项目部署和商业闭环)

熟悉各类大模型吞吐量、推理成本参数,可以搞定云端、本地私有化部署,找寻适合自身的副业方向。

  • 大模型本地运行硬件配置挑选
  • 多款国产商用大模型优劣势对比
  • vLLM 推理加速部署教程
  • 公有云平台私有部署开源大模型实操案例
  • 完整开源 LLM 项目搭建流程
  • AI 项目内容安全、互联网算法备案相关知识

👇👇扫码免费领取全部内容👇👇!
请添加图片描述

不少兄弟疑惑,这套学习资源含金量如何?

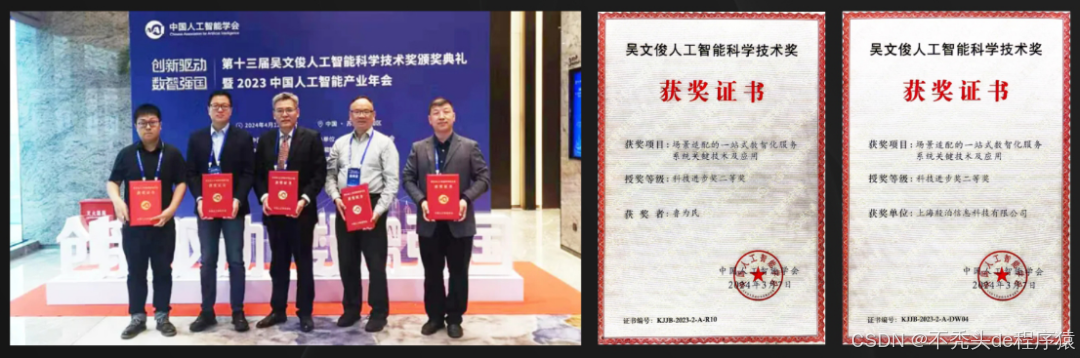
整套学习资料由我和鲁为民博士一同整理编撰。博士本科就读清华大学,于加州理工学院取得博士学位,现如今担任殷泊信息科技 CEO;他打造的 MoPaaS 云平台拿下国际权威机构认证,服务国家电网、航天科工等上千家大型企业;累计发表五十余篇 IEEE 专业论文,手握三十余项国内外 AI 相关专利,斩获吴文俊人工智能相关奖项。

整套教程全部立足于企业真实落地需求,摒弃花架子演示 Demo。不管你是零基础新手,还是拥有多年编程阅历的技术从业者,整套材料都能够助力你吃透大模型技术、实现薪资上涨、顺利转型 AI 高薪赛道。
请添加图片描述
请添加图片描述

完整版 AI 大模型全套学习资料已经上传 优快云,有需要的兄弟可以微信扫描 优快云 官方二维码免费领取,全套资源永久免费获取。
请添加图片描述

RAG 已死?Agentic RAG 才是企业知识库问答的未来 2024年上半年,"RAG已死"的论调在AI圈广为流传:大量企业投入数十万甚至上百万搭建的传统RAG知识库问答系统,因准确率不足70%、无法处理复杂问题、幻觉频发等问题被弃用,似乎检索增强生成技术已经走到了尽头。不是RAG已死,而是传统静态RAG已经无法满足企业复杂场景的需求,Agentic RAG(代理式检索增强生成)作为RAG的进化形态,通过引入智能代理的规划、记忆、工具调用、反思能力,将企业知识库问答的准确率提升至90%以上,是未来3年企业级大模型应用的核心落地方向。 阅读详情

相关推荐

2025防失业预警:不会用DeepSeek-RAG建知识库的人正在被淘汰

DeepSeek-RAG是一种基于检索增强生成(RAG)模型的深度学习技术,它结合了信息检索和文本生成的优势,能够高效地从海量信息中提取有价值的知识,并生成准确、流畅的自然语言回答。与传统的人工构建知识库的方法相比,DeepSeek-RAG能更快速、更精准地构建和更新知识库,使得企业能够实时获取最新的信息,并提供更加智能化的服务。2025年,随着DeepSeek-RAG等智能工具的普及,知识管理将进入一个全新的时代。

s13596191285的博客 77

什么样的Agent项目,才算好项目!

AI Agent求职避坑指南与进阶攻略 核心问题:为何同做AI Agent项目,有人拿大厂Offer,有人简历被刷? 避坑项:避免简单调用API、缺乏业务场景、无优化逻辑的“玩具项目”。 优质项目标准: 工程落地思维:解决企业痛点(如成本、效率、安全)。 技术深度:分层模型调度(低成本国产模型+高端模型协同)。 业务适配:多行业场景(金融/电商/政务等)的优化案例。 大厂面试官看重维度: 非技术堆砌:少提“用了什么模型”,多讲“如何解决问题”。 核心三要素:业务价值、成本控制、性能优化。 2026年趋势:

2401_84815887的博客 233

Agent 系列16|记忆与 RAG 落地

本篇为SupportPilot引入RAG知识库与长期记忆机制,解决检索不准、记忆无序等问题。通过文档切分(带标题路径)、关键词+向量混合检索(BM25+RRF)、分数门槛与重排流水线,实现精准召回与拒答;结合引用标注与排查工具,提升可解释性。长期记忆支持写入门槛、更新留痕、按相关度召回及用户删除,确保数据合规。全程仅用Python标准库,兼容真实embedding替换,实现离线可跑的完整RAG与记忆系统。

forest_09的博客 285

从Java后端到Agent开发:我的零经验转行真心话

做了3年CRUD Java后端,我今年果断转岗。全程零经验自学,不裸辞、不赌运气,没报过几万块的智商税培训班。踩遍转行所有坑,今天掏心窝,跟所有迷茫的后端兄弟说几句大实话。不灌鸡汤、不画大饼,只讲普通人能听懂、学完就能用的转行真相✨日复一日CRUD,改接口、调参数、修重复bug。熬了三年、五年,看似技术熟练,实则一直在原地踏步。最扎心的是,行业新人扎堆入行,低代码、自动化工具不断普及。普通Java后端的岗位,替代性越来越高,薪资天花板肉眼可见。

jennycisp的博客 488

IB网络下不同租户业务隔离方案

IB(InfiniBand)网络隔离可以在不同的通信模式下实现,其中包括 IPoIB(IP over InfiniBand)通信模式。在 IPoIB 模式下,InfiniBand 网络可以承载 IP 数据包,使得基于 IP 的应用程序能够在 InfiniBand 网络上进行通信。在这种情况下,IB 网络隔离通常指通过配置 Partition Key(PKey)来实现不同的租户或应用程序之间的网络隔离。然而,IB 网络隔离并不仅限于 IPoIB 模式。

guganly的专栏 1527

Flexible H-Tree(灵活 H 树)与 Multi-Tap 时钟流程解析

通过灵活 H 树与多抽头技术的结合,复杂时钟架构可在保持电气对称性的同时适应不规则布局,为高性能、低功耗 SoC 设计提供高效的时钟网络解决方案。

weixin_45371279的博客 1918

长上下文淘汰RAG?从瓶颈解析到Mac知识库实战搭建

随着大模型上下文窗口从128K扩展到1M甚至更远,不少人开始质疑检索增强生成(RAG)是否还有存在价值。实际上,长上下文解决的是“能装下多少”的问题,而RAG解决的是“该装什么、如何快速找到”的问题,二者并非替代关系,而是互补协作。在规模化知识库场景中,全量塞入上下文不仅成本高昂、延迟严重,还可能因信息过载导致模型“迷失在中间”。RAG通过向量检索、混合搜索、重排等环节,先筛选高相关片段再让模型精读,在中文文档问答、企业制度解析等场景中依然是最稳妥的方案。本文从RAG的工程瓶颈出发,对比知识图谱、结构化知识

weixin_29054245的博客 274

Matlab TreeBagger实战:用随机森林预测房价的5个关键步骤(附完整代码)

本文详细介绍了使用Matlab的TreeBagger工具包构建随机森林模型预测房价的完整流程。通过波士顿房价数据集实战,涵盖数据预处理、模型构建、参数调优、特征重要性分析及高级应用(如分位数回归)等5个关键步骤,并附有完整代码,帮助读者快速掌握这一强大的回归分析工具。

ol789012的博客 444

2025防失业预警:不会用DeepSeek-RAG建知识库的人正在被淘汰,从零基础到精通,收藏这篇就够了!

前几天,老板和我们开了个会,提到一个让人深思的事情:越来越多的客户开始询问,能不能把DeepSeek接入他们的系统,帮助他们管理数据、合同和一些文件。那一刻,我突然意识到,AI技术已经不仅仅是个高大上的话题,它正在切实改变着我们工作和生活的方式。客户的需求很简单,但背后却透露着一个深刻的问题——他们希望通过AI来提高效率、减少错误。对于很多传统企业来说,信息的混乱和管理的漏洞已经成为不可忽视的痛点。想象一下,如果这些企业能够通过。

Javachichi的博客 841

大白话讲解Numpy中什么是一维、二维、三维数组,以及5种创建方式

NumPy中提供了多种创建数组的方式,其中最基本的方式就是通过array()函数创建数组在使用该函数时直接传入列表或元组即可。 通过array()函数分别创建一维数组、二维组和三维数组,那么什么是维度呢?一维、二维、三维有什么区别? 1、什么是维度? 维度可以理解为描述数据的一种 “方向” 或者 “层次”。在数组中,维度的数量决定了我们需要用多少个索引来访问一个元素 2、一维、二维、三维的区别? (1)一维:一维数组就像是一条直线上排列的一组数据,例如: a = np.array([1, 2

1365

量化平台深度测评:聚宽 / 米筐 / 迅投 QMT 对比分析

本文对比测评国内主流量化交易平台聚宽、米筐和迅投QMT,从回测性能、实盘稳定性和高级功能三方面展开分析。测试显示:聚宽在低频策略回测中效率最高(128秒),米筐次之;迅投QMT凭借C++直连架构实现最低延迟(150ms)和最高订单撤销成功率(98.5%)。平台特色方面,QMT的智能拆单算法可减少25%滑点损失,聚宽的因子库支持版本控制和缓存复用。建议低频策略选聚宽,高频交易选QMT,团队协作优先考虑聚宽。测试数据均来自合规实盘环境,建议根据策略特性进行试用验证。

tianchi2009123的博客 7374

RAG技术会随着大模型的发展被淘汰吗

检索增强生成(RAG, Retrieval-Augmented Generation)是近年来兴起的一种技术,结合了信息检索与生成式人工智能的能力,为解决知识密集型任务提供了高效的解决方案。未来,可能出现更加紧密结合的技术框架,如“内生检索增强模型”(In-Model Retrieval-Augmented Generation),将检索模块集成到模型内部,进一步提升效率和性能。模型规模控制:相比训练更大的模型,RAG通过小模型结合外部检索即可达到类似效果,降低了计算资源消耗。

qq_28704101的博客 1050

无法加载文件:C:\Users\Lenovo\AppData\Roaming\npm\cnpm.ps1,因为在此系统上禁止运行脚本编程

当您遇到类似于"无法加载文件:C:\Users\Lenovo\AppData\Roaming\npm\cnpm.ps1,因为在此系统上禁止运行脚本编程"的错误消息时,请按照上述步骤来解决问题。当您尝试加载文件C:\Users\Lenovo\AppData\Roaming\npm\cnpm.ps1时,可能会遇到类似于"无法加载文件:C:\Users\Lenovo\AppData\Roaming\npm\cnpm.ps1,因为在此系统上禁止运行脚本编程"的错误消息。请注意,更改执行策略可能会带来一些安全风险。

PixelInk的博客 1922

程序员必学:AI时代不被淘汰的完整指南(建议先收藏再看)

本文探讨AI是否会淘汰程序员,认为AI会淘汰很多程序员但岗位不会消失。作者提出程序员需从"码农"转变为"AI操控师",详细介绍了AI核心概念、常用工具、使用技巧及AI+编程四大学习方向。强调程序员应将自身经验与AI融合,掌握Spring AI、LangChain等开发框架,学习RAG知识库、多模态等技术,才能在AI时代不被淘汰,成为企业招聘的香饽饽。

xxue345678的博客 1669

华为OD机试真题 新系统 【社交网络相同爱好好友查询】

华为od机试真题 新系统【社交网络相同爱好好友查询】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为od机试真题【社交网络相同爱好好友查询】多语言题解实现。

qq_45776114的博客 1336

基于Jeecgboot3.8.1的vue3版本前后端分离的flowable流程管理平台

基于Jeecgboot3.8.1的vue3版本前后端分离的flowable流程管理平台

宁波阿成的博客 1544

AI不会淘汰程序员,但会淘汰不懂AI的程序员!收藏学习指南

文章探讨AI与程序员的关系,认为AI会淘汰部分程序员但不会淘汰整个岗位。作者详细介绍了程序员在AI时代需要掌握的核心知识,包括AI基础概念、常用工具、使用技巧以及AI与编程的结合方法。强调程序员应将自身经验与AI融合,成为AI操控师,通过学习AI开发框架、集成方式和业务应用,提升自身竞争力,避免被时代淘汰。

2401_84815887的博客 1272

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Agentic-RAG-记忆与遗忘-知识库如何持续生产

摘要:Agentic RAG 把检索轮数跑自适应以后,新的问题冒出来了——系统在生产环境里跑得越久,"记忆"就堆得越多。有价值的上下文和过期的噪声混在一起,检索质量反而随时间下降。本文从自建企业知识中枢的一手经验出发,讲我们怎么给知识库做"记忆管理":短期记忆按会话生命周期淘汰,长期记忆走"写入门槛 + 冲突合并 + 过期淘汰"三道闸,并把记忆做成一个独立的运行时模块,而不是某个聊天页面的附属功能。落点是:**记忆不是"多存一点",而是"该记的留得住、该忘的丢得掉"。

xiaoshe_ai的博客 210

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

2026年中小商家AI客服推荐系统的技术拆解:大模型与RAG架构怎么选

中小商家选AI客服,本质是选"大模型+RAG+多平台接入"这套组合里工程化做得最扎实的产品。别为微调买单,把预算花在知识库冷启动和大促稳定性上,先用两周试用数据说话。

weixin_65214035的博客 195

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

收藏!AI 会淘汰程序员么?小白&程序员必看解析

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

AI大模型的博客 610

2025最新,程序员AI学习路线图

有句话说得好:AI 时代,所有的传统业务都值得利用 AI 重塑一遍。

weixin_41560800的博客 1212

Trae实战:不写代码搭建自动维护的个人知识库

知识库的维护成本常让人中途放弃,内容过时、重复堆积是核心痛点。要解决这些问题,关键在于构建一套持续摄入、自动整理、自动淘汰的流水线,本质上是将采集、清洗、向量化入库与过期清理交给自动化任务。RAG(检索增强生成)与向量数据库、定时调度等技术的组合,为个人知识库长期可用提供了工程基础。本文从自动化维护的原理出发,借助Trae这一AI原生IDE的自然语言编程能力,结合Dify、Qdrant与APScheduler,分步演示如何零手写核心代码搭建一套会自我维护的知识库系统,涵盖技术选型、脚本生成、向量入库与定时运

weixin_31499265的博客 225

AI Agent 落地指南:从零到企业级实战

这篇文章把我在实际项目里踩过的坑、验证过的技术方案,一次性讲清楚。不绕概念,直接上干货。

weixin_58753619的博客 198
上一篇: 16个快问快答,带你轻松入门大模型,小白也能秒懂!收藏必备!
下一篇: 建议收藏!工作5年程序员|给计算机大学生的大实话
不秃头de程序猿
博客等级 码龄5年 4089粉丝 1476原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值