与Sora同架构的Stable Diffusion 3.0 震撼发布!4 秒视频生成却翻车,网友:还是等 Sora 吧!

【学习笔记】文生图模型——Stable diffusion3.0 2.0原理才看到VAE,sd3.0就发布了,虽然还没看到源码和详解,但原来的那个小方向估计得弃。人已经麻了。 阅读详情

前言

Stability AI 发布了 Stable Diffusion 3,这款图像生成 AI 模型再次刷新了人们的认知。

这款由 Stability AI 倾力打造的文本变图模型,可是迄今为止最强大的“黑科技”!无论你想生成多主题的奇幻场景,还是高精度的风景写真,统统不在话下!

Stability AI 强调了该版本的几个亮点,其中首要的就是文字渲染能力
,他们在其官网上一连给了三幅含有文字的图片,不仅文字清晰而且也没有任何拼写错误。

Stability AI 的首席执行官 Mostaque 也在 X(Twitter)上狂炫带有文字的图片:

Stable Diffusion 3.0 中改进的排版是 Stability AI 在新模型中构建的几个改进的结果。

Stability AI 的首席执行官 Mostaque 说:“这归功于 Transformer
架构和额外的文本编码器。现在可以实现完整的句子和一致的风格。”

另一个亮点是“多主题生成” :用一句话,就能描绘出用户脑中的万千世界!

Stability AI 举了一些例子,让 SD3 根据一句含有多个元素的 Prompt 画一幅画:

“一幅画作,描绘了一位宇航员骑着一头穿着芭蕾舞裙的猪,手里还撑着一把粉色雨伞。在猪旁边,一只戴着高顶礼帽的知更鸟静静伫立。画面一角,写着‘Stable
Diffusion’。”

“一张照片,画面中有一个红色的球体放在一个蓝色的立方体上面。它们的后面有一个绿色的三角形,右边有一只狗,左边有一只猫。”

其中一个主题元素变化还能不影响其他元素:

还有一个亮点就是“超高画质” ,这简直是细节控的福音,每一张图片都堪称艺术品!例如下面这张变色龙特写照片:

而且生成的漫画和素描,质感也比之前的版本进步了一个台阶:

虽然 Stable Diffusion 3.0 最初被展示为文本转图像生成 AI 技术,但它将成为更广泛应用的基础。Stability AI
近几个月也在开发 3D 图像生成和视频生成功能。

Mostaque 说:“我们制作可以随时随地使用并适应任何需求的开放模型。这是一个跨尺寸的模型系列,将支持我们下一代视觉模型的发展,包括视频、3D 等。”

Mostaque 也在 X(Twitter)给出了一个 SD3D 的视频:

而且,Stable Video 也正式开放公测了,支持图生视频和文生视频。尽管人们都在关注 Sora,但有人估计至少 Sora
还需要三个月才能开始内测。需要强调的是,这是内测,不同于像 Stable Video 这样的公开测试。

从官网放出的例子来看,生成视频在画面稳定性、运动幅度、画面细节丢失上,效果跟 Sora 不相上下。

有网友试玩了 Stable Video 后发出评论:“越来越期待 Sora 了”。该网友表示,“用自己的照片试用了一下
StableVideo,发现只有没有脸的图才能有比较好的生成结果,有脸的都崩了。”其他网友补充称,有脸的图调低 motion
值也可以得到相对正常的结果,但会很卡顿。

架构变革:采用类似 Sora 模型架构

在过去的一年中,Stability AI 一直在稳步迭代和发布多个图像模型,每个模型都显示出越来越高的复杂性和质量。7 月份发布的 SDXL 大幅改进了
Stable Diffusion 基础模型,现在该公司正寻求更进一步的发展。

新的 Stable Diffusion 3.0 模型旨在提供改进的图像质量和更好的性能,以从多主题提示生成图像。它还将提供比以前的 Stable
Diffusion 模型更出色的排版,从而在生成的图像中实现更准确和一致的拼写。过去,排版一直是 Stable Diffusion 的一个弱点,包括
DALL-E 3、Ideogram 和 Midjourney 在最近的版本中也一直在努力解决这个问题。Stability AI 正在构建各种模型大小的
Stable Diffusion 3.0,模型可选择的参数范围在 800M 到 8B 。

Stable Diffusion 3.0 不仅仅是 Stability AI 已经发布的模型的新版本,它实际上基于一种全新的架构。

Emad Mostaque 表示,Stable Diffusion 3 是原始 Stable Diffusion 的正统续作。它采用了类似于 OpenAI
近期发布的 Sora 模型的 Diffusion Transformer 新架构,代表了该领域的最新技术突破。

“Diffusion Transformer”技术在 2022 年首次提出,并在 2023 年进行了改进,现在已经实现了可扩展性。此外,Stable
Diffusion 3.0 还采用了“流匹配”技术,这也是另一项改进质量且不会增加太多额外负担的新技术。

Stability AI 一直在尝试多种图像生成方法。本月早些时候,该公司发布了 Stable Cascade 的预览版,它使用 Würstchen
架构来提高性能和准确性。Stable Diffusion 3.0 采取了不同的方法,使用了 Diffusion Transformer。

Mostaque 强调说:“Stable Diffusion 以前没有 Transformer。”

Transformer 是许多生成 AI 革命的基础,被广泛用作文本生成模型的基础。图像生成主要在 Diffusion 模型领域。详细介绍
Diffusion Transformer (DiT) 的研究论文解释说,它是一种新的 Diffusion 模型架构,它用操作潜在图像块的
Transformer 取代了常用的 U-Net 主干。DiT 方法可以更有效地利用计算资源,并且可以超越其他形式的 Diffusion 图像生成。

Stable Diffusion 的另一个重大创新是流匹配 (flow matching)。流匹配的研究论文解释了它是一种训练 Continuous
Normalizing Flows (CNFs) 以模拟复杂数据分布的新方法。根据研究人员的说法,使用 Conditional Flow Matching
(CFM) 和 optimal transport paths(最佳传输路径),与 diffusion paths 相比,可以实现更快的
training、更有效的采样和更好的性能。

随着技术的迭代,目前 Stable Diffusion 已经能够生成非常艺术化的图片了,完全有赶超人类的架势,已经有不少工作被这类服务替代,比如制作一个
logo 图片,画一张虚拟老婆照片,画质堪比相机。

最新 Stable Diffusion 除了有win多个版本,就算说底端的显卡也能玩了哦!此外还带来了Mac版本,仅支持macOS
12.3或更高版本
。
在这里插入图片描述

2.stable diffusion视频合集

我们在学习的时候,往往书籍源码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,一步步带你入坑stable
diffusion,科学有趣才能更方便的学习下去。
在这里插入图片描述

3.stable diffusion模型下载

stable
diffusion往往一开始使用时图片等无法达到理想的生成效果,这时则需要通过使用大量训练数据,调整模型的超参数(如学习率、训练轮数、模型大小等),可以使得模型更好地适应数据集,并生成更加真实、准确、高质量的图像。
在这里插入图片描述

4.stable diffusion提示词

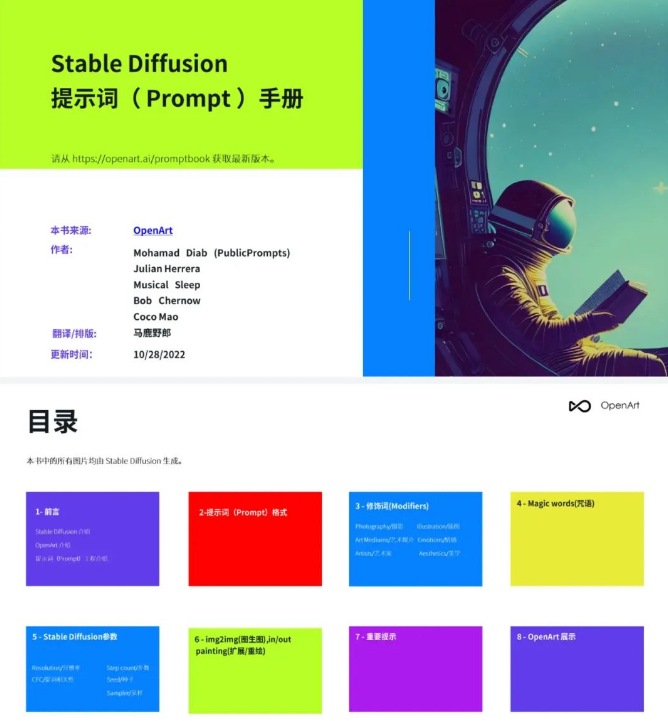
提示词是构建由文本到图像模型解释和理解的单词的过程。可以把它理解为你告诉 AI 模型要画什么而需要说的语言,整个SD学习过程中都离不开这本提示词手册。
在这里插入图片描述

5.SD从0到落地实战演练

在这里插入图片描述

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名SD大神的正确特征了。

这份完整版的stable diffusion资料我已经打包好,需要的点击下方插件,即可前往免费领取!

有需要的朋友,可以长按下方二维码,免费领取!

AIGC所有方向的学习路线思维导图

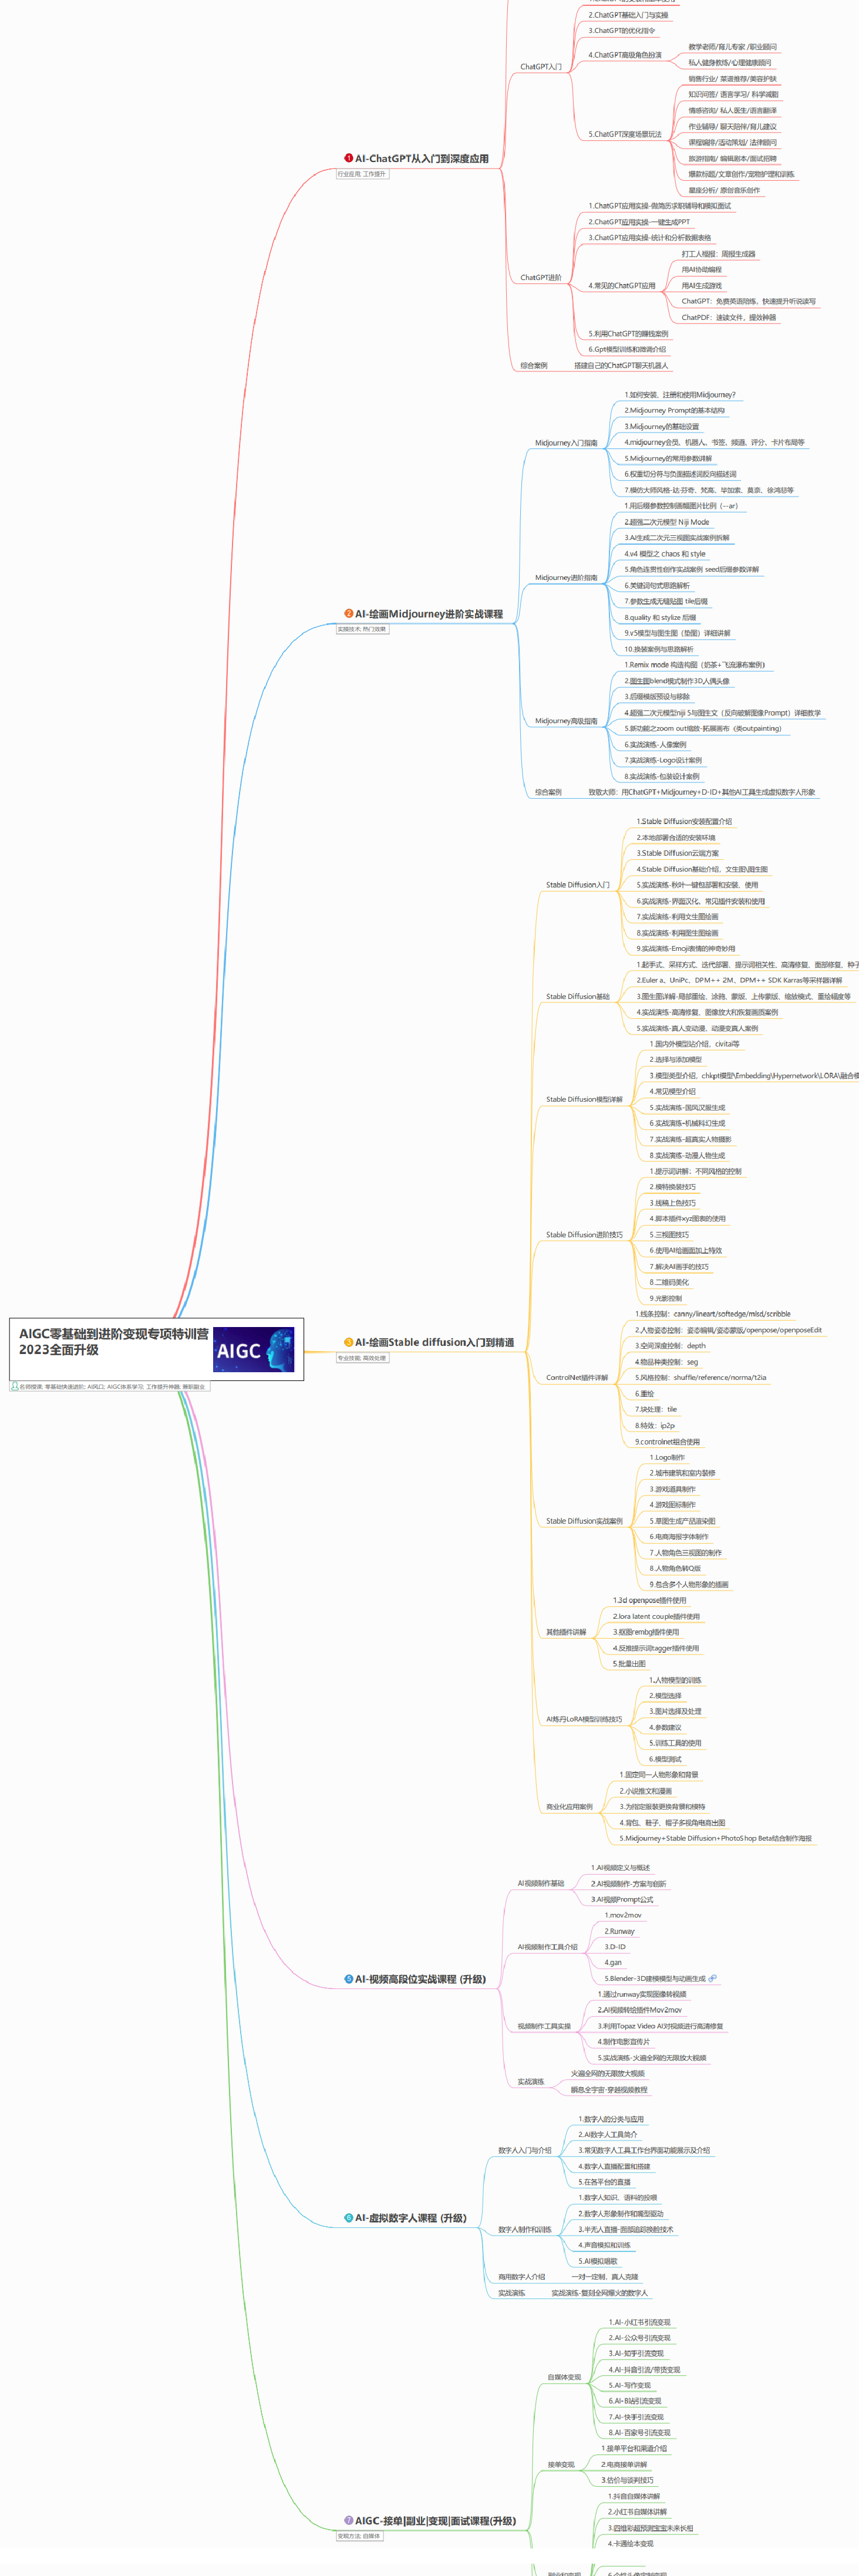
这里为大家提供了总的路线图。它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。如果下面这个学习路线能帮助大家将AI利用到自身工作上去,那么我的使命也就完成了:
在这里插入图片描述

AIGC工具库

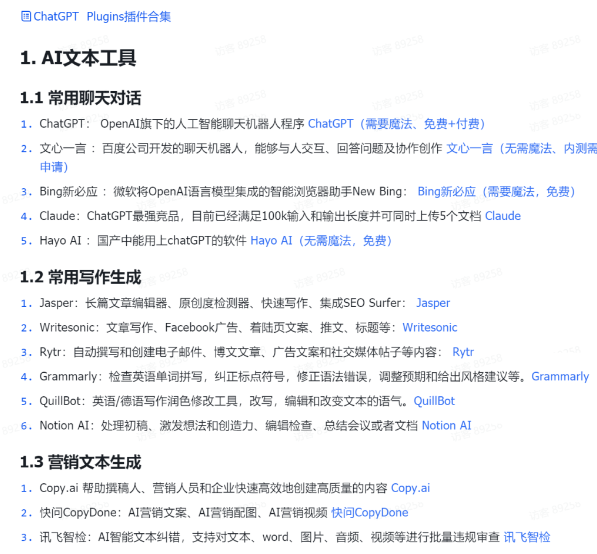
AIGC工具库是一个利用人工智能技术来生成应用程序的代码和内容的工具集合,通过使用AIGC工具库,能更加快速,准确的辅助我们学习AIGC
在这里插入图片描述

有需要的朋友,可以点击下方卡片免费领取!

精品AIGC学习书籍手册

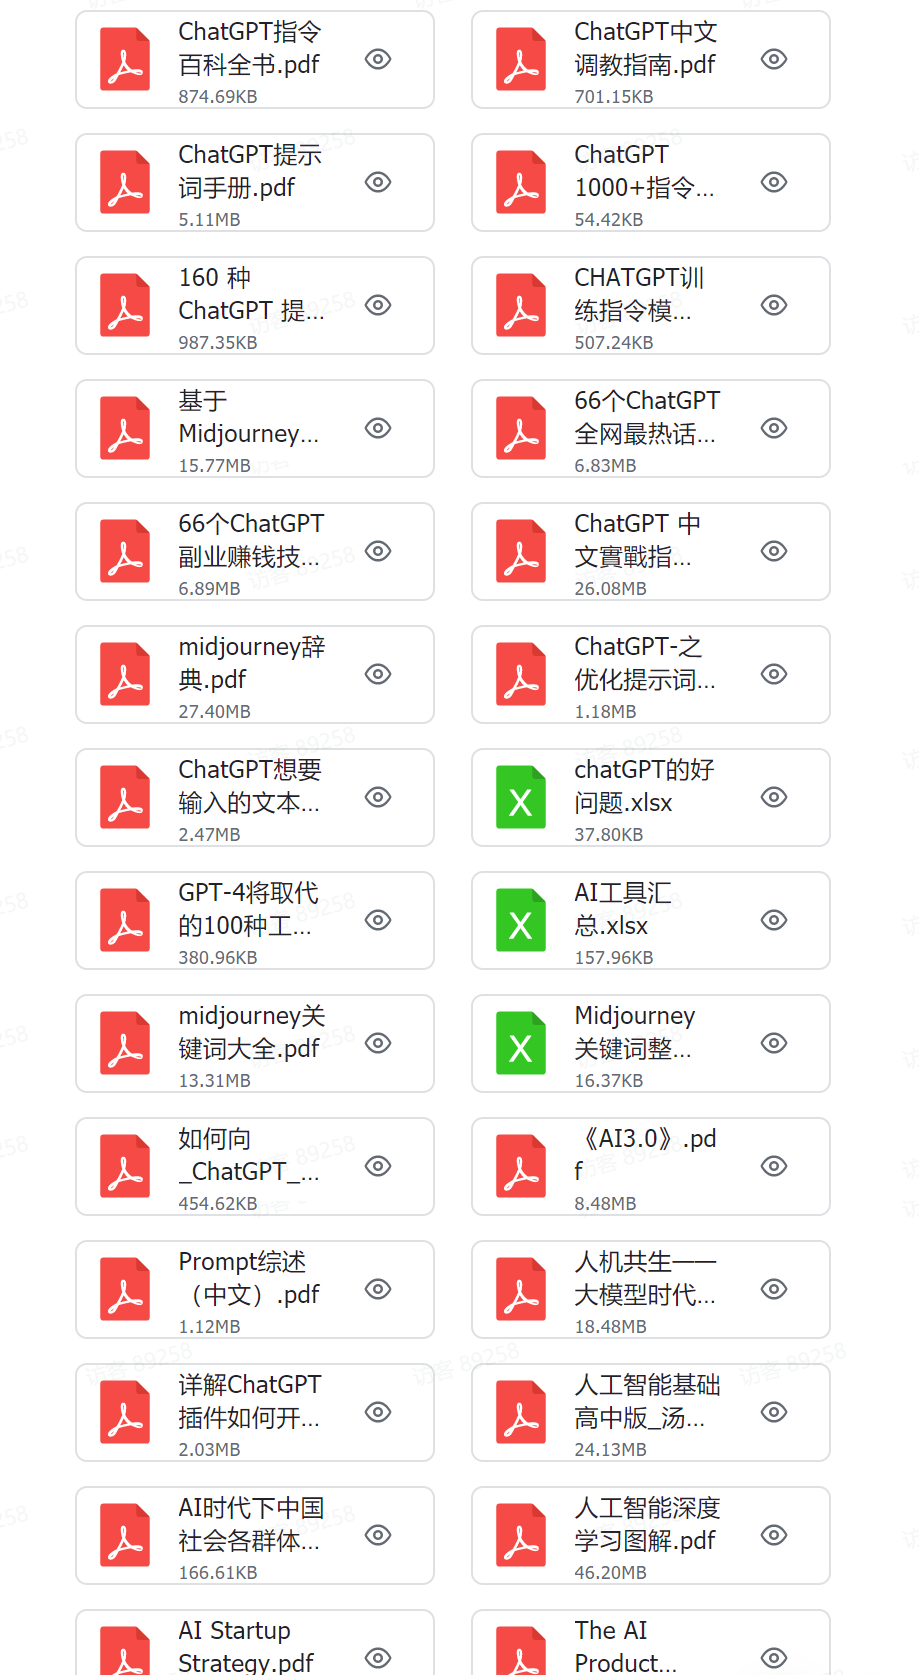
书籍阅读永不过时,阅读AIGC经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验,结合自身案例融会贯通。
在这里插入图片描述

AI绘画视频合集

我们在学习的时候,往往书籍源码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,科学有趣才能更方便的学习下去。
在这里插入图片描述

有需要的朋友,可以长按下方二维码,免费领取!

与Sora同架构的Stable Diffusion 3.0 震撼发布 它还将提供比以前的 Stable Diffusion 模型更出色的排版,从而在生成的图像中实现更准确和一致的拼写。根据研究人员的说法,使用 Conditional Flow Matching (CFM) 和 optimal transport paths(最佳传输路径),与 diffusion paths 相比,可以实现更快的 training、更有效的采样和更好的性能。该网友表示,“用自己的照片试用了一下 StableVideo,发现只有没有脸的图才能有比较好的生成结果,有脸的都崩了。 阅读详情

相关推荐

ArduPilot 的 RTOS 选择:为何 ChibiOS 成为现代飞控的首选

本文深入探讨了ArduPilot选择ChibiOS作为现代飞控首选RTOS的原因。通过对比FreeRTOS和NuttX,ChibiOS凭借其50ns中断响应、1.2μs上下文切换时间和高效的资源管理脱颖而出,特别适合处理无人机飞控中的高频传感器融合和实时控制任务。文章还详细分析了ChibiOS在STM32硬件上的优化实践及其在无人机开发中的显著优势。

weixin_29161719的博客 571

Stable Diffusion 3 来了 —— 充满了巨大的改进

Stable Diffusion 3 是来自 Stability AI 的最新、能力最强的文本到图像模型。它在处理多主题提示、图像质量甚至文本渲染能力方面都有显著改进。该模型套件目前的参数范围从 8 亿到 80 亿。它结合了扩散变换器架构(类似于 Sora)和流匹配。扩散变换器架构扩散变换器(DiT)架构是一种新颖的扩散模型类别,它结合了变换器技术。与通常使用卷积 U-Net 骨干的传统扩散模型不同,DiT 使用变换器在图像的潜在块上进行操作。扩散变换器(DiT)架构。

数智笔记 2057

SAP批量数据导入实战:BDC、CATT、LSMW三大工具保姆级对比教程

本文深入对比了SAP系统中三大批量数据导入工具BDC、CATT和LSMW的核心定位、适用场景与实战操作。BDC适合复杂逻辑的编程式处理,CATT适合业务用户快速录制回放,LSMW则是数据迁移项目的结构化首选。文章提供了详细的选型决策框架、性能优化技巧及常见陷阱规避指南,帮助SAP顾问和开发者高效完成数据批量维护任务。

weixin_29213525的博客 154

Stable Diffusion v3.0 api使用教程

今天Stable Diffusion v3.0的api终于可以使用, 效果真的出奇的好.我这里测试了下给予Python环境的调用, 效果也是非常的好.

专注于人工智能领域的小何尚 2732

无线自组织网络基础知识

参考书籍:《无线自组织网络路由协议及应用》 目录第一章 绪论1.1 无线自组织网络概述1.1.1 无线自组织网络的定义及分类1.1.2无线自组织网络的主要特点1.1.3无线自组织网络的应用与发展1.无线自组织网络的应用2.无线自组织网络的起源和发展1.2典型的无线自组织网络1.2.1移动Ad Hoc网络1、移动Ad Hoc网络的定义2.移动AdHoc网络的特点3.移动Ad Hoc网络的应用1.2....

逸凌Time 2万+

Part03 数据结构

本文介绍了CSP-S初赛中常见的高级数据结构及其实现,包括: 线性结构:双端栈、双端队列、单调队列、优先队列和ST表,重点分析了它们的特点、时间复杂度及典型应用场景。 集合与森林:并查集(带路径压缩和按秩合并)和树的孩子兄弟表示法,展示了多叉树转化为二叉树存储的方法。 特殊树结构:包括二叉堆、树状数组、线段树和字典树,详细说明了它们的构建、查询和更新操作,特别强调了线段树的递归实现和字典树的前缀匹配特性。 每种数据结构都配有核心C++代码实现,涉及数组模拟、动态规划和树形结构等编程技巧,适合算法竞赛选手快速

weixin_43863957的博客 1181

Stable Diffusion 3重磅发布

提示(意译版):在一幅充满史诗感的动漫画面中,一位巫师屹立于夜幕笼罩的山巅之上,正用他的法杖向漆黑无垠的夜空中施展一道震撼宇宙的魔法。这道法术在夜空中绽放,化作由五彩缤纷的能量构成的「Stable Diffusion 3」字样,犹如夜空中最璀璨的星辰。提示(意译版):这张电影级视觉效果的照片,捕捉到了一个静谧的教室瞬间,一颗鲜红的苹果静静地躺在桌子上,而在它背后的黑板上,则用醒目的粉笔字写着——「要么做大,要么回家」。提示:在这幅夜幕下的摄影作品中,一辆标有「SD3」字样的运动赛车正在赛道上疾驰。

u012854516的专栏 2316

Creo报错代码-9?手把手教你重新生成许可证文件(基于Creo 10.0)

本文详细解析Creo报错代码-9的成因及解决方案,重点介绍如何重新生成许可证文件以应对网络环境变化导致的验证失败。通过分步指南和高级技巧,帮助用户有效管理多网络环境下的Creo许可证问题,提升工作效率。

weixin_30839881的博客 565

重磅!Stable Diffusion 3 发布,AI模型百花争鸣!

击上方关注 “终端研发部”设为“星标”,和你一起掌握更多数据库知识最近AI大变天!刚火了Sora,又火了Gemma,这不stable diffusion又来了!大语言模型成了龙争虎斗的年代已开启~Stable Diffusion 3到底是什么?用官方的描述,3.0版本核心功能是多主题提示、图像质量和拼写能力。比如给出提示词:厨房的桌子上放着一块绣有“good night”字样的绣花布和一只绣有小老...

这个时代,作为程序员可能要学习小程序 1284

App inventor2通过蓝牙控制Arduino Uno LED开关

App inventer2控制Arduino Uno LED开关 如果学会这个小程序,大部分的手机通过蓝牙控制Arduino的功能都可以实现,这个小示例是通过蓝牙模块向Arduino发送"0"和"1",而其它功能要发送其它不同的字符串内容给Arduino. 所需硬件: Arduino Uno JDY-16 蓝牙模块(我的是蓝牙4.2版本) 草帽LED(可选) 手机(我用的是安卓,苹果手机应该也可以,最近其应用商店也有App inventor(AI)伴侣) 软件: Aduino IDE或者Platfom

Firmin123456的博客 5500

ch32v103xx 烧写

烧写方式 串口uart, usb,swd(wch link)但不建议按此使用,参官方说明。

qq_39239990的博客 639

重磅!Stable Diffusion 3.0正式开源!史上最强AI绘画模型!(附安装方法和下载地址)

正如承诺的那样,Stability AI在6月12日正式开源了Stable Diffusion 3(Medium版本)!不愧是AI生图领域的“开源英雄”。接下来就讲讲,怎么在本地部署最新的Stable Diffusion 3,大致分为以下几步

白帽阿叁的博客 6186

2026华为OD机试(C语言)真题【E卷+A卷+B卷+C卷+D卷】目录+在线OJ

华为OD机试真题题库【E卷+A卷+B卷+C卷+D卷】目录,C语言实现。

MISAYAONE的博客 11万+

Stable Diffusion本地部署教程

1)介绍Stable Diffusion是一个文本到图像的潜在扩散模型,由CompVis、Stability AI和LAION的研究人员在Latent Diffusion Model的基础上于2022年8月创建并推出。其核心技术源于AI视频剪辑技术创业公司Runway的首席研究科学家Patrick Esser以及慕尼黑大学机器视觉学习组的Robin Rombach。该模型可以根据输入的文本描述生成相应的图像。

runqu的博客 1669

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

一文解读:Stable Diffusion 3究竟厉害在哪里?

一文解读:Stable Diffusion 3究竟厉害在哪里?

weixin_38096064的博客 4661

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Stable Diffusion 3来啦!提示文本理解更好,图像质量更强

一名宇航员骑着一只穿着蓬蓬裙的猪,撑着一把粉色的伞,猪旁边的地上有一只戴着高帽的知更鸟,角落里写着" Stable Diffusion "的字样。史诗般的动漫艺术风格,一位巫师站在夜间的山顶上,向黑暗的天空施放咒语,上面写着由彩色能量生成的“Stable Diffusion 3”文字。将输入分成两部分,对其中一部分应用变换,而变换函数可以是任意的神经网络,其参数由另一部分决定,保证了变换的可逆性。一辆跑车的夜间照片,侧面写有“SD3”字样,汽车在赛道上高速行驶,巨大的路标上写着“更快”的文字。

RPA中国 1066

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Ai绘画行业又叒翻天了!Stable Diffusion 3.0开源!多图实测附安装包!

在显卡需求上,经实测SD3模型运行中大概会占用7-8G的GPU空间,所以**8G显卡已经几乎不太能带得动它了,本次测试我用的是点金手AIPC定制机,4060 TI,16G显存显卡,**它对大显存的显卡还是非常友好的。AIGC所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。在生成字符的理解上,在SD3模型之前,所有的AI绘画在字符的控制上都非常的弱,但SD3模型在生成的字符时,控制的已经非常优秀了。

A1353192296的博客 1873

期待已久的AI绘画Stable Diffusion 3.0终于开放了,可通过API使用了!

感兴趣的小伙伴,赠送全套AIGC学习资料,包含AI绘画、AI人工智能等前沿科技教程和软件工具,具体看这里。AIGC技术的未来发展前景广阔,随着人工智能技术的不断发展,AIGC技术也将不断提高。未来,AIGC技术将在游戏和计算领域得到更广泛的应用,使游戏和计算系统具有更高效、更智能、更灵活的特性。同时,AIGC技术也将与人工智能技术紧密结合,在更多的领域得到广泛应用,对程序员来说影响至关重要。未来,AIGC技术将继续得到提高,同时也将与人工智能技术紧密结合,在更多的领域得到广泛应用。

白帽阿叁的博客 1771

全网首发:教你如何直接用4090玩转最新开源的stablediffusion3.0

Content)技术,即人工智能生成内容的技术,具有非常广阔的发展前景。随着技术的不断进步,AIGC的应用范围和影响力都将显著扩大。以下是一些关于AIGC技术发展前景的预测和展望:1、AIGC技术将使得内容创造过程更加自动化,包括文章、报告、音乐、艺术作品等。这将极大地提高内容生产的效率,降低成本。2、在游戏、电影和虚拟现实等领域,AIGC技术将能够创造更加丰富和沉浸式的体验,推动娱乐产业的创新。3、AIGC技术可以帮助设计师和创意工作者快速生成和迭代设计理念,提高创意过程的效率。

xiaokangss的博客 895

Stable Diffusion 3横空出世!模型与Sora同架构,也能理解物理世界

最近,每天都有新炸弹,各家纷纷开大了。昨天的炸弹,是Stable Diffusion 3。AI生图效果,再次到达全新里程碑!提示(意译版):在一幅充满史诗感的动漫画面中,一位巫师屹立于夜幕笼罩的山巅之上,正用他的法杖向漆黑无垠的夜空中施展一道震撼宇宙的魔法。这道法术在夜空中绽放,化作由五彩缤纷的能量构成的「StableDiffusion 3」字样,犹如夜空中最璀璨的星辰。网友复刻版,同样惊艳:网友惊呼:这种prompt的一致性是我见过最好的!

yihanss的博客 544

Stable Diffusion终极指南:从零安装到精通|模型库+提示词秘籍+插件大全(含Checkpoint/Lora/Embedding)

【Stable Diffusion系统指南】本文详细介绍从环境安装到高阶应用的全流程,包含Checkpoint、Lora、Embedding等核心模型的配置方法,解析提示词工程原理,并汇总常用插件功能。通过结构化知识框架,帮助用户系统掌握SD技术栈,实现从入门到精通的进阶。

ice829的博客 1296

Stable Diffusion 3 发布,AI生图效果,再次到达全新里程碑!

提示(意译版):这张电影级视觉效果的照片,捕捉到了一个静谧的教室瞬间,一颗鲜红的苹果静静地躺在桌子上,而在它背后的黑板上,则用醒目的粉笔字写着——「要么做大,要么回家」。Bing的表现就更是离谱了,有的图中芭蕾舞裙的颜色不对,有的知更鸟站在了猪脑袋上,有的更是画面中飞满了知更鸟。一幅宇航员撑着粉色雨伞、骑着一只穿着芭蕾舞短裙的猪的画,猪旁边的地上是一只戴着高顶帽子的知更鸟,画面的角落里写着「stable diffusion」。在背后的墙面上,有一幅醒目的涂鸦艺术作品,写的是「SD3」。

jixn的博客 3万+

Stable Diffusion 3.0开源!史上最强AI绘画模型!(附安装和下载方法)

Stable Diffusion 3 代表了 AI 图像生成的重大进步,与以前的版本相比,性能和质量有所提高。本文将提供下载和安装 Stable Diffusion 3 的详细分步方法,确保您可以充分利用其潜力。Stable Diffusion 是免费的吗?通过 Web-UI 在 Windows PC 上本地运行 Stab...

weixin_31707171的博客 651

Stable Diffusion 3.0技术论文解读

赋予了Stable Diffusion 3惊人的能力。Stable Diffusion的强项在于。作为基准,它轻松碾压了所有竞品。固然能生成让人叹为观止的画面。而无需事后大动干戈地修修补补。的采购和租赁往往是最大的一块。真正让人惊喜的是SD3的。这正是他们将新架构命名为。在一定程度上实现了这一点。AI绘画领域扔出了一颗。造成这种局面的根本原因。对于从文本到图像的生成。割裂开来是件很头疼的事。对噪声的处理上别有心得。换言之,这项技术不仅能。但作为我们吃瓜读者而言。官方放出了一篇详尽的。这篇论文本质上是介绍。

浪漫韫秋 1473
上一篇: 用Stable Diffusion的ControlNet插件把二次元女友变成三次元
下一篇: 在本地跑一个AI模型(6) - Stable Diffusion模型微调
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1480原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值