喜欢画画,这拦不住的啊(Stable Diffusion进阶篇:ComfyUI 高清放大)

AI绘图:ComfyUI中图片放大与细节修复的终极指南 在数字艺术创作和图像处理中,我们经常会遇到需要放大图片的情况。无论是为了打印、展示还是仅仅为了提高图像质量,放大图像的同时保持或增强细节是一个挑战。幸运的是,ComfyUI提供了多种方法来实现图片的放大和细节修复。前几节课我们学习了文生图、图生图、局部重绘,但是生成的图片分辨率太小,我们可以通过模型放大、潜在放大、非潜在放大、分块放大多种方式对图像进行放大。本文将详细介绍如何在ComfyUI中使用这些方法,帮助你获得高质量的放大图像。在ComfyUI中,有多种方法可以实现图片的放大和细节修复。 阅读详情

高清放大

在AI绘画中给生成出来的图片通过高清修复或者超分辨率的手段放大尺寸是非常常见的,在之前学习过的WebUI中就有文生图的高清修复(Hi-
res fix)、图生图的SD放大(SD Upscale)以及后期处理中的算法放大。

在ComfyUI中也有类似的工作流,加载工作流的方法也很简单:
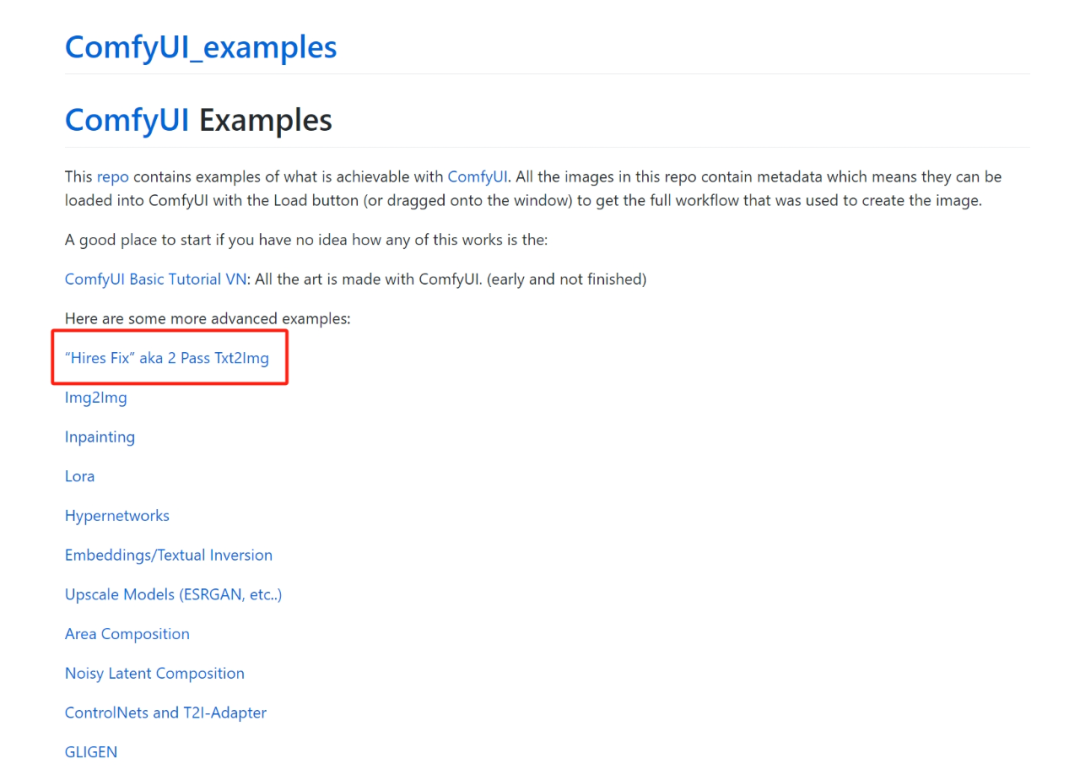
https://comfyanonymous.github.io/ComfyUI_examples/

来到这个开发者提供的网页中,选择第一个"Hires Fixaka 2 Pass Txt2Img",点开后鼠标右键将第一个图片另存为:
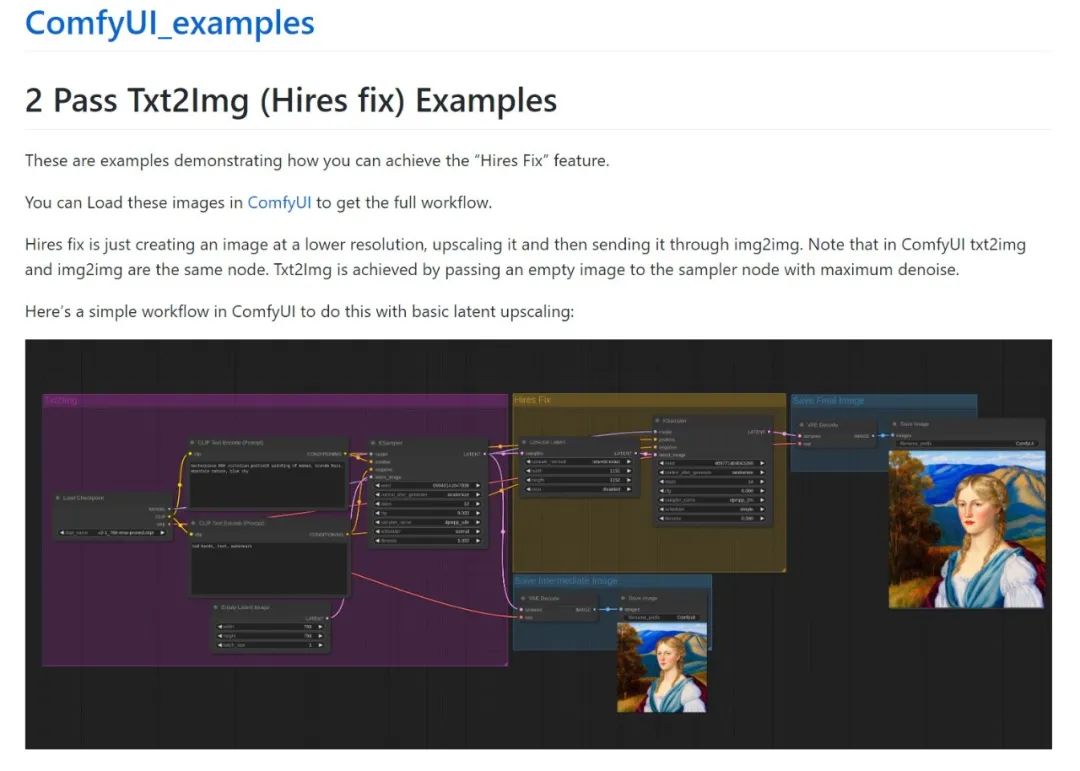
然后直接将图片拖拽到ComfyUI中,系统就会自动导入工作流:
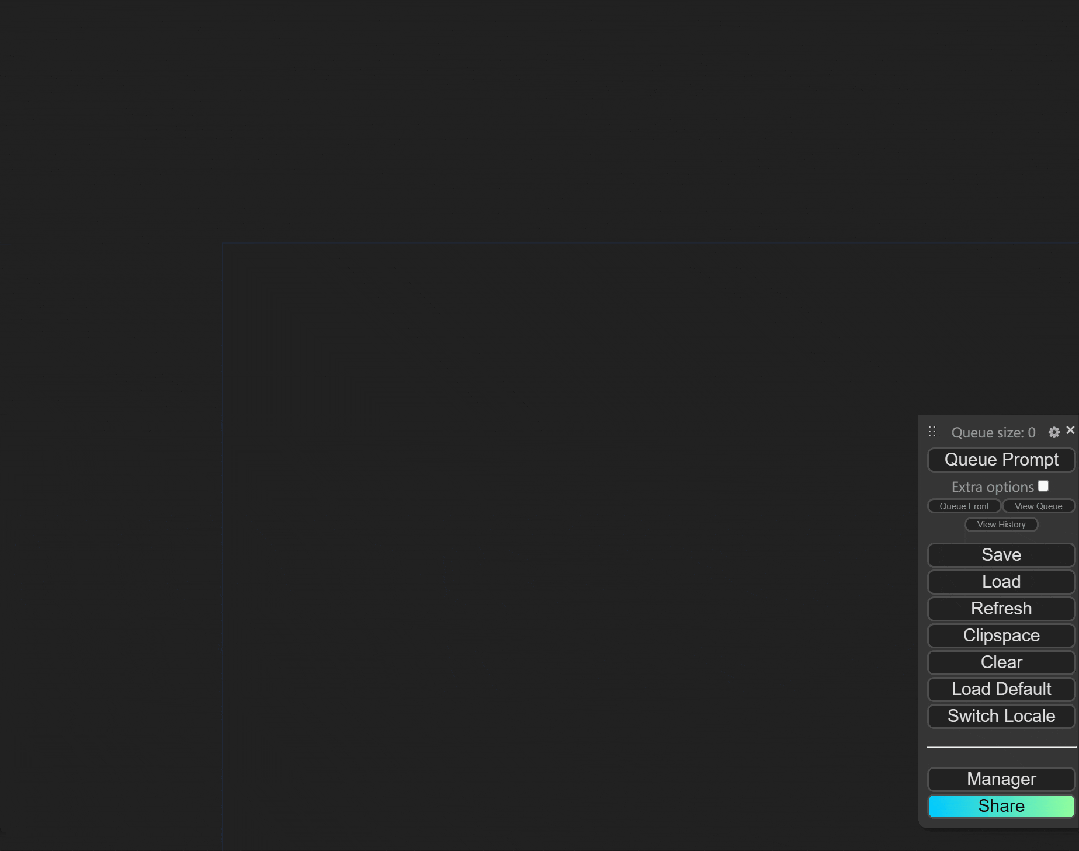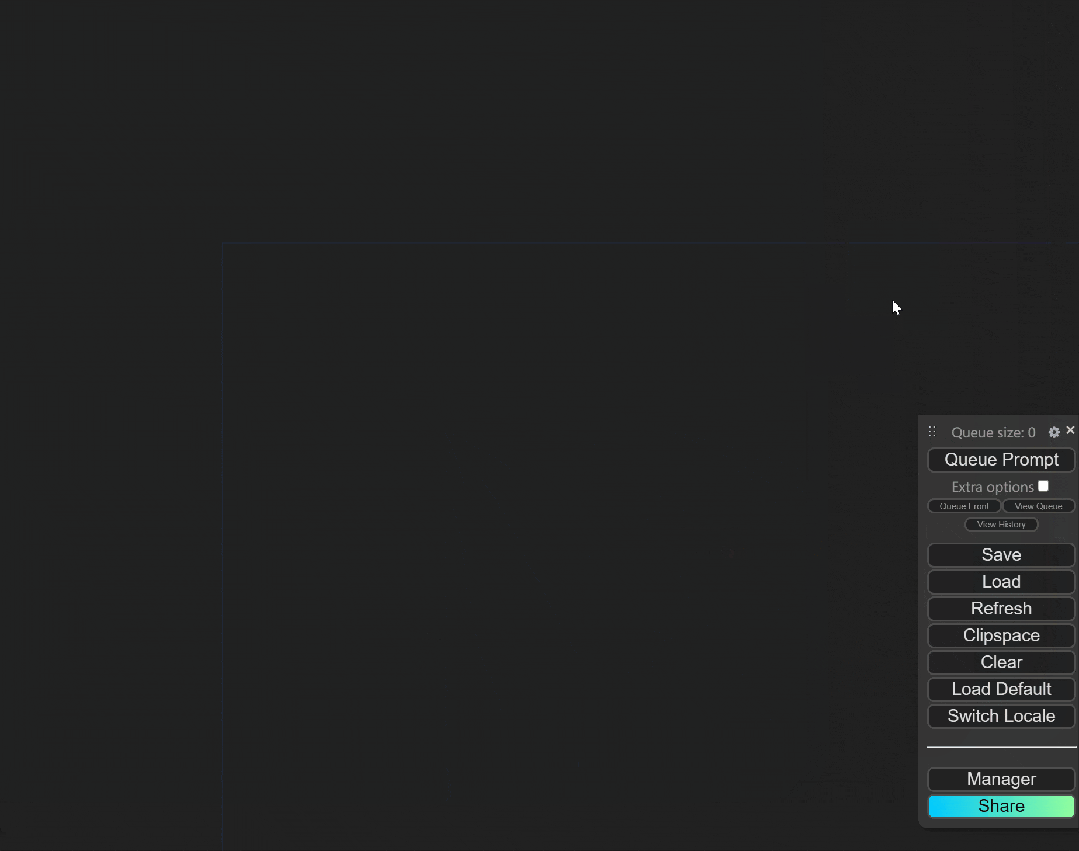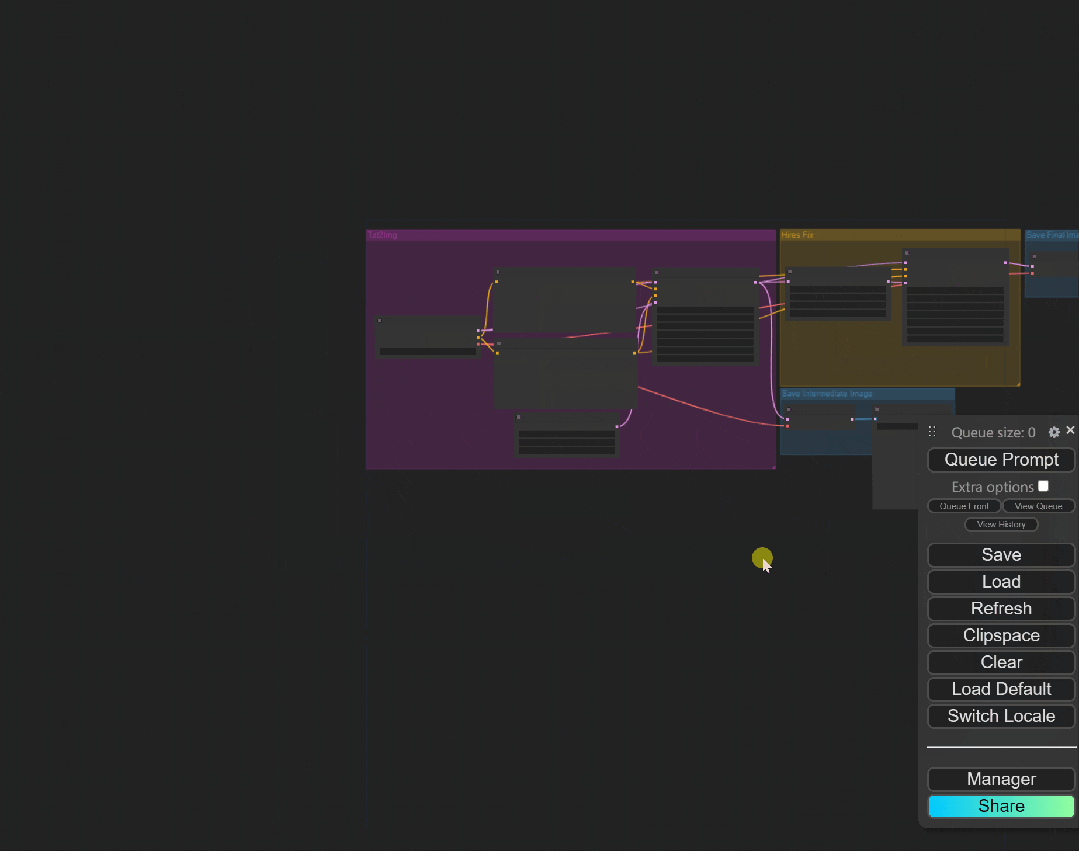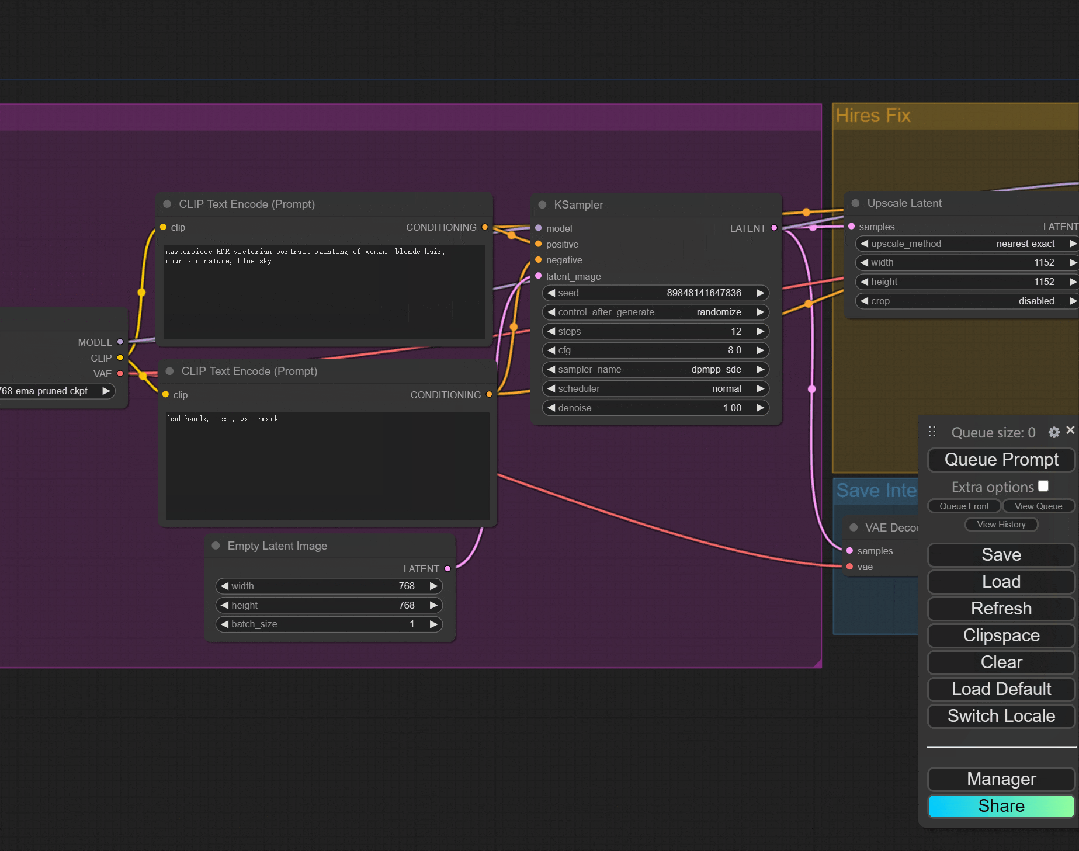
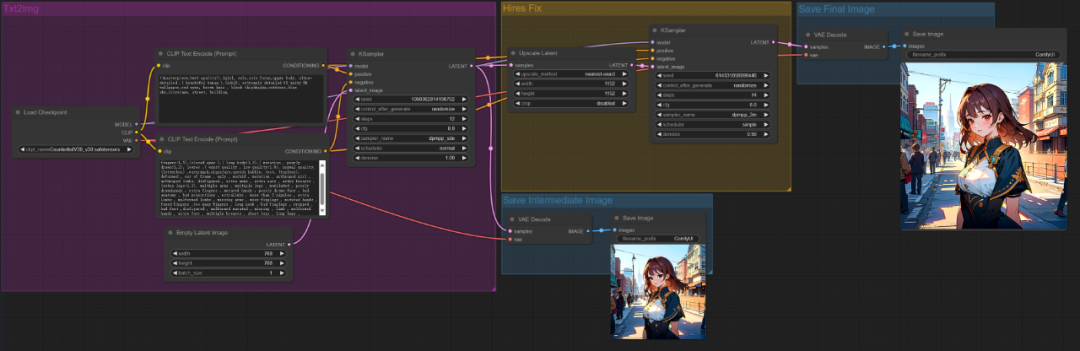
这样就是一个非常标准的文生图高清修复工作流了,这个工作流由几个不同的节点组成。

文生图放大:
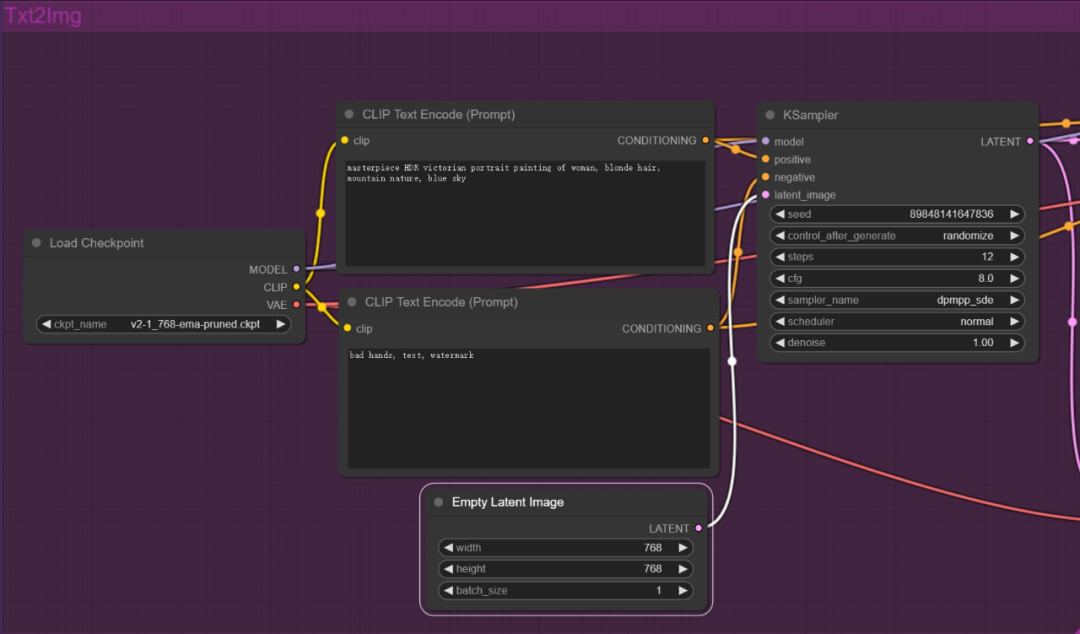
上图这个就是一个文生图的节点组合,从左到右分别是:Load Checkpoint模型加载器、CLIP Text
Encode提示词编码器(上正下负)、KSampler,最下面的Empty Latent(空白潜空间图像)节点可以设定基础的生成尺寸。

提示词参考(正面):

((masterpiece,best quality)),1girl, solo,solo focus,upper body, ultra-
detailed ,( beautiful woman ),(idol), extremely detailed CG unity 8k
wallpaper,red eyes, brown hair , black thighhighs,outdoors,blue sky,cityscape,
street, building,

‍在输入完提示词之后点击Queue Prompt后就会先在KSampler里生成一张低分辨率的图片,然后输出的Latent信息(潜空间)会被VAE
Decode和Save Image两个节点解码保存为图像。
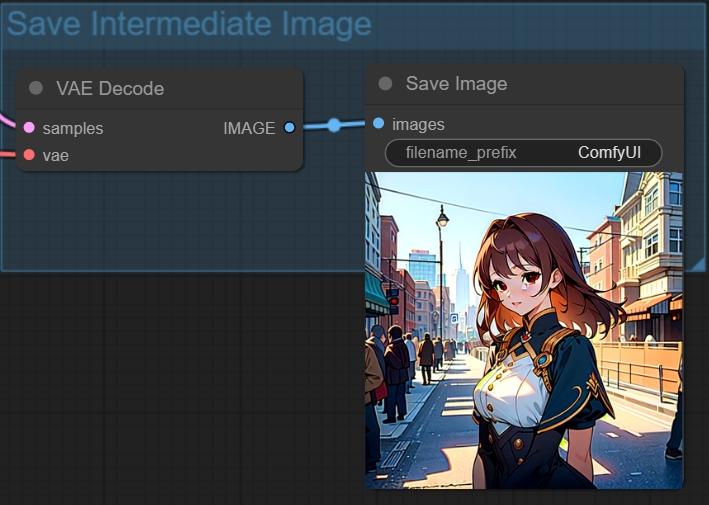
然后再被输入到Upscale Latent组件里,这个Upscale Latent是一个在潜空间里对图像进行缩放的基本节点。
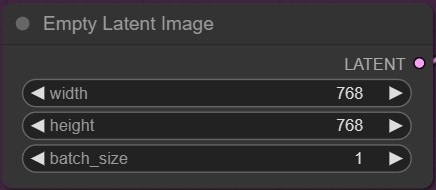
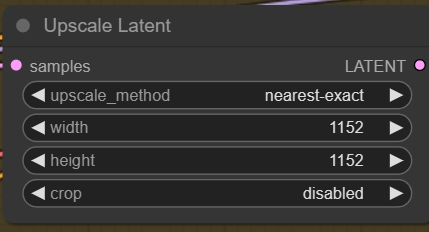
初始图像生成出来是768768,导入到Upsacle Latent后就会按照设置的尺寸放大到11521152。

当然还有一个类似的组件叫做Upscale Latent By,可以按照填入的倍数缩小或放大图片:
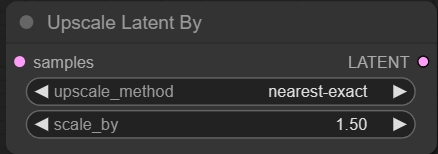
而上述的这两种放大都只是单纯的拉伸图片的尺寸,并不会添加任何细节,所以在放大之后Latent还要放进后续的KSampler里进行加工。
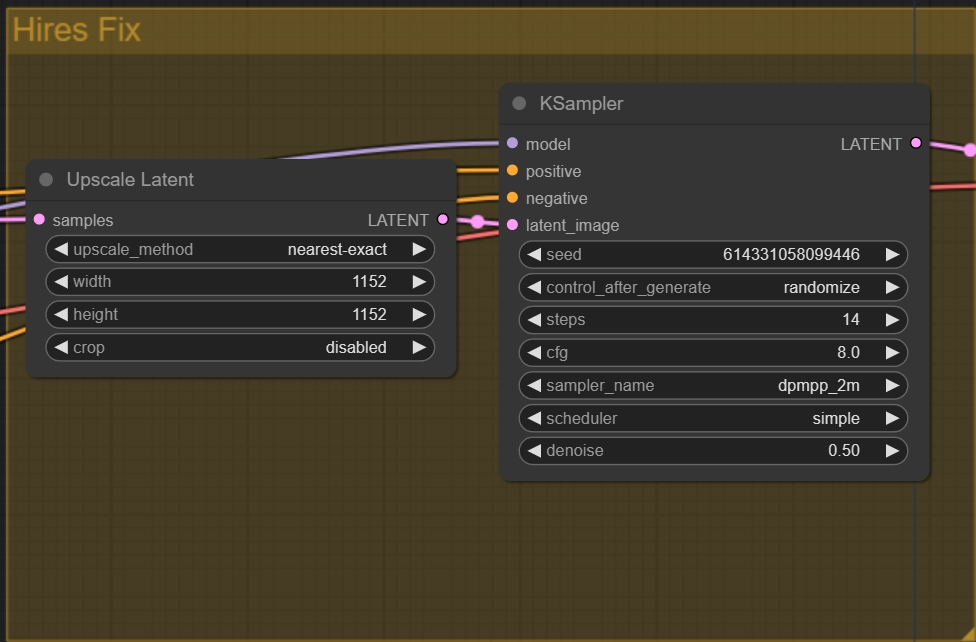
Ksampler会再进行一次采样,然后输入到最终的Save Final Image里进行解码成图:
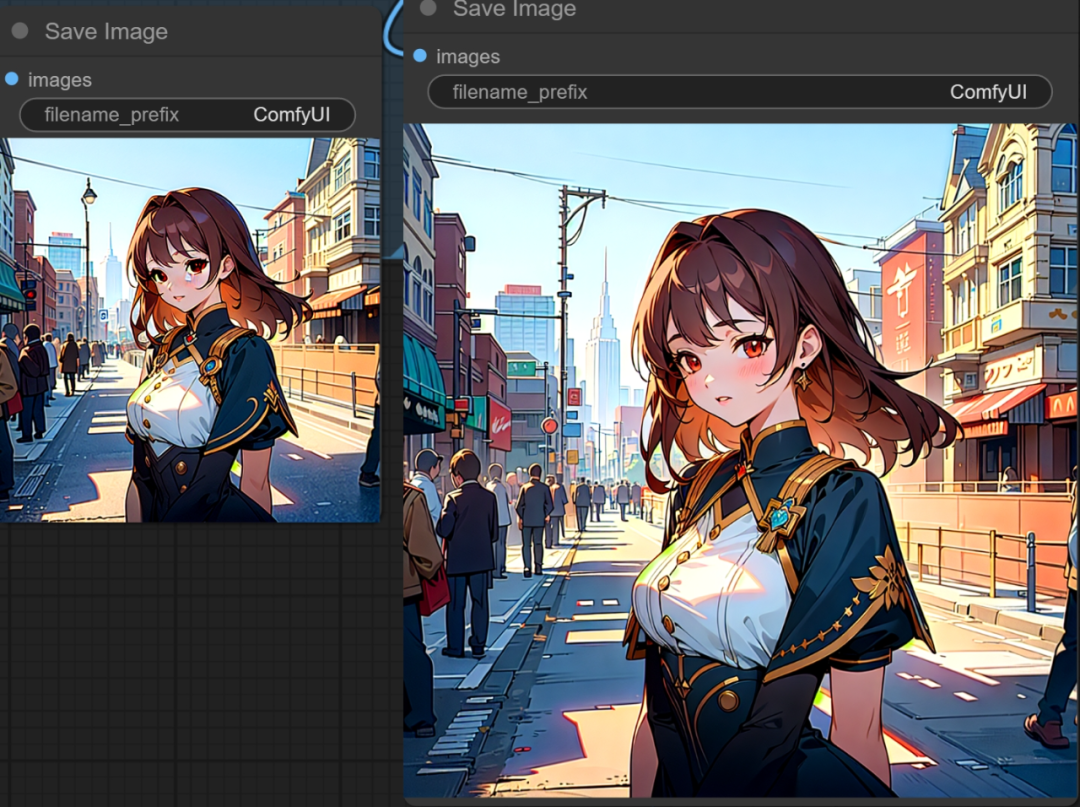
细节上的差距还是很明显的

而在这个过程中最重要的参数是Denoise ,这个参数直接决定了第二次生成时去噪的“力度”
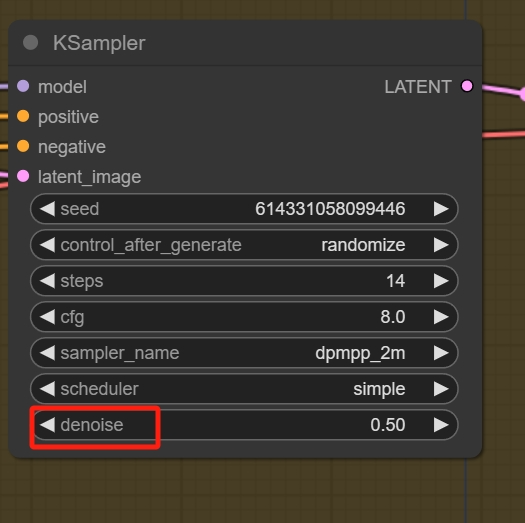
在之前的笔记中将高清修复比喻是将文生图的图片“打回来”重新图生图一次,而这个Denoise可以看作是第二次“图生图”时的重绘幅度,这个重绘幅度越大,第二次生成的结果就和第一次越不像,数值到1.0就相当于是一张新的图了(推荐在0.5-0.8)。

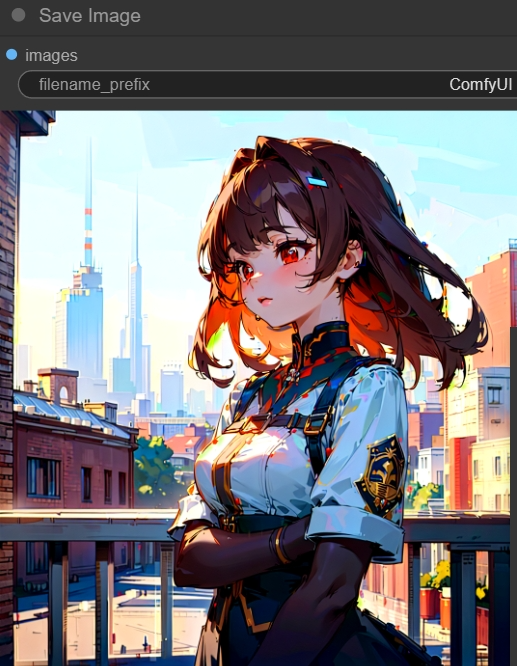
最低0.5是因为如果重绘幅度太低的话会容易出现去噪没去干净的情况:
当然有的时候画面太复杂的话0.5的重绘幅度可能导致画面出现多手多脚的情况出现,这里就可以用到另一个工作流。
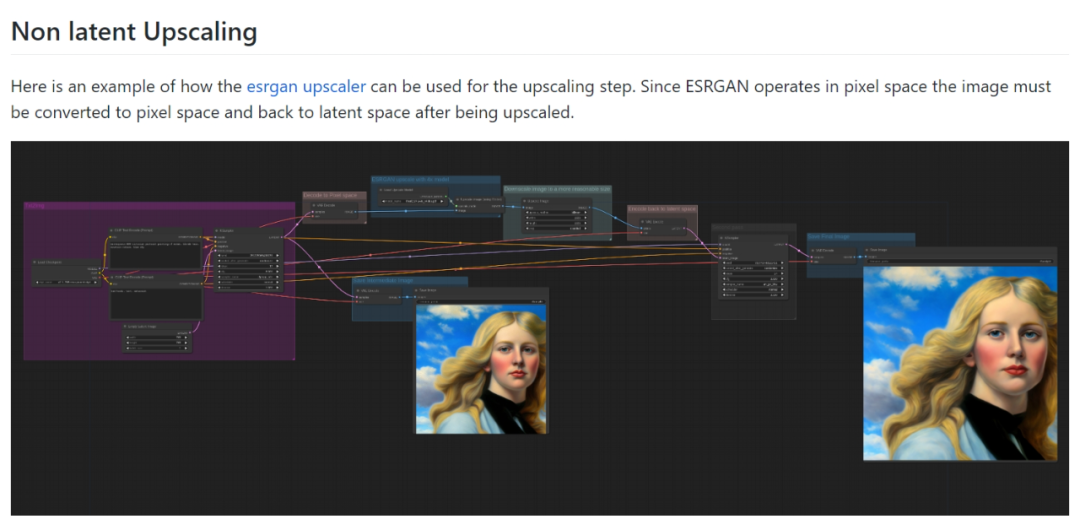
还是上面网页的第二张图
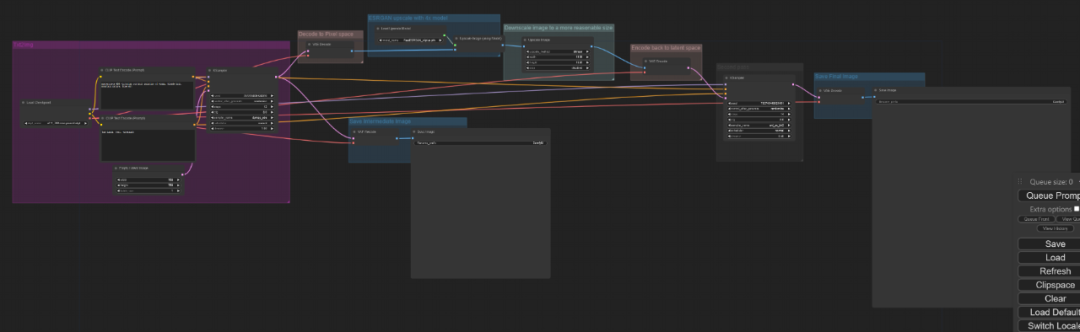
这个工作流机会稍微复杂一些,在最左侧紫色框中第一次采样的结果会先经过一次解码输出成一张图片,然后再把图片输出到ESRGAN upscale with 4x
model使用模型放大的节点里进行放大。
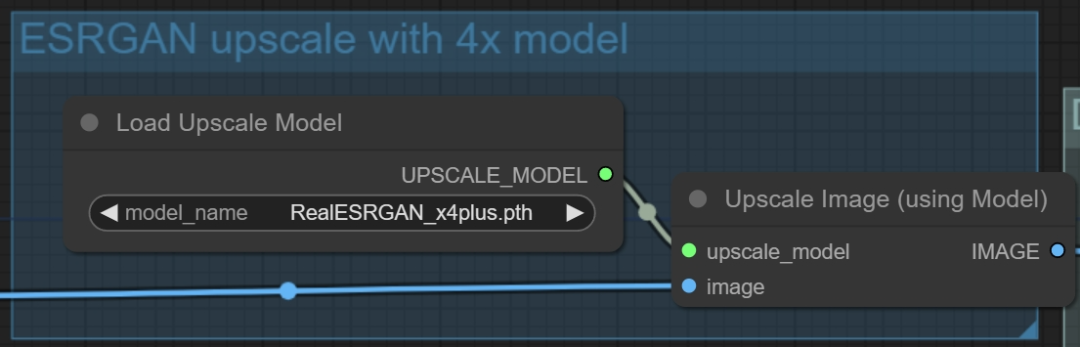
不过在此之前会先用Load Upscale
Model放大模型加载器,用这个节点加载一个专门用于图片放大的传统超分辨率模型,进过这个放大器处理之后,输出的图片会再经过Upscale
Image的节点调整到最终的尺寸。

其实这个东西的作用和刚刚的Upscale
Latent差不多,不过严格上来讲一个操控的是潜空间的数据,另一个则是像素空间里的图片数据。之后得到的图片再进入到下图的VAE编码节点里重新转化为Latent数据进行采样。
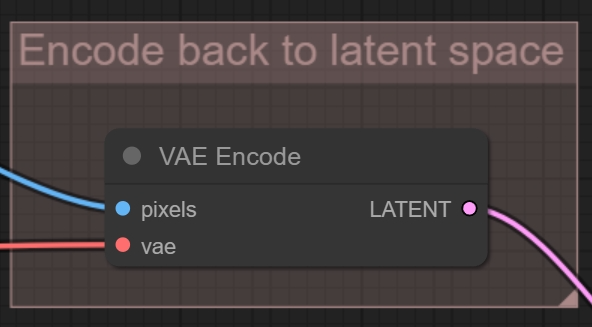
在这个工作流中即使是以0.2-0.3这样的低去噪幅度进行二次采样都不会出现噪声痕迹,究其原因是因为先把图片内容给固定了,然后再用专门的超分放大模型进行放大,这些模型不会轻易改变图片原有的内容。

当然这个工作流对于配置较低的设备容易爆显存导致加载速度很慢,而且这个传统模型放大很难给图片增加细节,所以并不是无脑选择这个放大方式就好,还得根据实际情况做决定。

图生图放大:

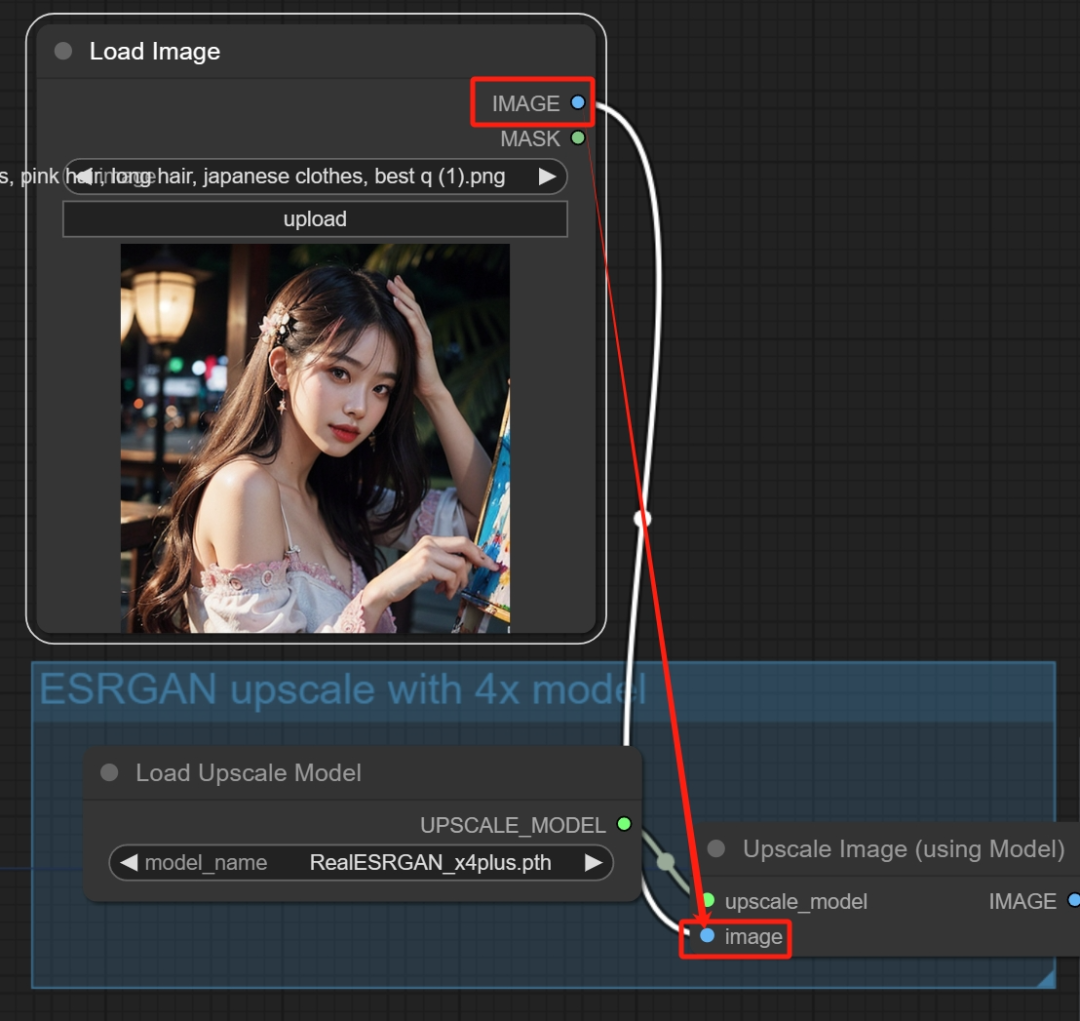
其实图生图放大只需要对原有的工作流进行些许修改即可,像是刚刚使用的传统工作流:
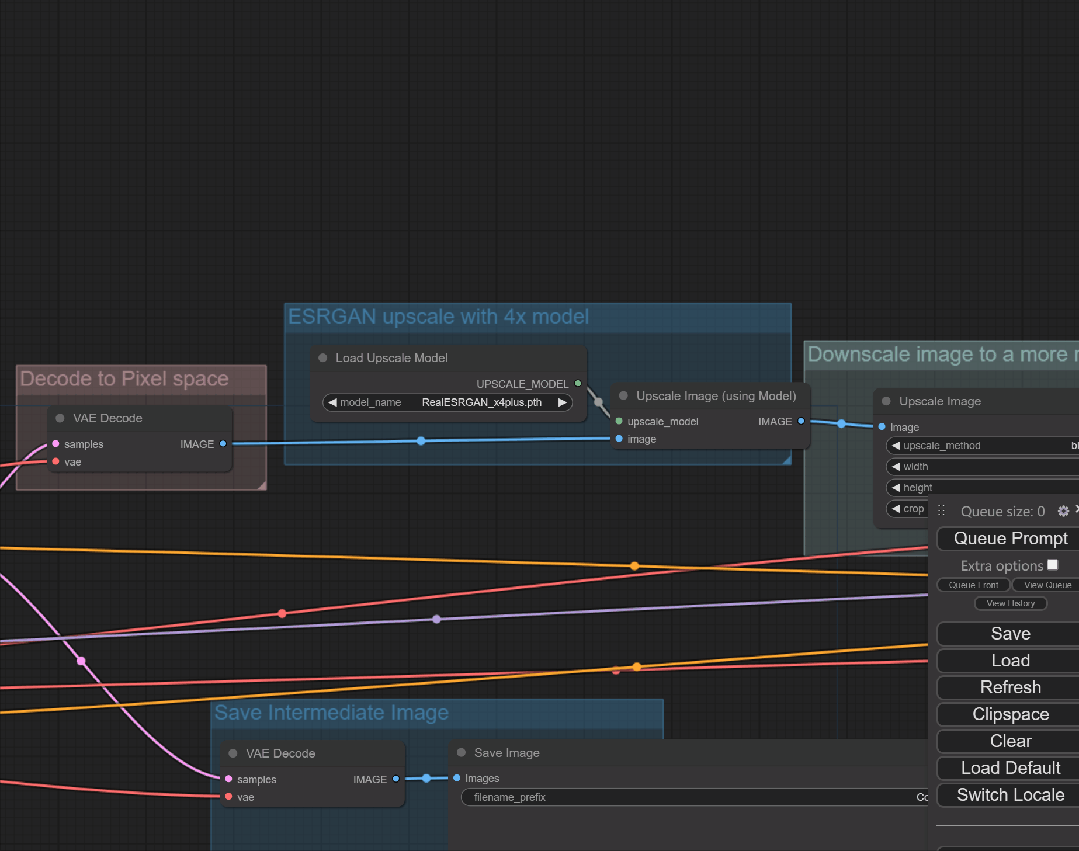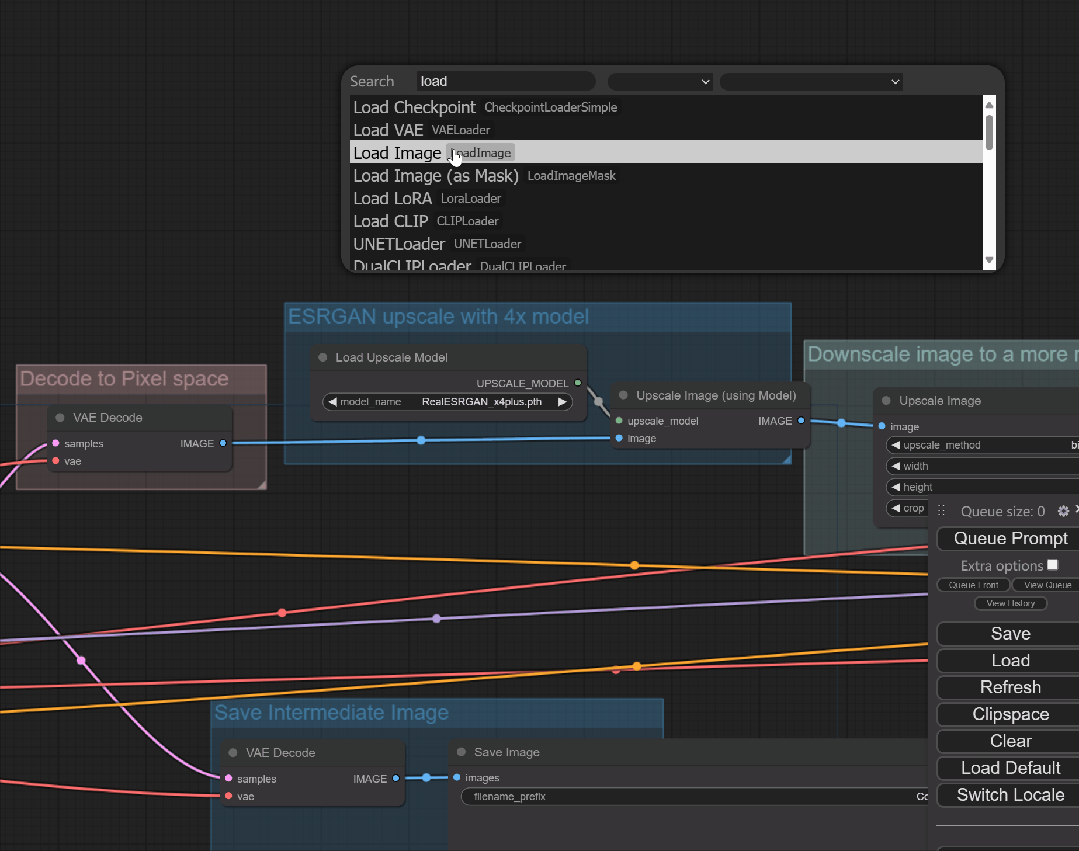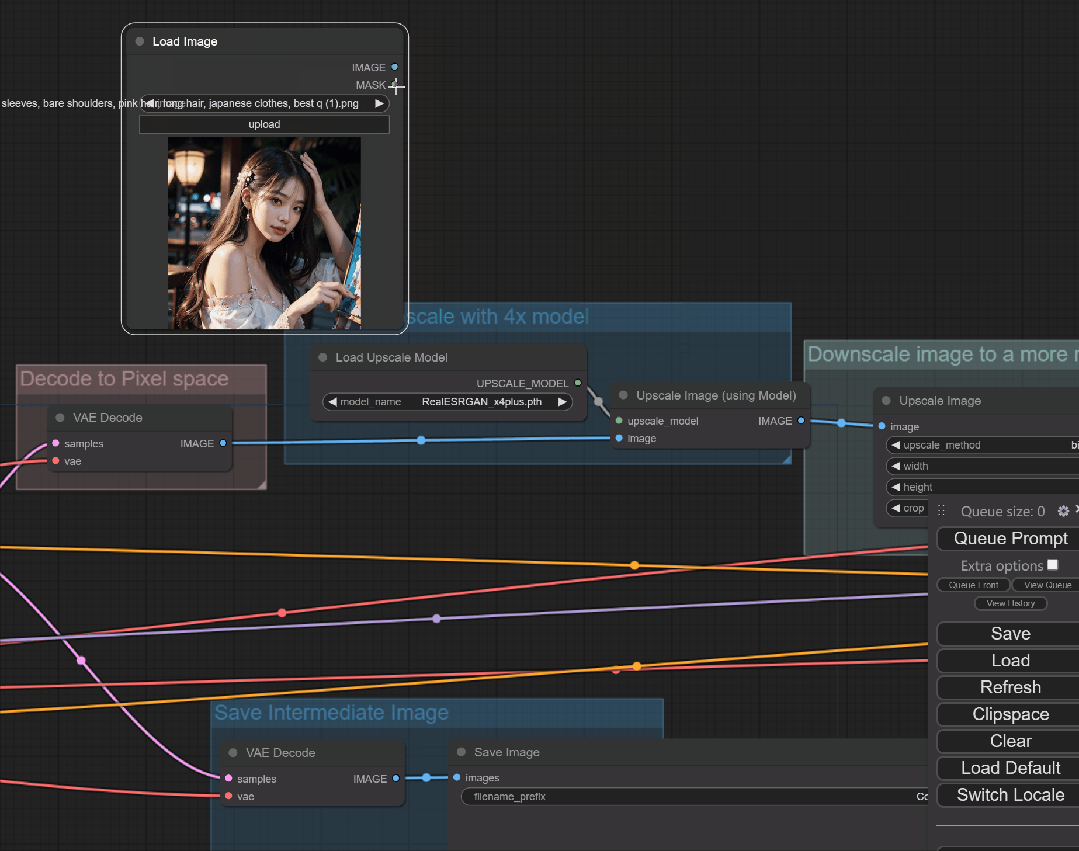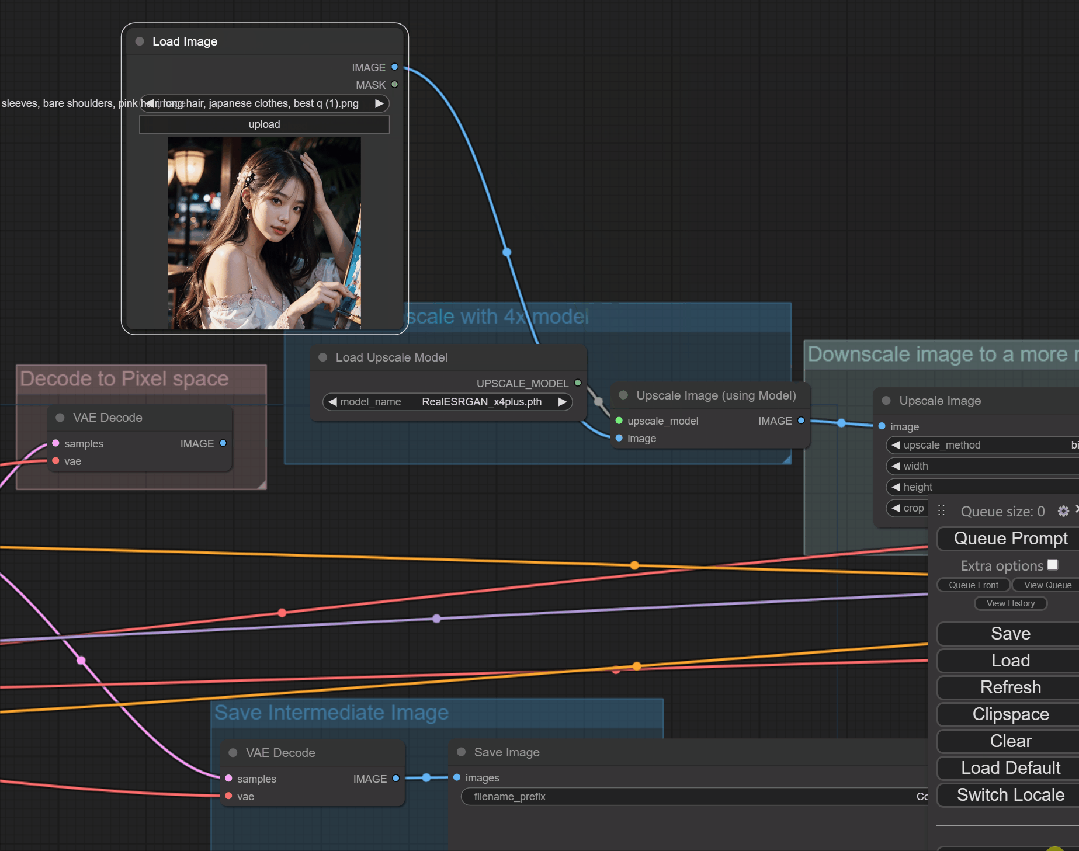
只需要双击空白地方,输入Load Image后将Image的节点与Upscale Image的image节点相连接即可。
而第一个用的工作流就更简单了:
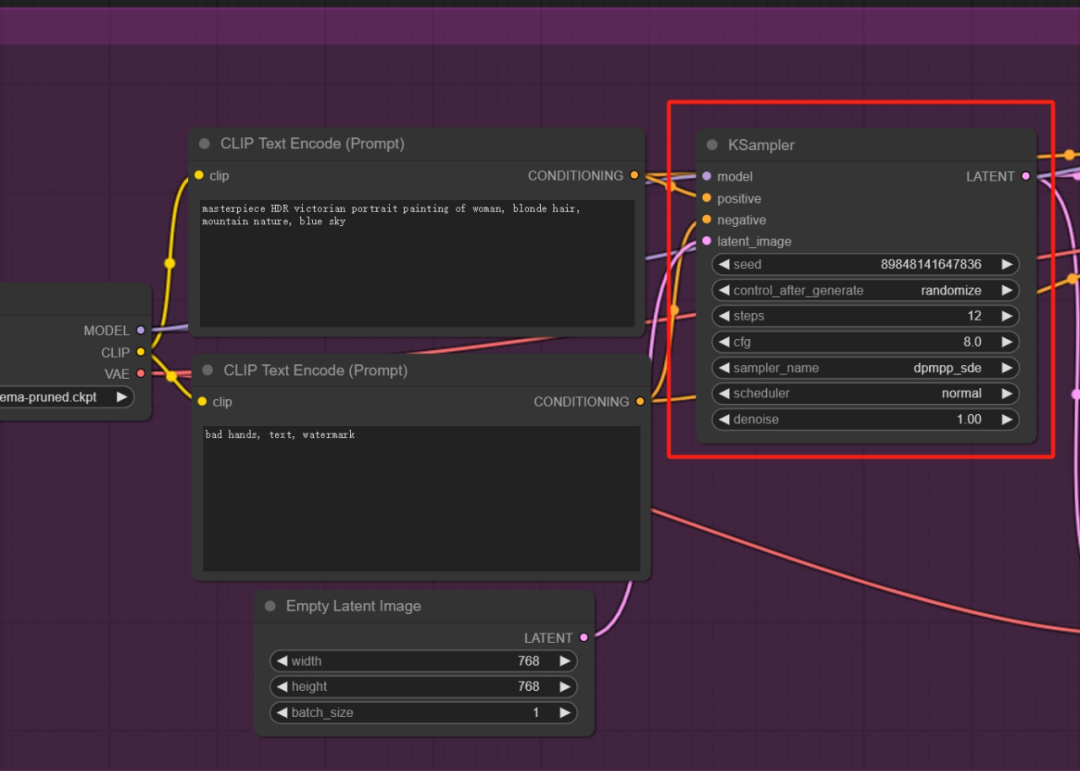
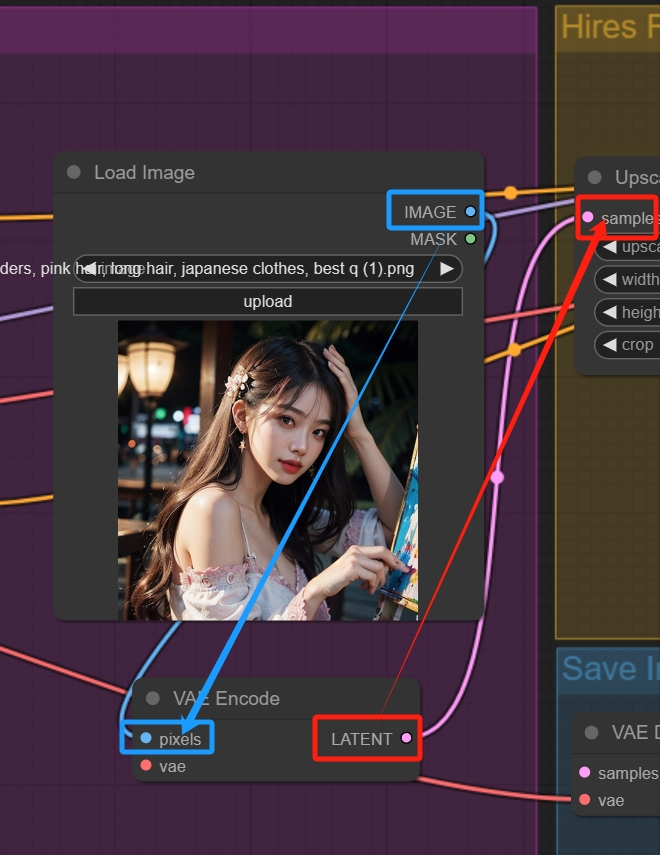
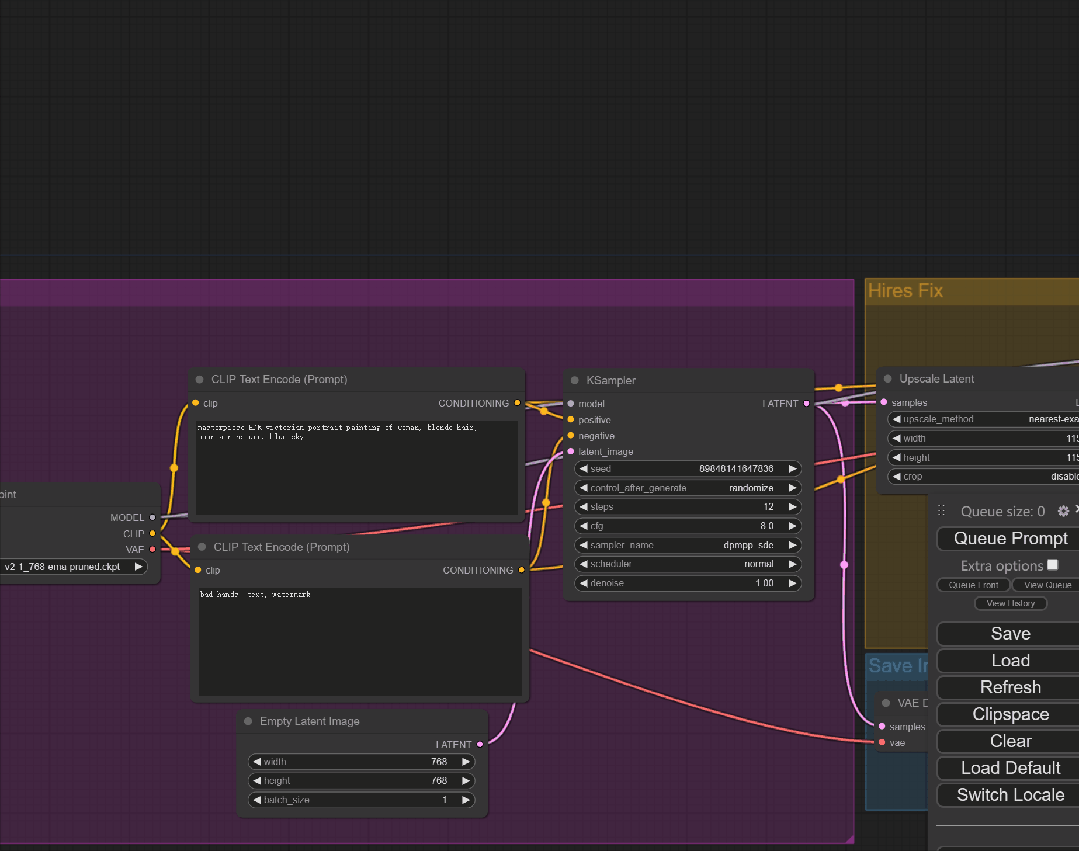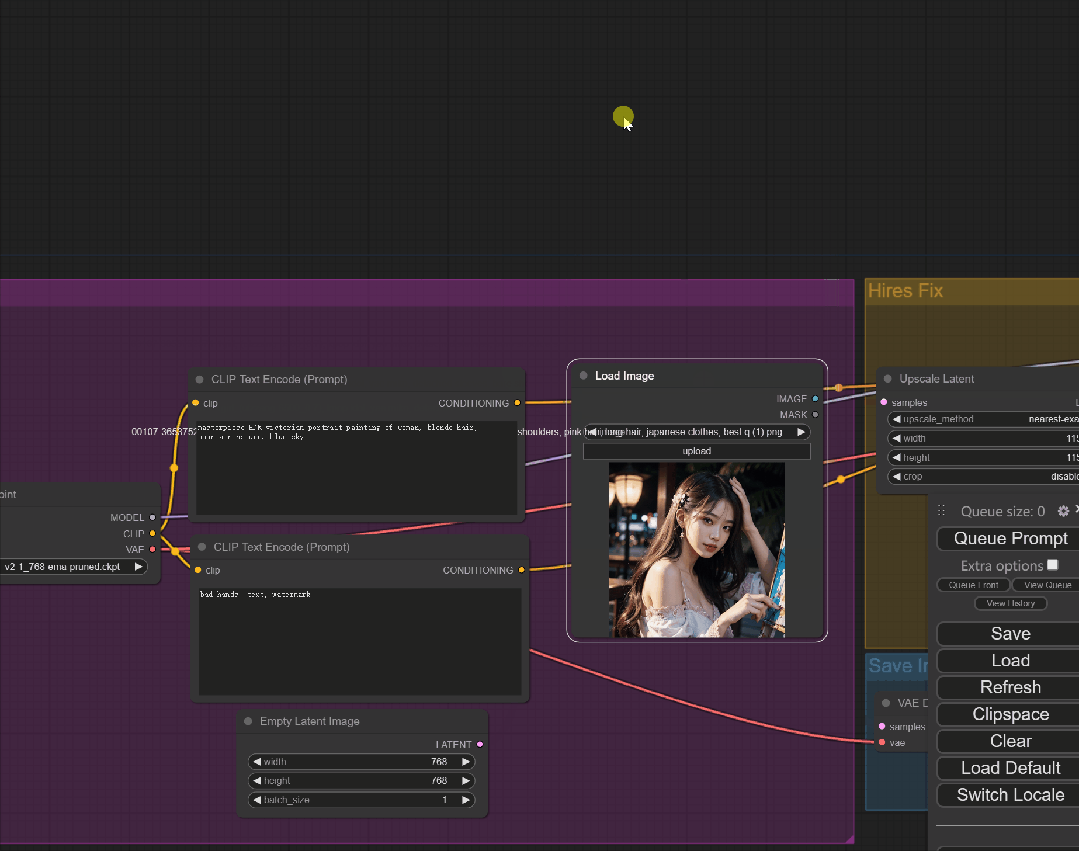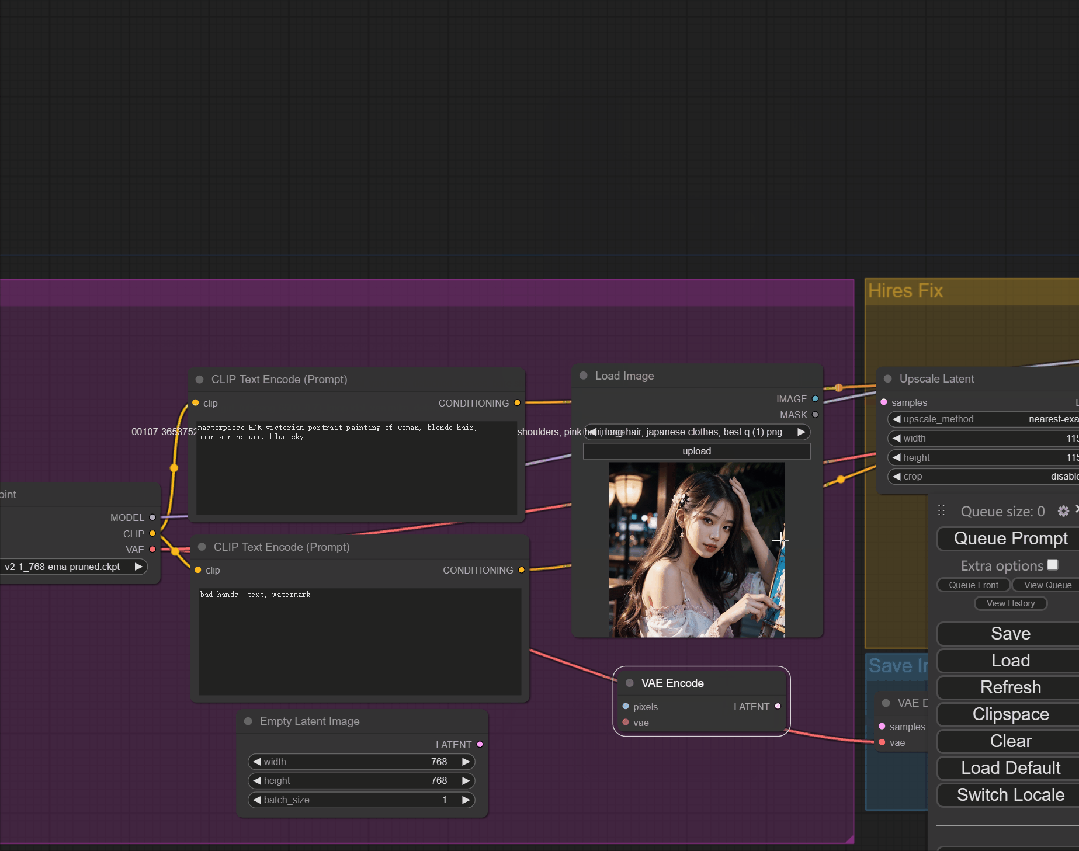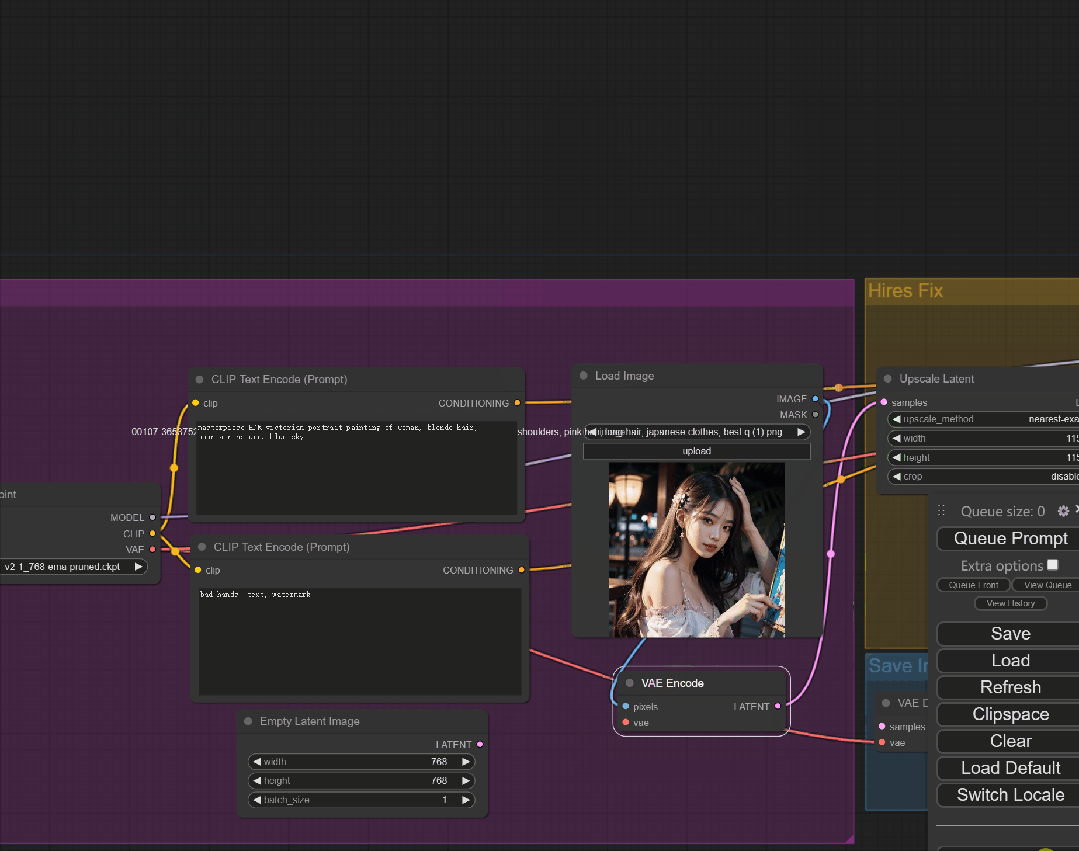
选择KSampler删除掉,然后还是创建一个Load Image的节点和一个VAE Encode节点,之后按照下图连接即可。
后期处理:

其实还有最后一种放大方式,后期处理就相当于是不带二次采样的放大模型放大。

=
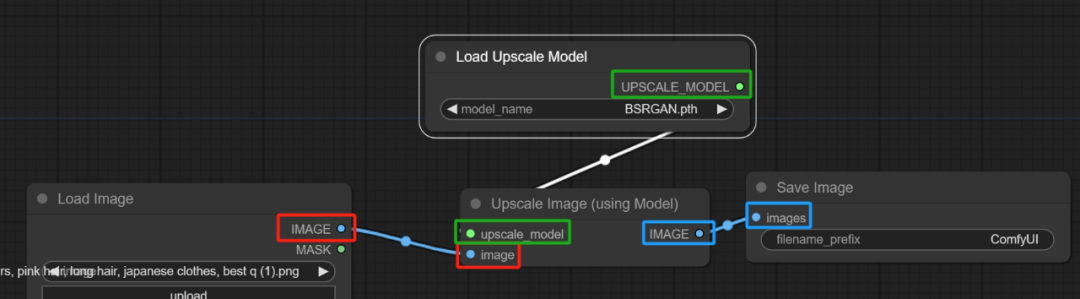
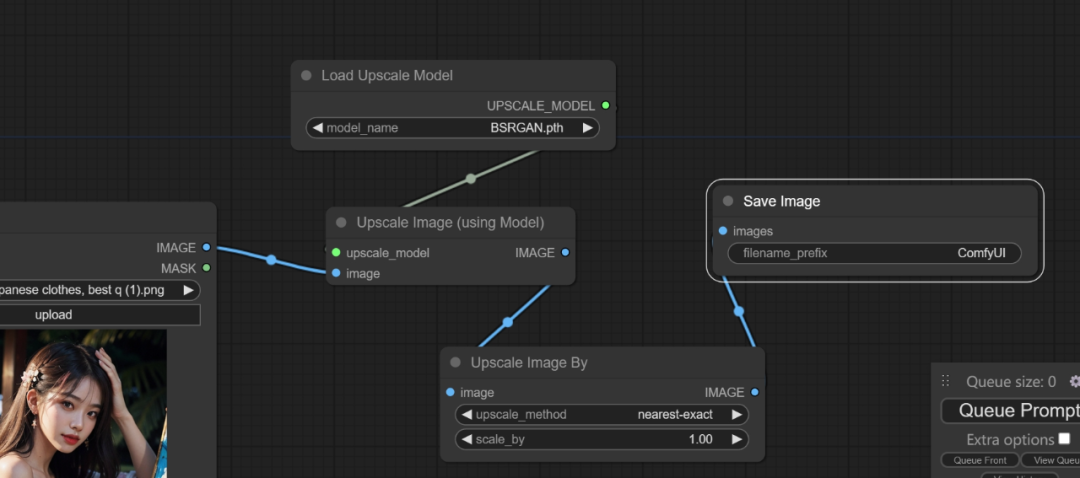
这个就更简单了,搜索加载Load Image、**Upscale Image(using Model)、Load Upscale Model
和
Save Image节点** 。

  • 将Load Image的IMAGE 与Upscale Image的image 链接起来

  • Upscale Image的upscale_model 与Load Upscale Model的UPSCALE_MODEL 连接起来

  • Upscale Image的IMAGE 与Save Image的images 连接起来

如果要设置放大倍数的话还可以添加一个Upscale Image By的节点:
在熟练运用以上的功能之后就可以把高清放大当做零件一样塞进任意一个工作流中啦。

如果自己的设备条件不是很好的小伙伴可能会遇到爆显存的问题,这里可以看一下文末的原教程视频中9:25-11:06部分,之所以我没在这里将是因为这个插件我这会下载不了。
今天的内容就到这里结束啦!

其实还是蛮有趣的,当然我都学完一部分了不有趣我也得接着学。

那么大伙下篇笔记见,拜了个拜!
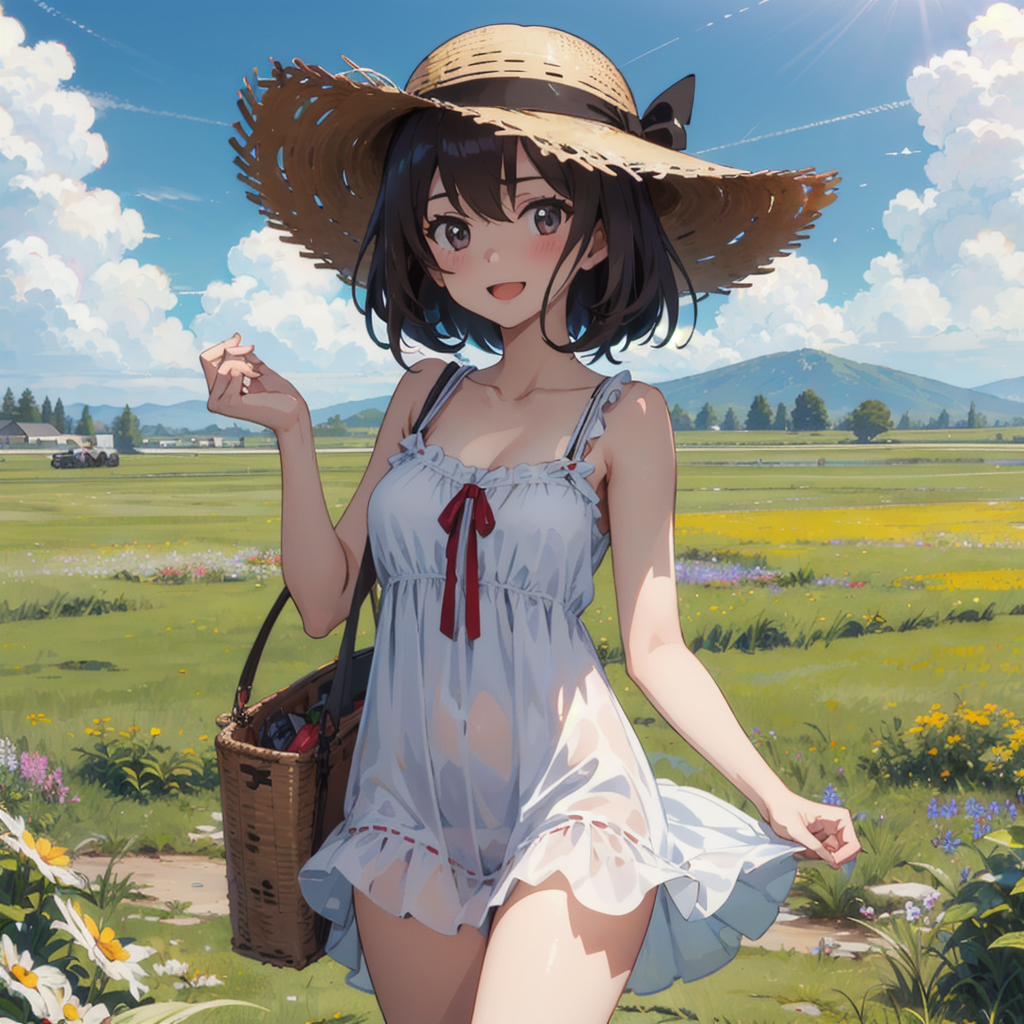
masterpiece, best quality, 1girl, solo, girls und panzer,medium breasts,
straw hat,(sundress:1.4), looking at viewer, :d, blush, cowboy shot, grass
field, landscape, blue sky <lora:Takebe Saori:0.6>

Negative prompt: EasyNegative, (worst quality:1.4), (low quality:1.4)

  • Steps: 30

  • Sampler: DPM++ 2M Karras

  • CFG scale: 7

  • Seed: 964816728

  • Size: 512x512

  • Model hash: f27c78faa6

  • Model: tmndMix_tmndMixVIPruned (1)

  • Denoising strength: 0.7

  • Clip skip: 2

  • Hires upscale: 2

  • Hires upscaler: R-ESRGAN 4x+ Anime6B

  • Version: v1.8.0

但由于AIGC刚刚爆火,网上相关内容的文章博客五花八门、良莠不齐。要么杂乱、零散、碎片化,看着看着就衔接不上了,要么内容质量太浅,学不到干货。

这里分享给大家一份Adobe大神整理的《AIGC全家桶学习笔记》,相信大家会对AIGC有着更深入、更系统的理解。

有需要的朋友,可以长按下方二维码,免费领取!

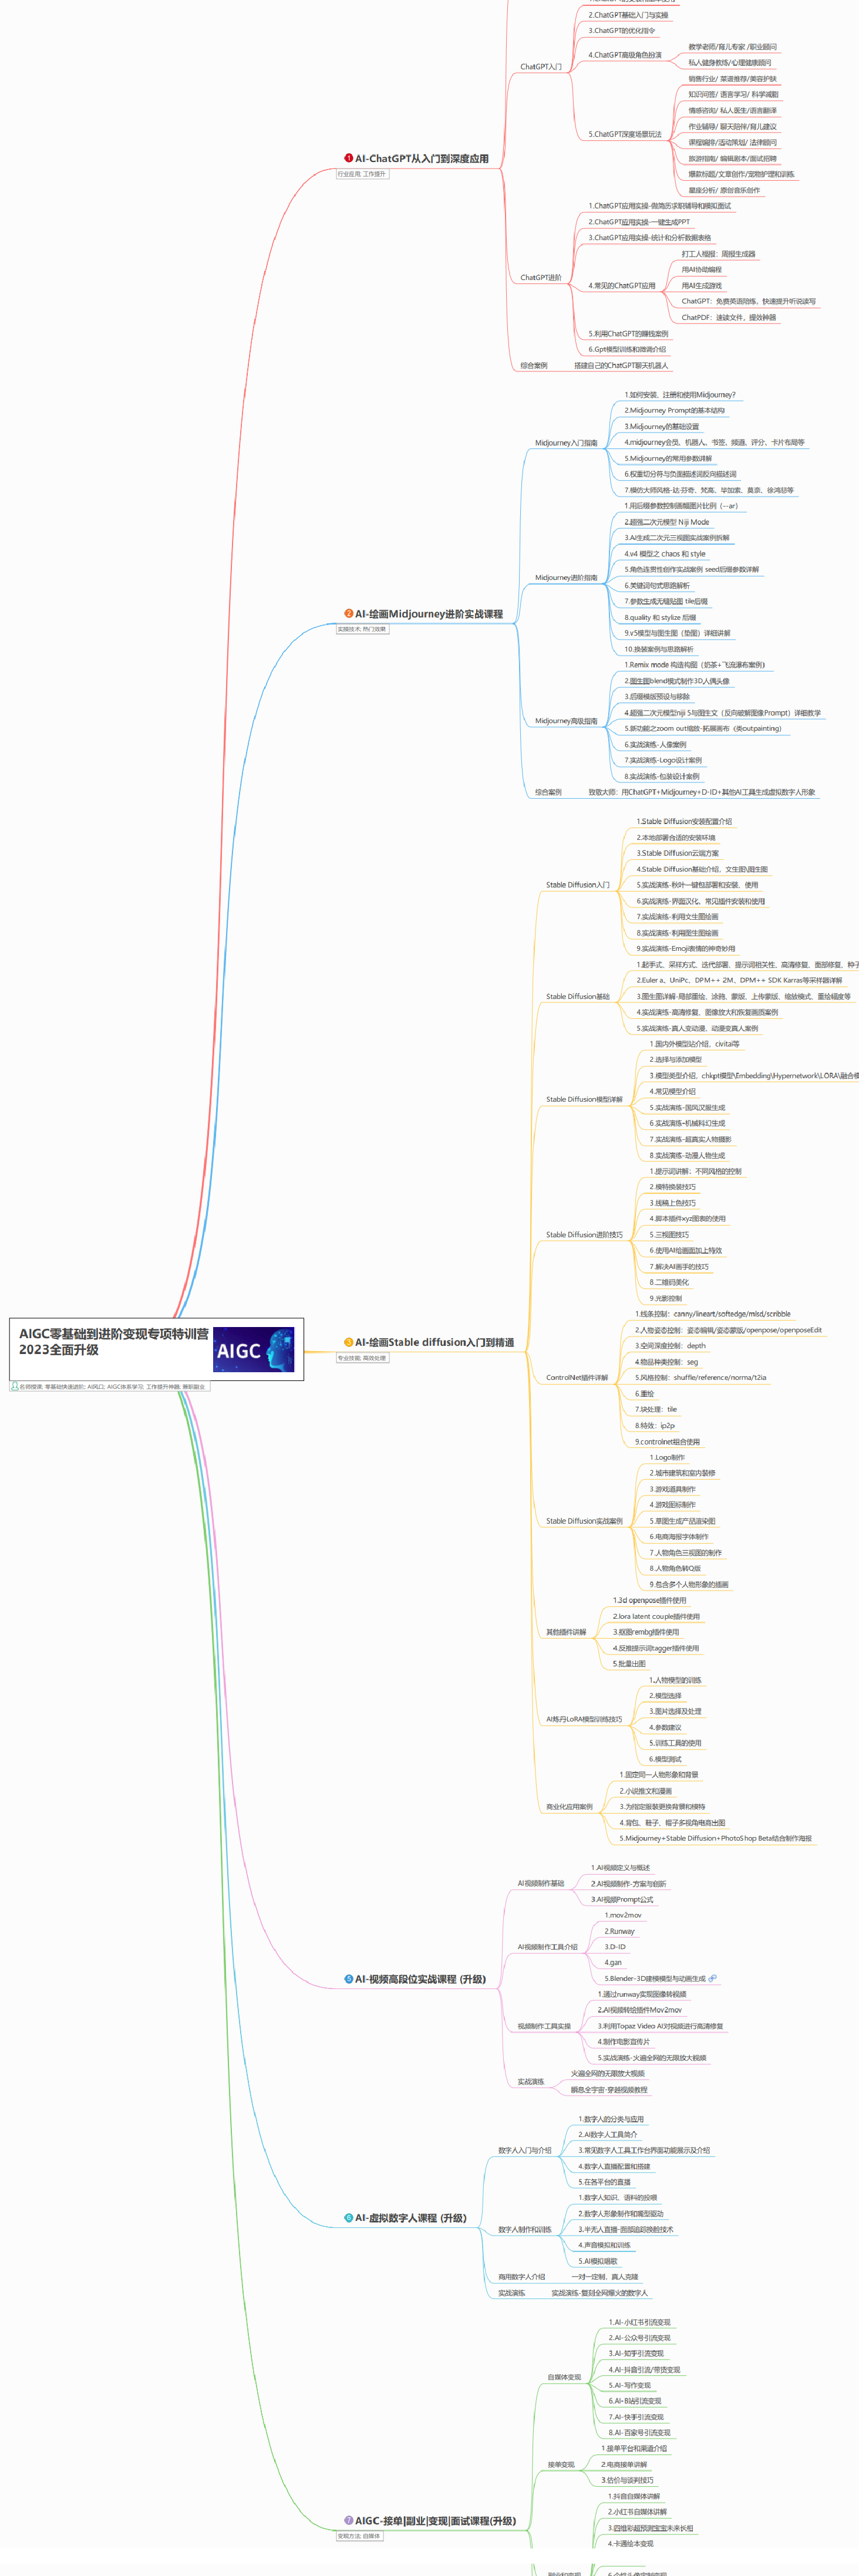
AIGC所有方向的学习路线思维导图

这里为大家提供了总的路线图。它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。如果下面这个学习路线能帮助大家将AI利用到自身工作上去,那么我的使命也就完成了:
在这里插入图片描述

AIGC工具库

AIGC工具库是一个利用人工智能技术来生成应用程序的代码和内容的工具集合,通过使用AIGC工具库,能更加快速,准确的辅助我们学习AIGC
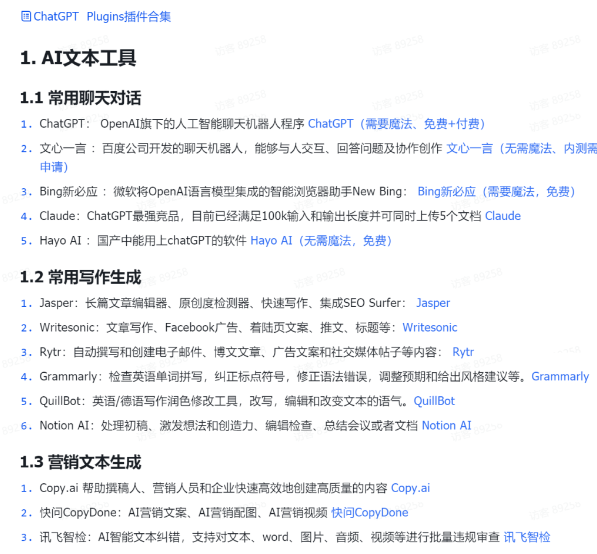
在这里插入图片描述

有需要的朋友,可以点击下方卡片免费领取!

精品AIGC学习书籍手册

书籍阅读永不过时,阅读AIGC经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验,结合自身案例融会贯通。
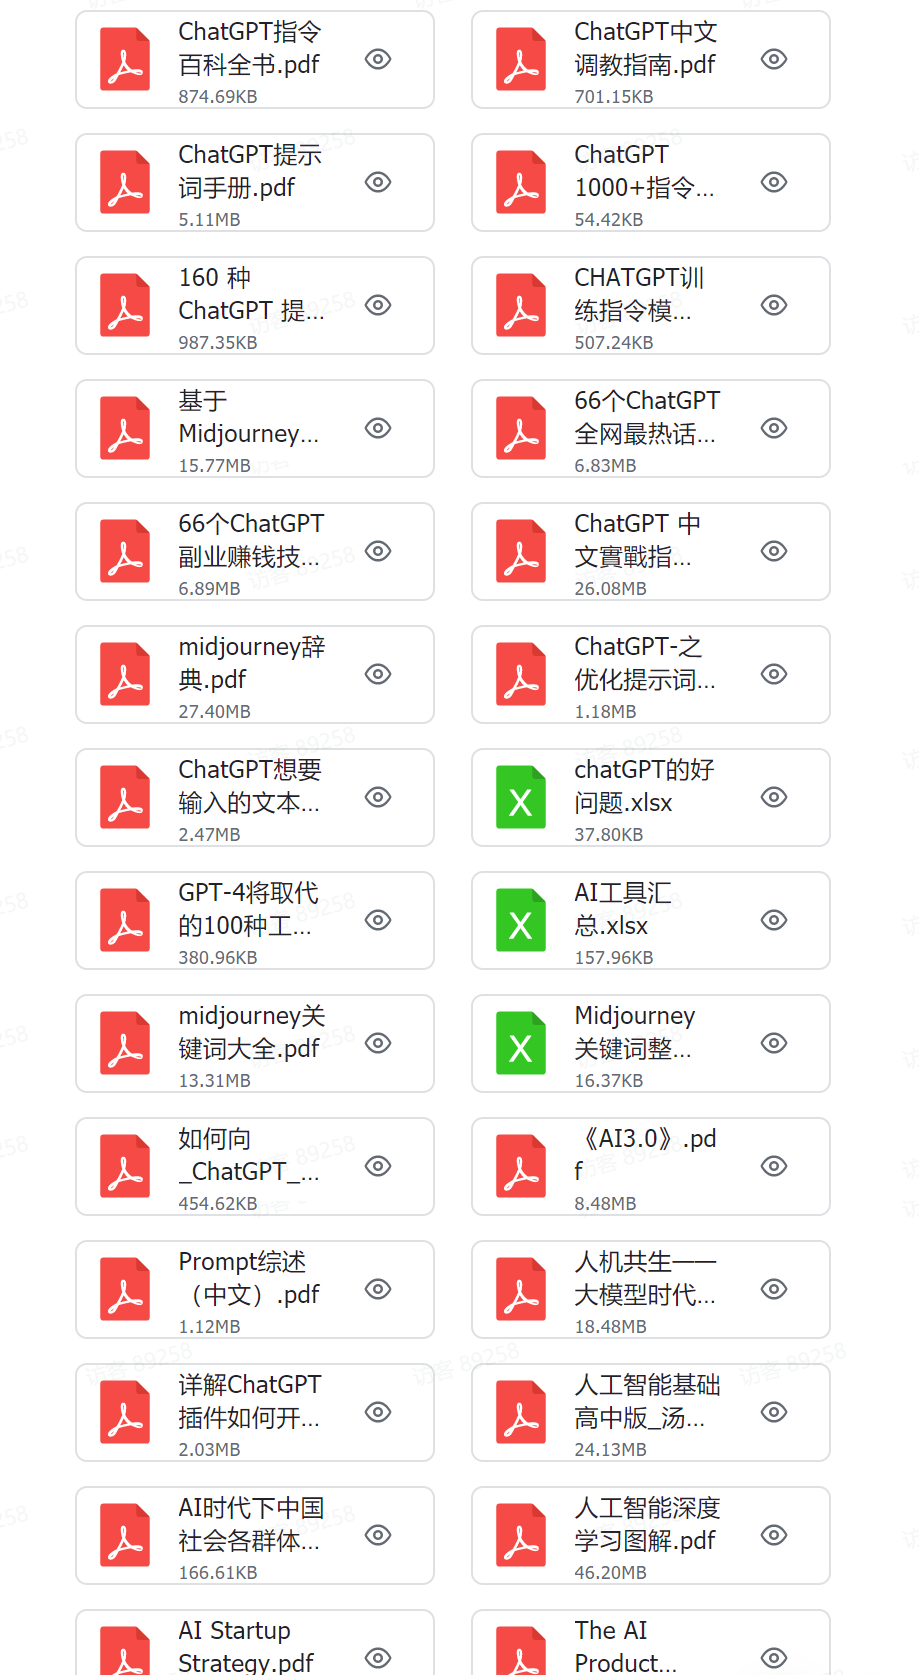
在这里插入图片描述

AI绘画视频合集

我们在学习的时候,往往书籍源码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,科学有趣才能更方便的学习下去。
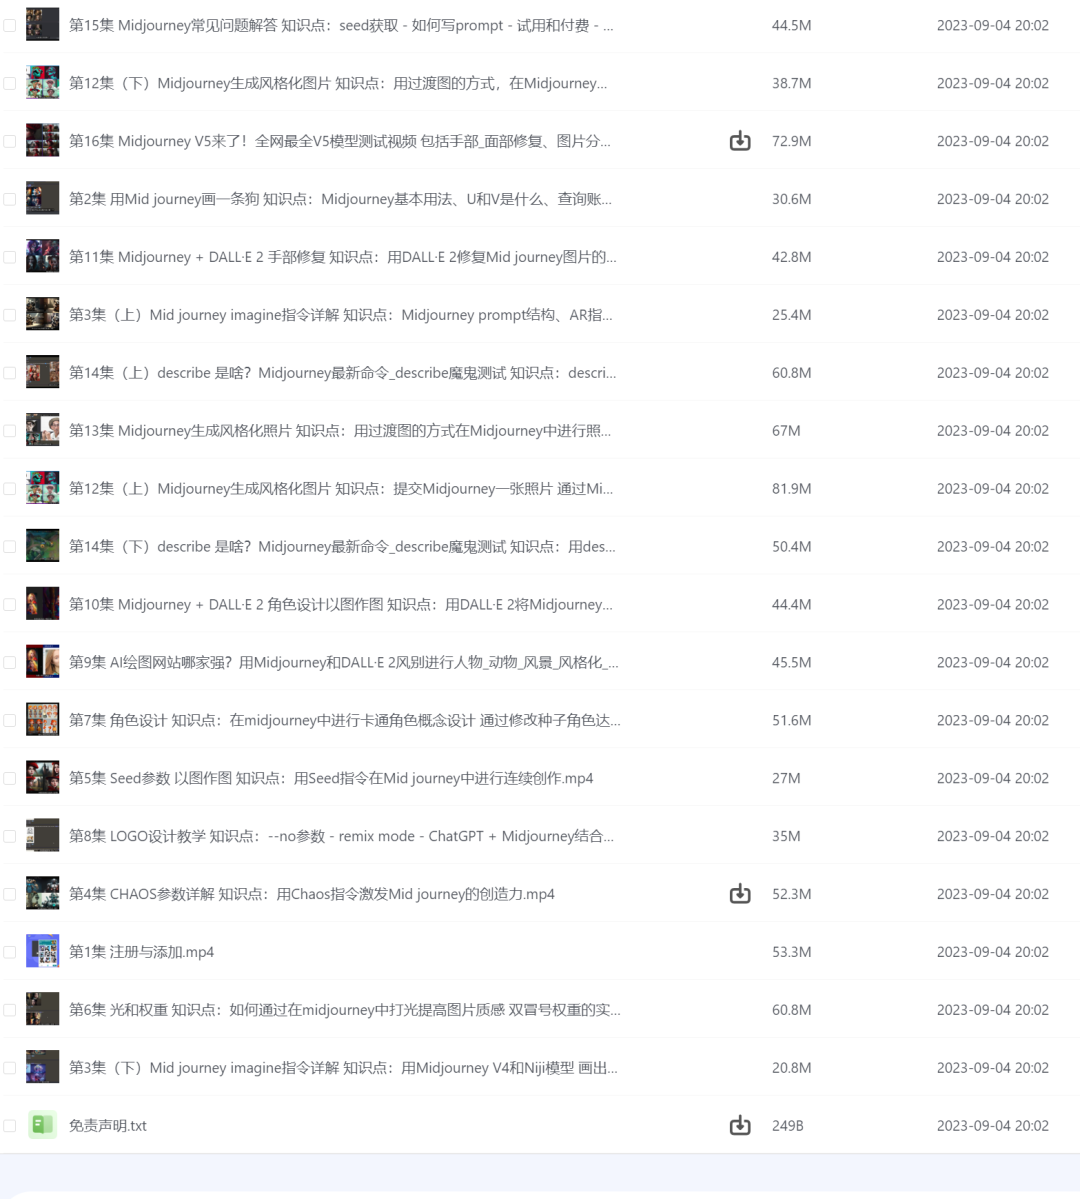
在这里插入图片描述

有需要的朋友,可以长按下方二维码,免费领取!

AI绘画:Stable Diffusion WebUI与ComfyUI该怎么选?一文对比优缺点 今天AiBot就来和朋友们一起聊一聊AI绘画两大主流工具:Stable Diffusion WebUI VS ComfyUI。看看在AI绘画上各自的优缺点和特性。 阅读详情

相关推荐

Stable Diffusion ComfyUI安装详细教程

ComfyUI安装详细教程(附资源下载链接)

欢迎关注免费星球ComfySpace:https://t.zsxq.com/19H0cfM1O 5982

【2025最新】ComfyUI图片高清放大终极方案|4种无损放大工作流详解

今天我们用4种方法实现Comfyui中的图片高清放大功能,不仅能实现图片的壁纸级别的无损放大,还能自动补全图片细节,让细节更丰富,关键是方法非常简单。

Trb701012的博客 5409

AI绘画工具Stable Diffusion+ComfyUI的配置

专为 macOS 用户设计的简化版 Stable Diffusion 应用,易于安装和使用。

2401_83048197的博客 2106

【粉丝福利社】AI绘画:Stable Diffusion ComfyUI的艺术

2022年8月,Stable Diffusion开源发布,经过两年的多次迭代升级,涌现出了如SD1.5、SD2.1、SDXL、SD3等经典版本,目前已进入较为成熟的阶段。2024年8月,Flux横空出世,让AI绘画翻开了新的篇章。考虑到模型生态、插件支持及画质表现,本书主要基于SDXL模型进行撰写。快手的Kolors模型(采用了SDXL模型架构)已经开源,支持中文提示词,能够生成优质的中国元素图像。

愚公智库 14万+

ComfyUI 对图片进行放大的不同方法

《ComfyUI图片放大方法详解》摘要 本文介绍了ComfyUI中三种主流图片放大方案:1)像素重新采样法(UpscaleImageBy节点),保持原图内容但易产生马赛克;2)SD二次采样法(k-Sampler节点),通过潜空间处理生成细节变化的新图像,需注意denoise值设置;3)专用模型放大法(UpscaleImage节点),需下载对应放大模型至upscale_models目录,速度快但细节稍逊。教程包含具体工作流配置说明、模型下载路径及插件推荐,特别强调二次采样时denoise参数需设为较小值(非1

云域A的博客 540

ComfyUI 基础教程(九):HiRes_Fix高清修复

高清放大,是AI绘画和视频处理中最为基础而又关键的特效之一。在COMFY-UI中,学会如何实现高清放大成为不可或缺的技能。

细节控-AI先行者的博客 4919

ComfyUI 3层 16倍 终极高清放大,三千字详解高清放大工作流|附工作流 文件

今个来讲讲 Stable Diffusion 终极高清放大出图,关于高清放大看这篇就够了!不管你有没有AI绘画经验,都可以跟着课程学习不会的伙计也没关系,后续的课程我将会把工作流进行封装,你只需要在页面上操作即可!这篇文章主要讲解你可以根据自己的需要挑选着阅读哦~

WANGJUNAIJIAO的博客 2202

PX4笔记系列(二)vtol_att_control中的tiltrotor解析

update_vtol_state() 注释:采用两段切换的简单逻辑来进行过渡 当切换过渡开关后,飞机将会开始倾转动力,逐渐加速,当飞机获得足够速度后动力将会完全打到向前的位置。对于过渡返回阶段动力则是简单地倾转回来。 如果(不在向前过渡指令下): 当前vtol飞行模式: 1、旋翼模式 无操作 2、固定翼模式 令vtol飞行模式切换到过渡返回模式 3、P1过渡模式 进入过渡失败安全返回至旋翼模式 4、P2过渡模式 进入过渡失败安全返回至旋翼模式 5、过渡返回模式 记录过渡返回时间=当前时间-过渡开始

hypersonicss的博客 1881

黑丝或者白丝,都可以用LoRA(Stable Diffusion进阶篇:ComfyUI 附加网络)

如果你是真正有耐心想花功夫学一门技术去改变现状,我可以把这套AI教程无偿分享给你,包含了。

Misdirection_XG的博客 917

PT32F030与MT6826S SPI通讯实战:从硬件连接到数据交互全流程解析

本文详细解析了PT32F030与MT6826S通过SPI通讯的全流程,包括硬件连接、电路设计、SPI外设初始化配置以及数据交互协议实现。通过实战案例和代码示例,帮助开发者快速掌握PT32F030与MT6826S的SPI通讯技术,实现精准的角度和速度数据采集。

weixin_29189373的博客 422

《QGIS快速入门与应用基础》230:添加图例工具

本文系统讲解QGIS图例制作的核心方法与优化技巧。首先强调图例与地图框的绑定逻辑,提出三种绑定状态及适用场景。详细拆解三种图例添加方法:布局工具栏一键添加法(新手首选)、菜单栏添加法和右键快捷创建法,并给出单地图框和多地图框两种典型场景的规范技巧。重点解决新手常见的图例杂乱、样式不规范、内容脱节等问题,帮助用户从基础图例制作进阶到符合行业标准的专业图例设计。通过分步操作图示和实用技巧,使读者能够快速掌握图例创建的核心流程与优化方法。

LuckyHanMo的博客 556

[ComfyUI]Flux TTP分块高清放大技术,效果炸裂

今天学习的时候发现一个基于Tile**的高清放**大技术,效果不输之前的Controlnet Upscaler,必须帮大家测试一波。

m0_56144365的博客 2118

海康visionmaster开发笔记10-集成HALCON第三方算子到VM工具箱的方法

海康visionmaster开发笔记10-HALCON第三方算子到VM工具箱的方法

视觉人机器视觉的博客 4350

我果然还是喜欢二次元一些(Stable Diffusion进阶篇:ComfyUI 画风迁移)

现在Stable Diffusion也能做到把一张真人的照片转绘成动漫风格,在保持人物大概形象不变的同时为图片添加合适的背景。这种操作在WebUI里面不算难,大概一分多钟就能完成这样的操作。1、首先找一张想要进行转变的图,为了比较好进行操作我找了一张总体颜色比较素的照片。然后查看这张图片的原始尺寸比例,并且在WebUI中调节生成的尺寸。2、这里需要去到Tagger这类提示词反推工具里进行该图片的提示词识别,然后点击发生到文生图将结果直接导入到文生图界面中。

2401_84760527的博客 2763

1.2 amdgpu_bo的设计分析 — gem层和ttm层

本文分析了AMD KFD的BO设计架构,重点介绍了DRM子系统中缓冲对象的多层继承关系。文章首先展示了核心继承层次图,包括DRM通用层(drm_gem_object)、TTM内存管理层(ttm_buffer_object)、AMD驱动层(amdgpu_bo)和KFD计算层(kgd_mem)。随后详细解析了drm_gem_object结构体的关键功能,包括用户空间接口管理、内存映射支持、引用计数机制以及DMA-BUF导入/导出功能。

图形/计算GPU的驱动与虚拟化技术分享园地 2554

【调优】OpenClaw从零开始高阶调优之skill篇

本文详细解析了OpenClaw技能系统的核心机制。首先介绍了技能的分层加载逻辑,按照优先级从高到低依次为:工作区专属技能、全局共享技能、出厂自带技能和自定义路径技能。通过流程图展示了从扫描到注册的完整加载流程,并解释了同名技能覆盖规则。随后深入剖析了SKILL.md文件结构,包含YAML元数据定义技能属性和Markdown正文说明使用方法,以公众号写作技能为例展示了具体配置。文章还提供了技能优先级切换的实用技巧,帮助用户灵活管理不同版本的技能。

海兰 240
上一篇: 我用stable diffusion把真人转换成了手办
下一篇: 想做AI副业的朋友来!用可灵AI一键修复老照片生成视频,即图生视频,每月挣个生活费不是问题!
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1480原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值