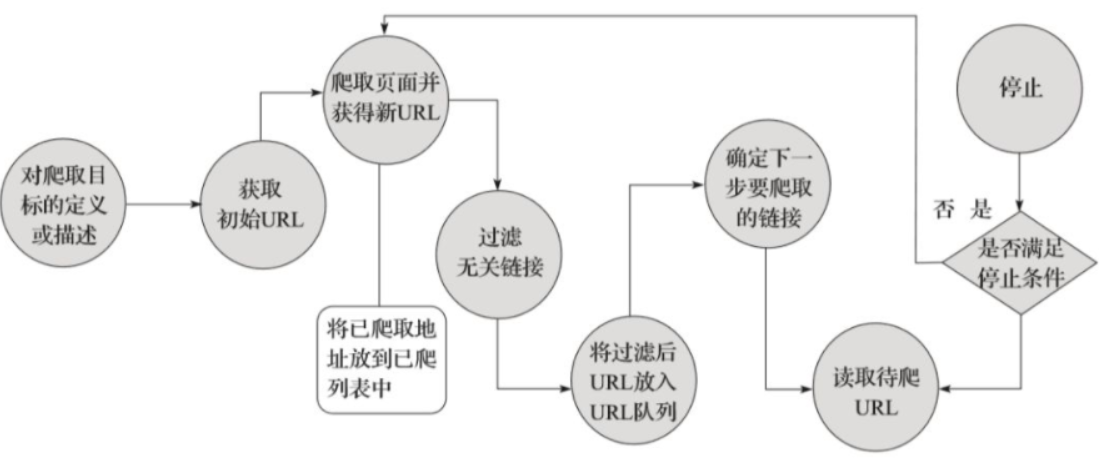
网络爬虫学习心得

2022年网络爬虫学习心得 经过一学期的网络爬虫学习,我意识到在生活中或是未来工作中,网络爬虫是我可以利用的一种高效工具。网络爬虫技术在科学研究、Web安全、产品研发等方面都起着重要作用。在数据处理方面,如果没有数据就可以通过爬虫从网上筛选抓取自己想要的数据。并且伴随着网络技术的发展,我们早已进入信息爆炸的时代,面对繁冗的数据,我们很难从里面提取到有价值的数据,为了解决传统人工收集数据的不便的问题,通过利用爬虫技术就可以轻松找到自己想要的数据。 阅读详情
AI摘要

作者出于对数据分析的兴趣学习网络爬虫,掌握了从网页提取数据的技术。学习过程涵盖网络基础、网页解析、Python 编程等知识,实践了爬虫工具与框架,完成多个实战项目,还解决了技术和非技术问题。最后总结收获,展望了爬虫技术未来趋势及个人学习计划。

一、引言​

在大数据时代,数据成为了驱动决策、洞察趋势的核心资源。出于对数据分析的浓厚兴趣,以及希望能更高效获取网络信息的目的,我踏上了网络爬虫的学习之旅。通过这段时间的学习,我不仅掌握了从网页中提取数据的技术,还深刻体会到网络爬虫在市场调研、学术研究、信息监测等领域的巨大价值,这对我的职业发展和个人能力提升有着深远的意义。
二、基础知识学习​

2.1 网络基础概念​

学习网络爬虫,HTTP 协议是绕不开的基石。我通过查阅 RFC 文档和各类技术博客,深入理解了 GET、POST 等请求方法的差异,以及 200、404、500 等响应状态码背后的含义。例如,在使用 requests 库发送请求时,requests.get(url)对应 HTTP 的 GET 请求,而requests.post(url, data=data)则用于 POST 请求 。URL 作为网页的 “地址”,其协议、域名、路径、参数等组成部分的解析,让我明白如何精准定位目标资源。相关代码示例可参考requests 官方文档示例。​

2.2 网页结构与解析​

HTML 作为网页的骨架,其标签构成的树状结构是数据提取的关键。我通过实际分析各类网页源码,熟悉了<div>、<p>、<span>等常用标签的作用。在解析网页时,CSS 选择器和 XPATH 表达式成为了我的得力工具。CSS 选择器语法简洁,适合快速定位元素,如div.container p可选中 class 为container的<div>标签下的所有<p>标签;XPATH 表达式则更强大灵活,能通过路径精准匹配,如//div[@class='article']/p可获取 class 为article的<div>下的所有<p>标签。Python 的BeautifulSoup库对 CSS 选择器支持良好,示例代码可见BeautifulSoup 官方教程 ;而lxml库在处理 XPATH 表达式上表现出色,代码示例参考lxml 官方文档。​

2.3 编程语言基础​

Python 以其简洁的语法和丰富的库,成为爬虫开发的首选语言。在学习过程中,我巩固了数据类型(列表、字典等)、控制流(if - else、for 循环)等基础知识,并将其灵活运用到爬虫逻辑中。requests库用于发送网络请求,BeautifulSoup和lxml用于解析网页,Scrapy是强大的爬虫框架,Selenium则能驱动浏览器处理动态页面。如使用requests和BeautifulSoup获取网页标题的简单代码:

import requests
from bs4 import BeautifulSoup

url = "https://example.com"
response = requests.get(url)
soup = BeautifulSoup(response.text, 'html.parser')
print(soup.title.text)

三、工具与框架实践​

3.1 爬虫工具的使用​

浏览器开发者工具是调试爬虫的利器。通过 Chrome DevTools 的 “Network” 面板,我能清晰看到网络请求的发起、响应过程,分析请求头、响应体,定位数据加载接口。Fiddler 抓包工具则能拦截、修改请求和响应数据,帮助我理解网络通信细节。在处理复杂网页请求时,利用 Fiddler 设置断点,修改 User - Agent 等头部信息,解决了部分网站的访问限制。关于 Fiddler 的使用教程可参考Fiddler 官方文档。​

3.2 爬虫框架应用​

Scrapy 框架以其高效的架构和完善的功能,极大提升了爬虫开发效率。从创建项目、定义 Item、编写 Spider,到设置 Pipeline 进行数据处理,每个环节都有清晰的流程。例如,在一个抓取新闻网站的项目中,通过定义NewsItem类来结构化数据,在NewsSpider中编写解析逻辑,使用Pipeline对数据进行清洗和存储。分布式爬虫框架 Scrapy - Redis 则让爬虫能够在多台机器上协同工作,适合大规模数据抓取场景。Scrapy 项目示例代码可在Scrapy 官方 GitHub 仓库查看,Scrapy - Redis 的使用示例参考Scrapy - Redis GitHub 仓库。​

3.3 模拟登录与 Cookie 处理​

许多网站需要登录后才能访问数据,模拟登录成为爬虫开发的重要技能。常见的模拟登录方式包括表单提交和验证码识别。对于简单的表单登录,通过分析登录请求的参数,使用requests库构造 POST 请求提交用户名和密码;遇到验证码时,可采用打码平台或机器学习模型进行识别。Cookie 在保持会话状态中起着关键作用,获取并保存 Cookie 后,后续请求带上 Cookie 即可模拟已登录状态。模拟登录示例代码可参考GitHub 模拟登录示例。​

四、实战项目经验​

4.1 简单网页数据抓取​

在抓取静态网页数据时,我选择了一些新闻网站和博客作为目标。以抓取某博客文章列表为例,首先使用requests获取网页内容,再通过BeautifulSoup解析出文章标题、作者、发布时间等信息。在这个过程中,我遇到了网页编码问题,通过指定response.encoding = 'utf - 8'解决了乱码问题。完整项目代码可在GitHub 静态网页爬虫项目查看。​

4.2 动态网页爬虫​

对于大量使用 JavaScript 渲染的动态网页,Selenium+WebDriver 是绝佳解决方案。在抓取某电商平台商品信息时,使用 ChromeDriver 驱动浏览器,通过定位元素、模拟滚动等操作,获取到了通过 AJAX 加载的商品详情。示例代码如下:​

from selenium import webdriver
from selenium.webdriver.common.by import By

driver = webdriver.Chrome()
driver.get("https://example.com")
# 定位元素
product_name = driver.find_element(By.CSS_SELECTOR, '.product - name').text
print(product_name)
driver.quit()
4.3 反爬虫机制应对​

在爬虫实践中,我遭遇了多种反爬虫策略。面对 IP 封禁,我搭建了 IP 代理池,通过随机切换代理 IP 突破限制;对于 User - Agent 检测,构建 User - Agent 池,每次请求随机设置请求头中的 User - Agent;在验证码识别方面,尝试了 Tesseract OCR 和第三方打码平台。反爬虫应对代码示例可在GitHub 反爬虫策略项目查看。​

五、学习过程中的问题与解决​

5.1 遇到的技术难题​

网络请求失败是常见问题,可能是网络不稳定、目标网站拒绝访问等原因。通过检查请求头、响应状态码,使用代理 IP 等方式逐步排查解决。复杂网页结构解析时,嵌套层级深、元素属性不唯一等问题增加了解析难度,通过结合 CSS 选择器和 XPATH 表达式,以及观察网页规律来定位元素。​

5.2 非技术问题​

学习过程中,面对复杂的技术难点,焦虑情绪时常出现。我通过制定学习计划,将大目标拆解为小任务,逐步攻克难点,同时与技术社区的同行交流,分享经验,调整学习心态。在学习进度与深度的平衡上,初期以快速入门掌握基础为主,后期针对感兴趣的方向深入研究。​

六、总结与展望​

6.1 学习网络爬虫的收获与成长​

通过这段时间的学习,我从对网络爬虫一无所知,到能够独立开发功能完善的爬虫程序,技术能力得到了显著提升。同时,培养了问题解决能力和逻辑思维,也明白了数据合规使用的重要性。​

6.2 网络爬虫技术的未来发展趋势​

随着人工智能技术的发展,智能爬虫将更加普及,能够自动识别网页结构、处理复杂反爬虫机制。此外,对数据隐私和安全的重视,也将促使爬虫技术向更合规、更可控的方向发展。​

6.3 个人后续学习计划与目标​

未来,我计划深入学习机器学习在爬虫中的应用,如自动识别验证码、智能解析网页。同时,研究更多分布式爬虫技术,提升大规模数据抓取能力。并且,持续关注行业动态和法律法规,确保爬虫技术的合法合规使用。

网络爬虫学习心得1 这段时间看了唐松老师写的《python网络爬虫从入门到实践》,学到许多网络爬虫方面的知识,也以书里的实践项目进行练手。 我的第一篇的网络爬虫心得,就以书里第五章的实践:爬虫实践:房屋价格数据,参考书里的内容进行练手。 实践项目是获取安居客网站上北京二手房的数据。本项目需要获取前10页二手房源的名称、价格、几房几厅、大小、建造年份、联系人、地址、标签。网页地址为:http://beijing.anj... 阅读详情

相关推荐

啵591_2022年网络我的网络爬虫学习心得

基于python的数据爬虫

weixin_66580518的博客 1438

写一段网络爬虫学习心得,三百字左右

我在学习网络爬虫的过程中,发现它是一门非常有趣的技术. 通过网络爬虫,我们可以轻松地收集网上的信息,并进行大规模的数据分析. 网络爬虫的基本原理是,使用程序自动地模拟人类浏览网页的行为,获取网页上的信息. 这需要我们了解网络协议,熟悉HTML/CSS等网页技术,并会使用相应的编程语言(如Python)进行编写. 在学习过程中,我深刻认识到了网络爬虫的广泛应用. 它不仅可以用于搜索引擎,还可以用于市...

weixin_35751194的博客 1351

抠肚脐眼-2022年网络我的网络爬虫学习心得

1、调用数据包#调用数据包2、对爬虫网站进行解码#对爬取网站进行解码3、调用BeautifulSoup进行爬取data=[]df4、定义标题并写入数据库df#将爬取数据转换成df数据并定义标题df.to_sql( 'newlist1', con=engine, if_exists='append') #数据写入数据库#运用sql、engine将数据写入数据库5、建立数据库并储存数据client = pymongo.MongoClient('127.0.0.1',27017) #连接mongodb。

qq_69794791的博客 867

Python 网络爬虫学习心得

学完这些知识,动手实践才是关键。比如爬取静态博客网站文章,用 Requests 发 GET 请求,BeautifulSoup 解析标题、正文;模拟登录论坛(POST 请求),再爬取个人帖子。过程中,会遇到反爬(比如请求频率限制,得加延时)、网页结构变化(解析逻辑失效,要重新分析页面)等问题,解决它们的过程,就是技术提升的过程。同时,得牢记爬虫伦理和法律。爬取公开、非敏感数据,遵守网站robots.txt协议(访问网站查看规则,比如有些页面禁止抓取 ),别给服务器造成过大压力,做 “文明爬虫”。

m0_55237808的博客 1594

Zabbix Trigger actions访问出现500

本篇博客详细介绍了Zabbix访问'Trigger actions'出现的错误状况,访问界面出现500,并提供了解决方案。

格子的博客 562

手把手式介绍 ADNI 影像数据下载

1.搜索 1.1登录 打开ADNI的官网:http://adni.loni.usc.edu/,进入下面的界面。 点击 DATA&SMPLES 下的 ACCESS DATA AND SAMPLES,如下图。 页面跳转以后点击中间的“LOGIN”,这时会跳出一个新的界面,然后在右上角输入自己的帐号、密码即可。如果没有权限可以跳转到第2部分看看如何申请权限。 登录以后选择DOWNLOAD下的 Image Collections就是搜索下载影像数据,其他还有一些学习测试数据和遗传数据。 1.2 sea

永远想不起来更新的博客 1万+

网络爬虫中 AJAX 方法的实践经验与学习心得​

学习和实践 AJAX 爬虫的过程,不仅是掌握技术的过程,更是锻炼分析问题和解决问题能力的过程。在面对复杂的 AJAX 请求时,需要耐心细致地分析请求过程,理解网页的动态加载机制。同时,要不断学习和掌握新的技术和工具,如 JavaScript 逆向工程、代理 IP 池的搭建与使用等,以应对越来越复杂的反爬虫策略。此外,合法合规地进行数据采集是每个爬虫开发者应遵守的原则,避免因不当的数据采集行为引发法律风险。​。

2401_84750872的博客 1241

Modbus 通信协议详解

Modbus是由 Modicon(现为施耐德电气公司的一个品牌)在 1979 年发明的,是全球第一个真正用于工业现场的总线协议。ModBus网络是一个工业通信系统,由带智能终端的可编程序控制器和计算机通过公用线路或局部专用线路连接而成。其系统结构既包括硬件、亦包括软件。它可应用于各种数据采集和过程监控。为更好地普及和推动Modbus在基于以太网上的分布式应用,目前施耐德公司已将Modbus协议的所有权移交给 IDA(,分布式自动化接口)组织,并成立了 Modbus-IDA 组织。

Projectsauron 的博客 7万+

网络爬虫学习心得:从入门到实践

最初接触网络爬虫时,我对它的印象停留在“自动化抓取网页数据的工具”。通过简单的 Python 脚本,就能获取互联网上的公开数据,这种能力让我感到兴奋。然而,随着学习的深入,我发现爬虫不仅仅是。​:使用代理 IP(免费代理不稳定,推荐付费服务如 Luminati),并设置随机延迟(​,争取用爬虫技术解决实际业务问题(如竞品分析、舆情监控)。爬虫技术是数据获取的利器,但需要平衡 ​。和正则表达式,它还涉及 ​。​:返回 403 或验证码。​:模拟浏览器头部信息(如。​:频繁请求后被封 IP。

2301_81228071的博客 1701

UG476 GT Transceivers文档翻译和自身理解

对UG476 Xilinx官方文档进行翻译的基础上加上自己的理解

weixin_45143788的博客 4598

(王道408考研操作系统)第三章内存管理-第一节1:内存基础知识、程序编译运行原理

注意:本节内容和《计算机组成原理》“存储器”那一部分内容相关性很强,组成原理是从硬件角度,操作系统是从软件角度。因此如果没有学习过这部分的同学,强烈建议先看这一部分 王道计算机组成原理笔记 本文主要会涉及以下必要的内存知识 文章目录一:内存及其作用 一:内存及其作用 内存:内存又称之为主存。是一种硬件设备,作为CPU和硬盘的缓冲区,用于解决其速度不匹配的问题,提高整机性能。程序执行前需要放入内存才能运行 ...

快乐江湖的博客 2792

2022年网络我的网络爬虫学习心得

主要记录我自己从开始学习Python基础、接触爬虫、初次实现爬虫,再到独立完成爬虫项目并成功爬取以海外网的过程。

m0_62021282的博客 3694

RKNN 端侧部署必看:YOLOv11 Pose 姿态估计模型转换与性能优化实战

随着人工智能技术在边缘计算领域的快速发展,姿态估计作为计算机视觉的重要分支,在智能监控、人机交互、体感游戏等场景中展现出巨大的应用潜力。本文深入研究了YOLOv11 Pose模型在Rockchip RKNN平台上的部署方案,从理论基础、模型转换、平台优化到实际部署进行了全面阐述。通过详细的技术分析和实验验证,证明了RKNN平台能够有效提升YOLOv11 Pose的推理性能,在RK3588硬件平台上实现了高达100 FPS的实时姿态检测,为边缘计算场景下的姿态估计应用提供了高效的解决方案。

m0_71589036的博客 183

ZHANG_2022年网络我的网络爬虫学习心得

2022年网络我的网络爬虫学习心得

weixin_65693493的博客 758

electron:解决打包后报错Cannot find module ‘X‘ 运行报错各种模块缺失问题(解决electron build打包后运行应用报错启动失败或白屏,无论模块名称是什么都能解决!)

Electron app打包后启动报错:“Cannot find module 'X'”解决方案,electron-builder 打包出现 cannot find module,electron 打包后找不到module问题,electron打包运行白屏、Can not find modules ‘x‘,electron项目打包报错,electron打包后,点击生成的exe应用程序出现Cannot find module,解决electron-build打包后运行app报错:cannot find mod

✅ 精选推荐文章 4385

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

初学python网络爬虫学习心得

同时介绍了常用的 Python 爬虫库,如 `Requests`、`BeautifulSoup` 和 `Scrapy`,这些工具为编写高效爬虫提供了强大的支持。通过这一阶段的学习,我对网络爬虫有了基本认知,也为后续实践打下了理论基础。在 Network 面板中,我们可以查看所有网络请求的详细信息,包括请求头、响应内容、预览等,这对于定位数据来源非常有用。由于页面是静态加载的,我们使用 `requests` 获取 HTML 源码,并用 `BeautifulSoup` 解析出帖子标题、作者、发布时间等信息。

k_k666888的博客 1651

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

2023年网络爬虫学习心得

经过一个学期的学习,我已经可以爬取出一个网页的标题,链接,正文等。Scrapy是一个基于Python的开源网络爬虫框架,是一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。下面我将介绍如何利用Scrapy进行网页信息的抓取。将新的请求发送给调度器,再从第②步开始重复执行,直到调度器中没有更多的请求,引擎关闭该网站。爬虫将抽取到的一条数据实体(Item)和新的请求(如下一页的链接)发送给引擎。爬虫(SPIDERS):最核心的组件,用于从特定的网页中提取自己需要的信息。

m0_74263521的博客 1513

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

2022年我的网络爬虫学习心得

网络爬虫学习总结及案例 一、学习心得,二、爬虫用到的pip模块以及对应的功能,三、单个网页爬虫代码及结果,四、scrapy框架爬虫,五、Gerapy搭建

qq_63195700的博客 6467

Python网络爬虫——学习心得

网络爬虫,即Web Spider,是一个很形象的名字。 把互联网比喻成一个蜘蛛网,那么Spider就是在网上爬来爬去的蜘蛛。网络蜘蛛是通过网页的链接地址来寻找网页的。 从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页都抓取完为止。 如果把整个互联网当成一个网站,那么网络蜘蛛就可以用这个原理...

代码 8474

20215672刘引平网络爬虫学习心得

经过一个学期的学习,我已经可以爬取出一个网页的标题,链接,正文等。Scrapy是一个基于Python的开源网络爬虫框架,是一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。下面我将介绍如何利用Scrapy进行网页信息的抓取。将新的请求发送给调度器,再从第②步开始重复执行,直到调度器中没有更多的请求,引擎关闭该网站。爬虫将抽取到的一条数据实体(Item)和新的请求(如下一页的链接)发送给引擎。爬虫(SPIDERS):最核心的组件,用于从特定的网页中提取自己需要的信息。

m0_74263521的博客 1423

网络爬虫基础实践与学习心得

网络爬虫是模拟浏览器行为获取网页数据的程序,核心流程包括:发送请求→解析响应→提取数据→存储数据。常见场景如数据采集、信息监控等,但需注意遵守网站 robots 协议,避免恶意爬取。1.2 第一个爬虫示例:获取豆瓣电影 TOP250。

eee123h的博客 964

Hugekid_2022年网络我的网络爬虫学习心得

关于初学爬虫的心得体会

m0_64782798的博客 639
上一篇: 电工电子技术基础
下一篇: Java综合项目开发学习心得
谢李由20230322081
博客等级 码龄3年 248粉丝 14原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值