


当 Deep Search Agent 撞上真实世界的专家规则
过去两年,大模型 Agent 在深度搜索(Deep Search)方向进展飞速——BrowseComp、GAIA 等基准不断被刷新,Agent 学会调用搜索、浏览等工具,多步迭代地解决问题。但当我们把目光投向法律、医疗、税务、跨境电商这些真正的高价值垂类场景任务时,会发现先进 Agent 在这些真实专业场景中遇到了巨大挑战:它们不能只靠模型的内部知识,而必须像专家一样逐级调用工具、检索并严格应用人类专家编写的层次化规则,才能得出可靠结论。
为此,我们构建了 HSCodeComp,首个面向该能力的真实且专家级的 Deep Search Agent 基准,被 ACL 2026 接收,并获评最佳资源论文奖项。
论文标题:
HSCodeComp: A Realistic and Expert-level Agent Benchmark for Hierarchical Rule Application。
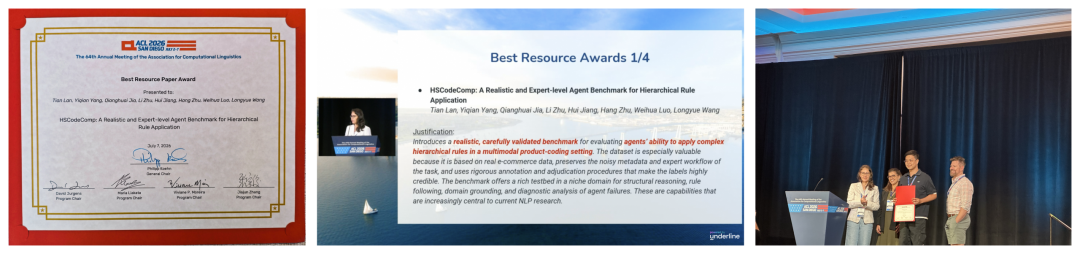
ACL 2026 Best Resource Paper:获奖证书(左)、Best Resource Awards 现场公示(中)与现场领奖留影(右)。
这次的分享重点在展开分析我们论文研究的重要内容和关键发现,为 Agent 在真实专家级垂类任务中可靠应用带来启发。在展开评测与分析之前,我们先花点篇幅把这个任务本身讲清楚:它是什么、为什么重要、难在哪里。
01Background 背景:这是一个什么垂类任务,为什么重要?
1.1 什么是海关商品编码 HS Code?
先从任务本身说起。HS Code(Harmonized System Code,商品名称及编码协调制度)是支撑全球每年约 26 万亿美元贸易的商品"唯一数字身份证"。每一笔跨境货物通关都必须申报 HS Code,它直接决F f f F f定了超过所有跨境商品的关税计算和合规性,跨境商品的编码如果报错,轻则多缴关税,重则触发合规风险和货运延误。
如下图1所示,在阿里巴巴跨境电商海关商品编码(HS Code)场景中,该专家级任务需要将商品沿着人类专家编写的规则树逐层向下推导、精确归类到唯一国际通用编码上。我们称之为层级规则应用(Hierarchical Rule Application),并发现它恰恰是当前 Agent 评测的一块关键盲区。
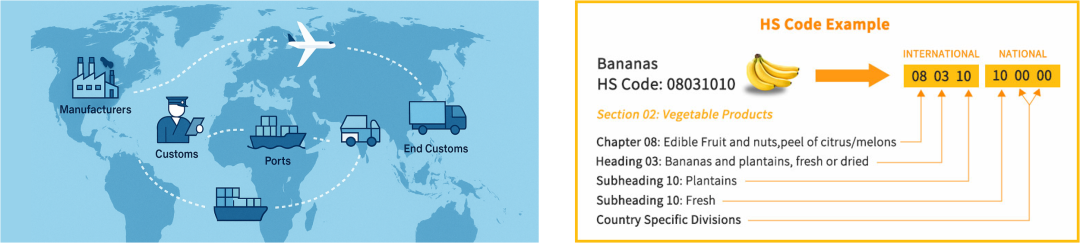
Figure 1|HS Code 是全球跨境贸易的基石,反映了理解真实商品世界所需的复杂度与专业性。
在实际申报中,资深关务专家需要依据严密的层级关税规则,把一件商品精准映射到唯一的 10 位细分编码,逐级细化:
- 2 位|章(Chapter) → 4 位|品目(Heading) → 6 位|子目(Sub-heading) → 8/10 位|国别码(Country-specific)
这本质上是一条必须满足规则树上所有约束的合法路径:只有每层判定都正确,最终 10 位编码才成立。以下图的常见的"AirPods 硅胶保护套"为例,申报时就要逐层回答一连串专业问题:它的材质"硅胶"该归入塑料(第 39 章)还是橡胶(第 40 章)?它算"表面覆盖物"还是"携带盒"?是"配件"还是"零件"?——每一层都必须严格应用专家规则归类,任何一层判错都会导致最终 10 位编码全盘皆错。
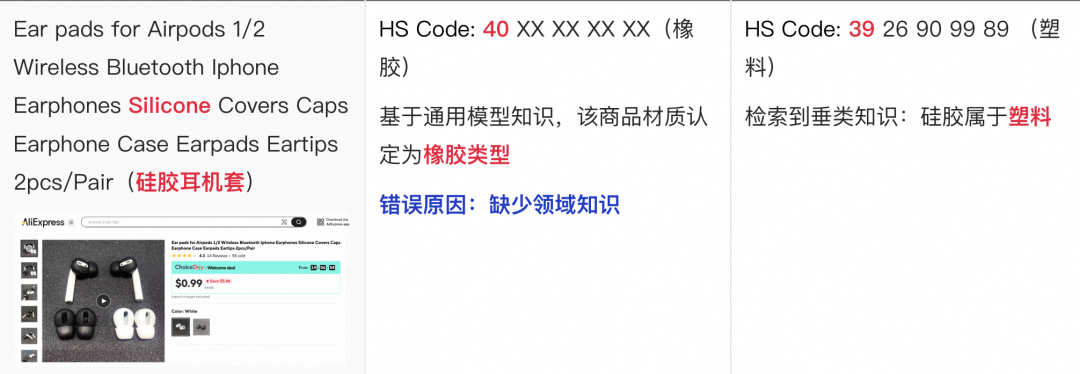
Figure 2|Airpods 硅胶保护套 分类样例
正因如此,HS Code 预测是一个典型的高价值、强专业、可客观验证的任务:一位从业 10 年的关务专家能达到 95% 的 10 位准确率,而目前最强的 AI Agent 只有约 49.4%(Hermes-Agent + Qwen3.7-Max)——接近腰斩的差距。这道鸿沟究竟从何而来?要回答它,需要先看清这个任务的本质结构,以及它区别于以往深度搜索任务的独特难点。
1.2 任务形式化:本质上是一个"专家级深度搜索"任务
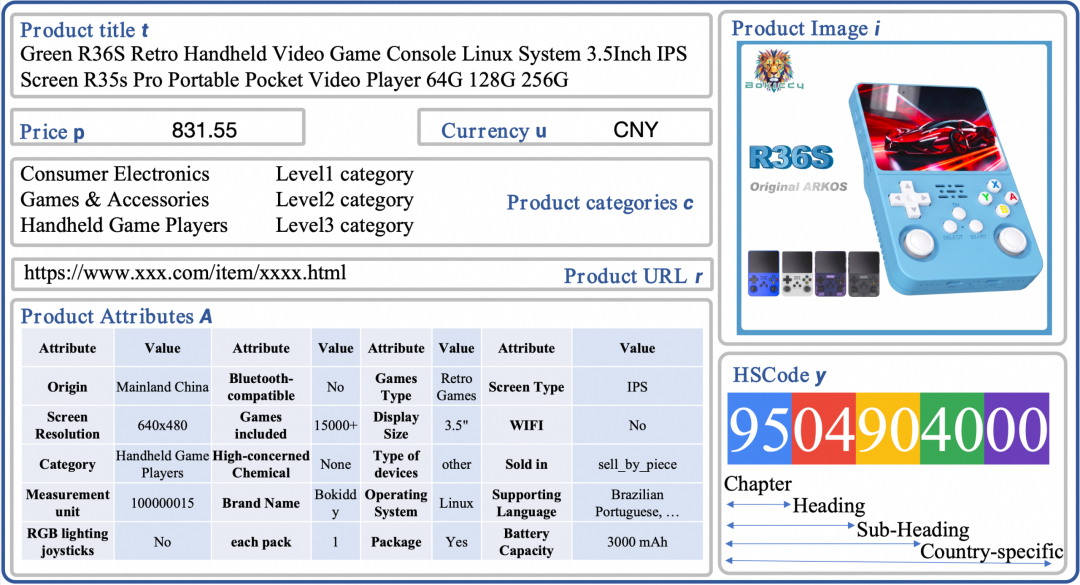
Figure 3|任务形式化:Agent 在噪声商品档案 X 上,逐级调用工具检索并应用规则 R 与知识 K,得到唯一 10 位编码 Y。正因需多步调用工具检索专家规则/知识,它本质是"专家级深度搜索"。
本质上,这是一个 专家级的 Deep Search 任务。因为 Agent 无法只靠内部知识作答,它必须像人类专家一样,逐级调用工具去检索最新的相关专家规则与知识,再一步步向下逐层推导找到最终的10位HSCode编码。形式化来看,这个任务本质上是一个映射函数 :
-
多模态商品档案: 如下图所示 ,即标题 、 个结构化属性 (如材质、包装尺寸)、平台类目 、商品图片 (捕捉文本缺失的纹理/形态等视觉特征)、价格 与币种 。
-
R分层规则: 包含官方层级关税规则(源自 eWTP 平台聚合的权威美国 HTSUS 税则)以及关税专家多年工作积累的专业决策规则,用于在多个品目看似都适用时裁决冲突。
-
K领域知识库: 历史海关裁定库(美国 CROSS 系统),作为 few-shot 范例帮助处理规则模糊的边缘情况。其中,知识库 (美国海关公开的 CROSS 历史裁定库)的实际形态如下图:
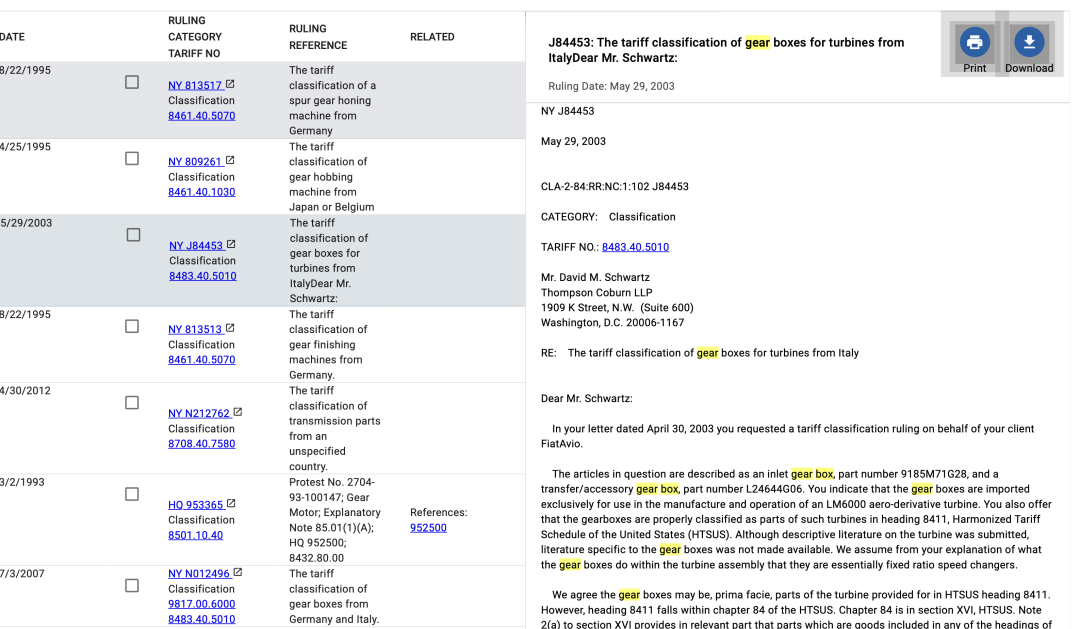
Figure 4|CROSS 裁定库示例(论文附录):左为可检索的裁定列表,右为单条裁定详情——每条含裁定编号、商品描述、最终 HTSUS 编码与完整归类法理说明,可作为 Agent 检索的 few-shot 先例。
- Y唯一的 10 位 HS Code: 必须是 HS 分类树上满足 R 中所有约束的一条合法路径。
需要强调的是,并非一步到位的分类,而是一个多步"检索—推理—回溯"循环 : Agent 先从具有真实世界商品噪音信息的 中抽取关键物理属性,据此在 中检索候选规则以及逐条核对例外与交叉引用等情况,必要时到 (CROSS 历史裁定库)里寻找先例佐证;当多个品目看似都成立时,还需调用专家决策规则裁决优先级,最终才逐层收敛到唯一的 10 位编码。正是这种"边检索、边应用规则、边回溯"的特性,使它区别于一次性的分类问题,成为一个典型的专家级深度搜索(Expert-level Deep Search) 任务。
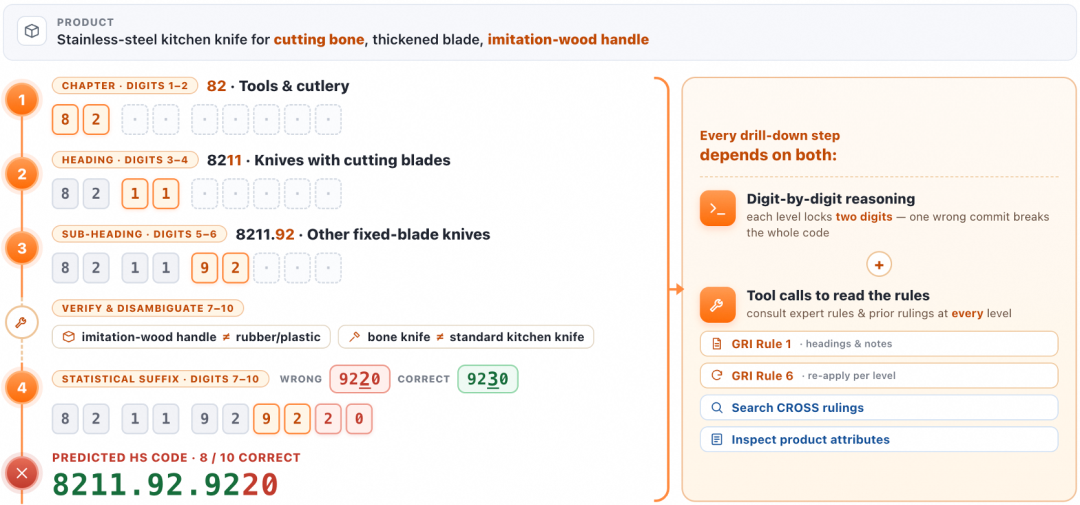
Figure 5|f 的多步"检索—推理—回溯"过程:每一层都同时依赖调用工具逐位推理。
1.3 专家级Deep Search任务中被忽视的能力
那么这类专家级 Deep Search Agent 和已有的 Deep Search 任务以及评测 benchmark 有何本质差异? 具体的,我们可以把 Agent 所需的知识复杂度划分为递进的三个层次:
-
Level 1 开放域数据: 理解、推理和使用海量真实世界网络数据和知识的能力,代表性工作有 BrowseComp、WebArena 和 GAIA 等。
-
Level 2 结构化数据: 精确理解和利用特定领域的结构化数据资源,如数据库和知识图谱等结构化知识。代表工作有 MedBrowseComp 和 FinSearchComp 等。
-
Level 3 分层规则数据(本文焦点): 在前两者之上,如何进一步精准应用人类专家撰写的层级专业规则。这正是当前评测的关键盲区。
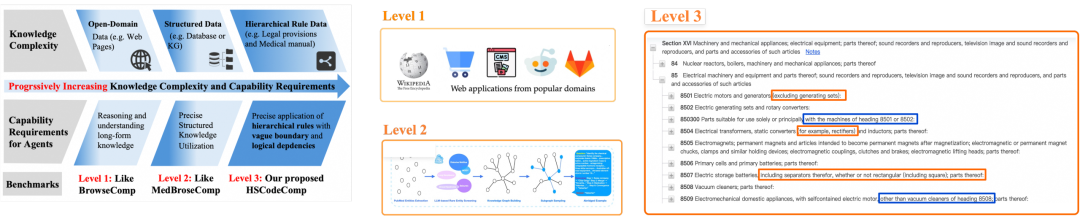
Figure 6|三级知识复杂度:从"读懂网页"到"用好结构化知识",再到"精确应用分层专家规则",能力要求逐级递增;Level 3 仍是空白。
Level 3 之所以独特而困难,源于分层规则天然带着三大挑战:
-
层级深、一步错步步错(Hierarchical Reasoning): 需在规则树上逐层推理,上层一旦判错(如把硅胶误归入橡胶第 40 章),错误会沿路径级联放大为整体失败——后续每一层都建立在错误前提之上,几乎无从纠偏。
-
语义边界模糊(Vague Boundary): 如图7蓝框所示,规则里充斥"除……以外(excluding)"“其他(other)”"主要用于(principally used)"等自然语言限定,边界模糊且高度依赖上下文,为Agent精准利用规则分类商品带来巨大的不确定性。
-
逻辑高度耦合(Coupled Rules): 如图7红框所示,规则间充满例外条款与交叉引用,某个品目能否成立往往取决于另一条注释是否被触发,牵一发而动全身。
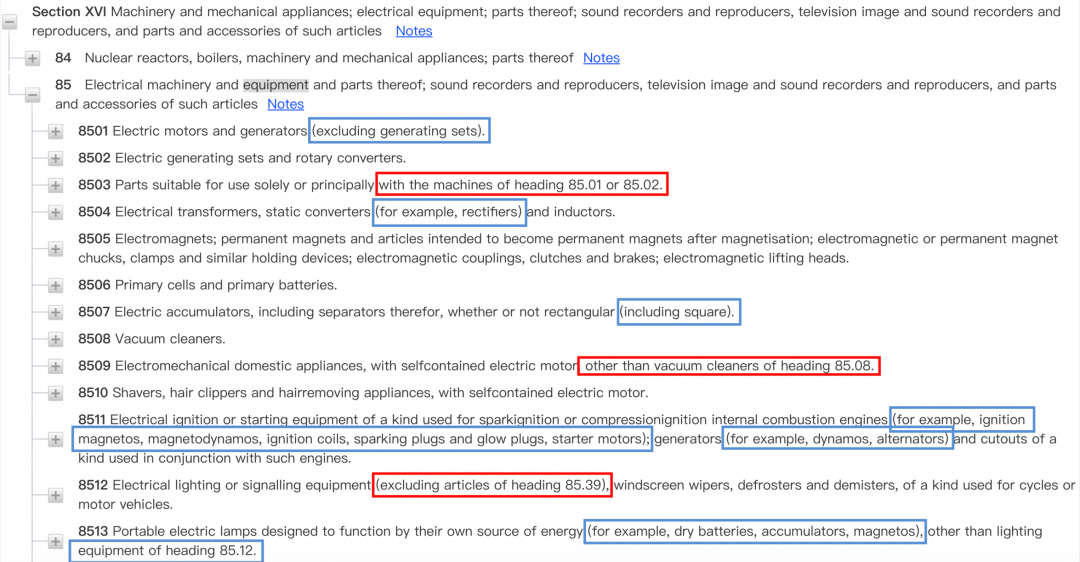
Figure 7|层次化关税规则示例:蓝框标注"除……以外"这类模糊边界,红框标注例外条款与交叉引用。
而这三大挑战并非 HS Code 独有。分层规则应用是众多高价值专业垂类的共性挑战(Common Challenge):从法律合规、税务审计到医疗编码——凡是依据人类专家编写的层级规则任务,都会遇到同样的层级级联、语义模糊与规则耦合。一个典型例子是医疗领域 WHO 的 ICD-10 疾病编码:如下图8所示,它与 HS Code 拥有几乎完全相同的分层规则结构,这些ICD编码直接决定患者的保险覆盖,具有重要的真实世界应用价值。
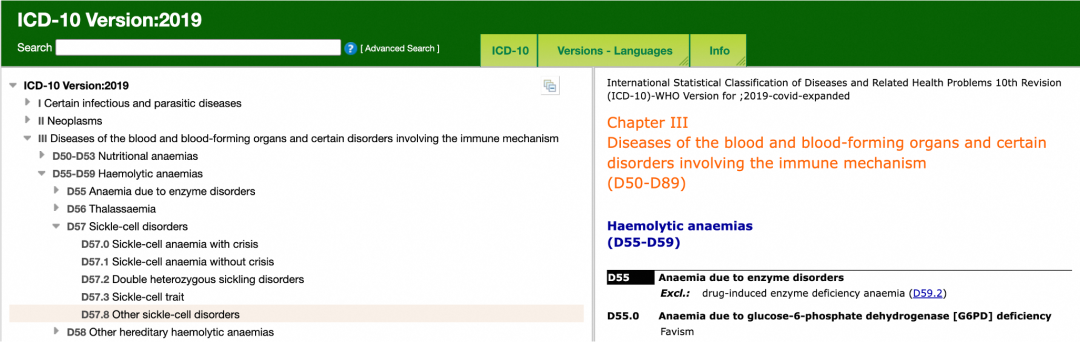
Figure 8|共性挑战案例:WHO ICD-10 层次化疾病编码。
HSCodeComp 在 HS Code 上揭示的Agent能力边界与诊断方法,对这些真实世界垂类任务也具有直接的借鉴意义——这也是我们选它作为 Level 3 代表性任务的原因。
02Benchmark Construction 基准构建:如何做出一把「专家级」标尺?
要可靠评估 Level 3 能力,就必须获得高质量的编码标注。由于任务的专业性与复杂度,HSCodeComp 刻意回避了常见的众包标注与 LLM 自动生成,转而追求真正的专家标注。
2.1 数据统计信息
-
真实世界噪声(Real-world Noise): HSCodeComp 数据来源于真实的大规模全球电商平台,按实际销量与类目分布采样以还原真实分布;刻意保留冗长标题、错填属性、误导关键词等噪声,逼近电商 “In-The-Wild” 复杂度;并用语义去重等后处理方案,过滤类目与编码完全重复的样本,保证长尾覆盖。
-
专家级(Expert-Level): 组建 26 位关务专家(平均从业 5 年以上)的标注团队,按照下图的6步标注pipeline对商品标注。其中前4步模拟了真实的关税专家的分类流程,最后2步通过多名专家的交叉验证提高数据质量。最终专家的分歧率仅约 2%,证明了数据集的可靠性。
-
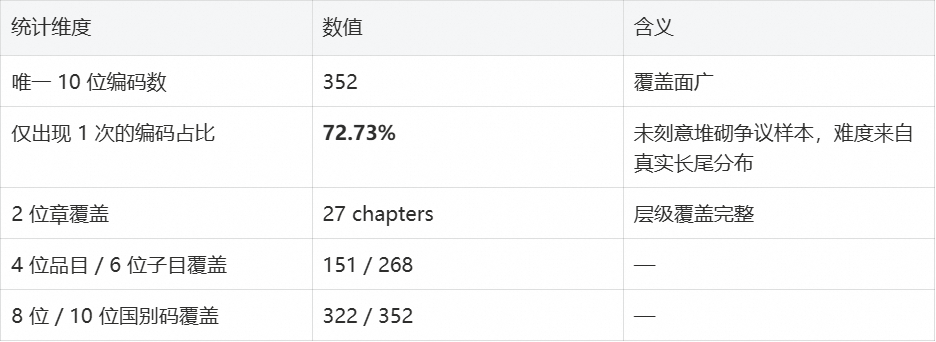
真实规模(Realistic): 最终包含 632 个真实商品,自然横跨 32 个大类。并且关键统计结论说明数据集的商品和编码覆盖范围广,能够有效反映Agent在跨境电商应用下的真实性能。
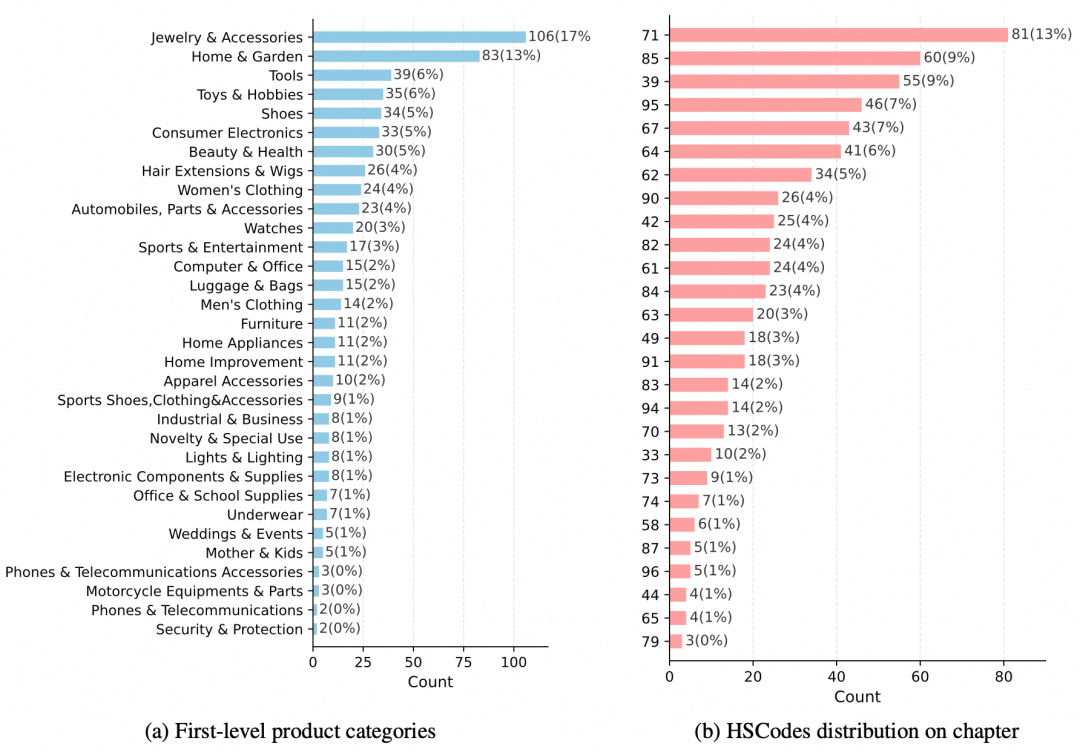
Figure 9|品类与章节分布:贴合真实贸易分布;最具挑战的样本恰恰集中在长尾类目(如 Novelty & Special Use 1.3%、Men’s Clothing 2.2%)。
2.2 六步专家标注工作流
标注遵循「双人独立标注 — 高级仲裁 — 抽样复核」的六步专业工作流:
-
Step 1|信息采集: 两位专家分别浏览商品网页,收集全部信息。
-
Step 2|结构化抽取: 抽取商品核心结构化特征。
-
Step 3|查询裁定库: 在官方裁定库(CROSS)检索相关历史案例;若命中,则在 eWTP 系统校验对应 HS Code 并修订;否则精修查询、回到 Step 2 调整特征。
-
Step 4|应用决策规则: 对无相关裁定的商品,执行专家决策规则以应用关税规则、确定编码。
-
Step 5|最终校验: 在 eWTP 网站校验最终编码有效性。
-
Step 6|质量复核交叉验证: 两位专家独立标注,编码一致才接受;分歧由资深专家仲裁,仍无共识则丢弃。另有一位未参与初标的第四位资深专家对随机 10% 样本重标,最终分歧率仅 2%。
最终获得632条真实世界商品对应的高质量HSCode编码,横跨32个商品大类。
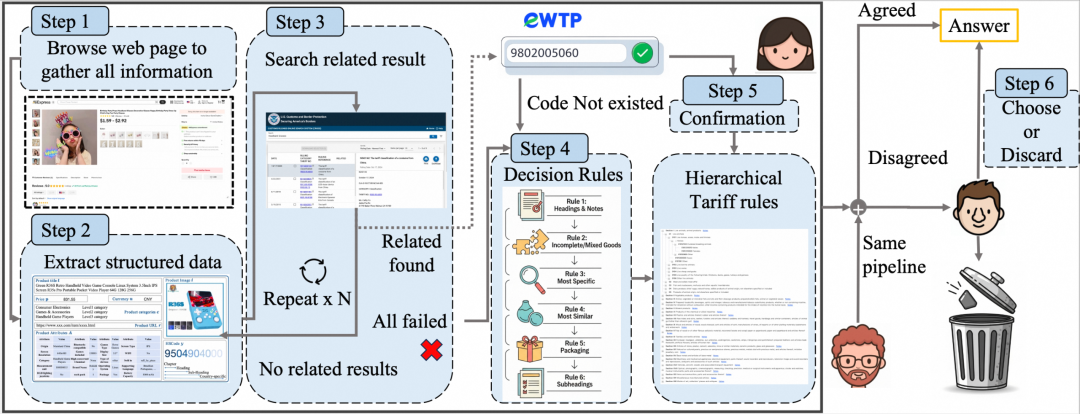
Figure 10|六步专家标注流程:前四步覆盖商品档案抽取与分层规则应用,后两步做严格的专家交叉验证(Step 6)。
2.3 评测指标与统计可靠性
HSCodeComp 的评估指标简单且客观,使用 Exact Match Accuracy 作为主要评测指标,报告 2/4/6/8/10 位准确率,其中 10 位准确率是对端到端层级推理最严格的衡量。
HSCodeComp 数据集包含有 632 样本,经 bootstrap 95% 置信区间分析已达"统计平衡"——从 600 → 632 样本,最优系统 CI 宽度仅收窄 0.21%(约 ±7.78%),继续扩样收益微乎其微。说明HSCodeComp上的评估结果具有较强的统计稳定性。
03Evaluation & Analysis 评测与深入分析
团队在 HSCodeComp 上评测了 28 个 最先进系统,涵盖 GPT-5.5、Claude-Opus-4.8、GLM-5.2、DeepSeek-V4-Pro、Qwen3.7-Max 等基础模型,Hermes-Agent、SmolAgents、AWorld、AgentOrchestra、OWL、WebSailor、Cognitive Kernel 等开源 Agent 框架,以及 Manus、Gemini Deep Research、Grok DeepSearch 等闭源商用系统。
3.1 核心发现:巨大的能力鸿沟
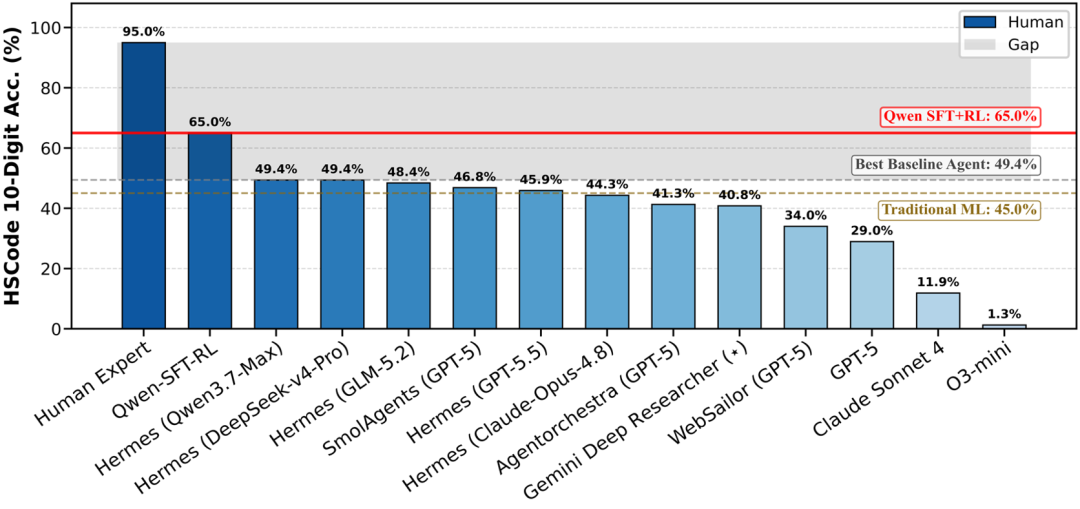
Figure 11|核心结果:最强 Agent(10 位 ~49.4%)远远落后于人类专家(95.0%)。
评测指标简单而客观——直接看 10 位编码的 Exact Match Accuracy。我们把 GPT-5.5、DeepSeek-V4-Pro 等前沿模型与 Agent 全部放上去评测,结论指向同一个方向:
-
显著鸿沟(Significant Gap): 表现最好的 Agent 也只有约 49.4%,远远落后于人类专家的 95%——几乎腰斩。
-
增益微弱(Marginal Gain): 这些前沿系统甚至只是勉强超过传统机器学习方法(基于大量人类专家规则的决策树系统性能约 45.0%),却付出了高得多的算力与推理成本。不过需要强调的是,决策树方案对长尾商品和新规则的适应能力较差。
-
结构性瓶颈(Structural Bottleneck): 通过在在 6k 条专家标注的样本数据上做 SFT 和 Agentic RL 训练,也只能将Qwen Agent性能和准确率提升到 65% 。这也说明层级规则利用对当前的AI Agent来说是一个结构性瓶颈,并不是通过简单扩展数据规模或者模型参数规模就可以解决的。
3.2 Case Study
论文用三个真实案例,具象化了 Level 3 的固有复杂度:
-
真实噪声(误导关键词): 标题里的 “Poster(海报)” 会把 Agent 带偏,而商品真实身份其实是 Canvas(画布)——需交叉比对其他细节 + 结合图片才能纠偏。
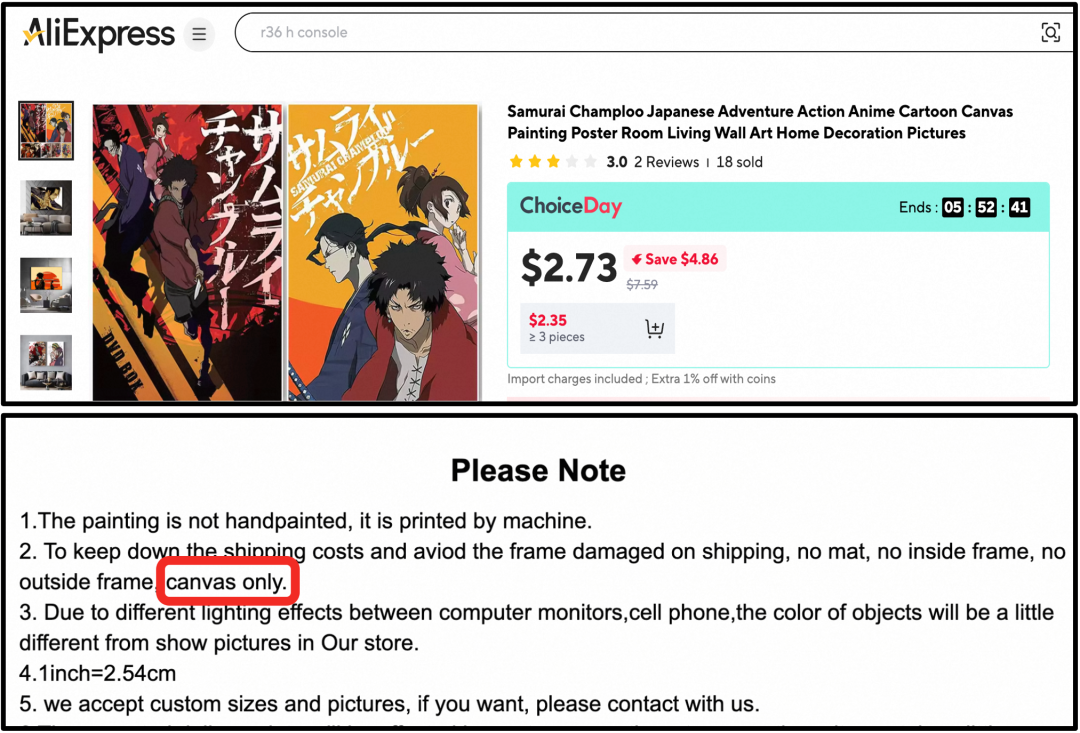
Figure 12|书籍案例:商品页信息含噪,关键的页数并不在标题/属性里。
-
细粒度视觉属性: 一本书的最终编码,取决于藏在商品图片深处的页数信息(如 304 页)——不看图、看不清就必然判错。
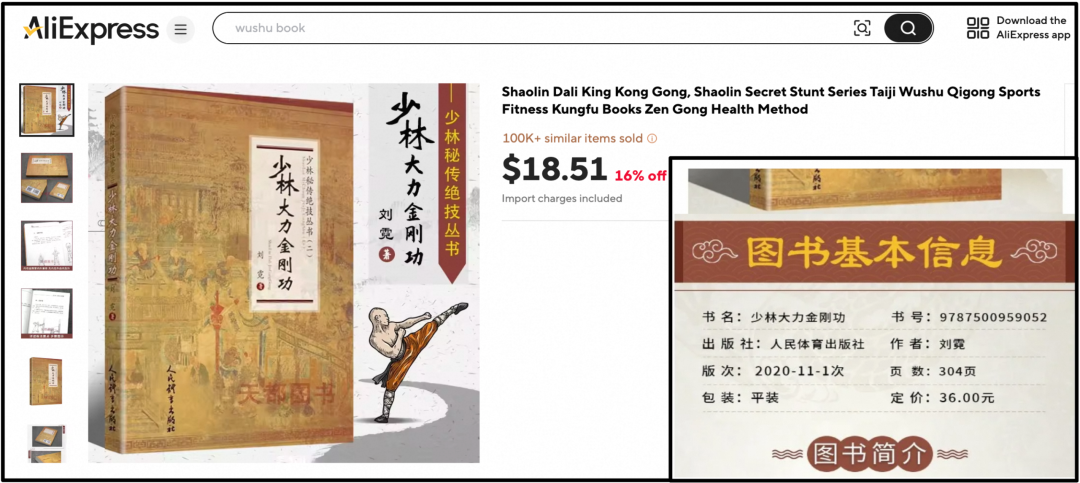
Figure 13|书籍案例:决定末位编码的"304 页"信息深藏于商品图片中,必须靠视觉抽取。
-
领域知识缺口: 反直觉的专家规则把 硅胶定义为塑料(第 39 章)而非橡胶。
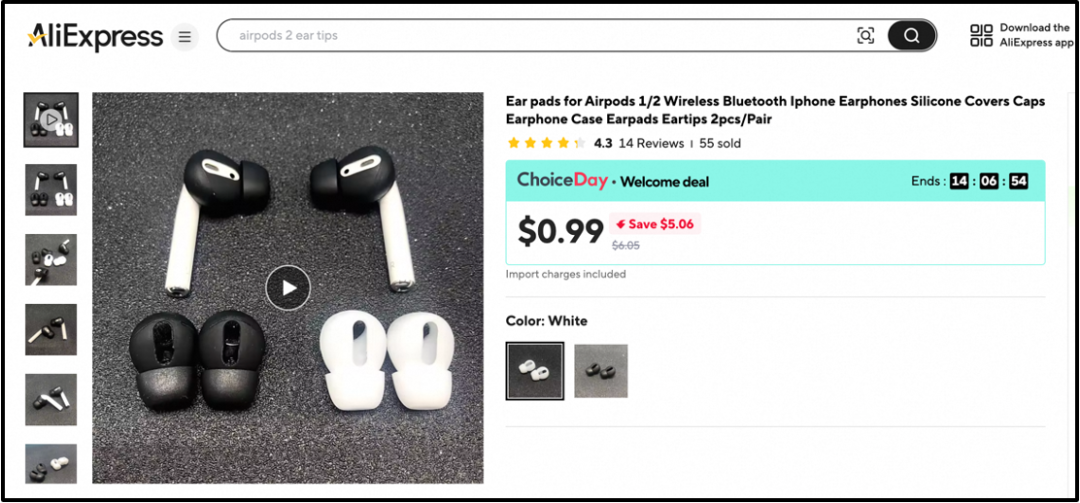
Figure 14|菜刀分层推理案例:需在正确感知材质/用途的前提下,逐层做出符合规则的判定。
3.3 分析一:Test-Time Scaling 无法缓解差距?
一个常见直觉是"多算几次、多反思几次总会更好"。但在 HSCodeComp 上,两种标准 TTS 策略均告失效:
-
多数投票(Voting@K,K=1→16): 图15左图显示,增大 K 几乎不带来提升——因为 Agent 无法区分"正确路径"与"自信的错误",投票只是在同源错误里挑众数。
-
自我反思(Self-Reflection): 图15中图显示,自我反思带来的提升非常微弱,主要原因在于模型出了会纠正错误也会将正确样本改成错误的,说明Agent并没有学会有效的自我反思,更像是盲目重试。
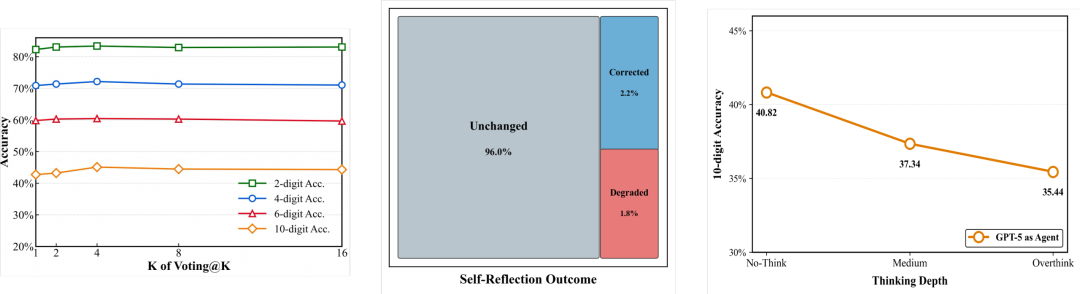
Figure 15|Test-Time Scaling 难以弥合差距:投票曲线趋于平台,自反思不升反降。
更为有意思的是,我们发现了一种推理漂移(Reasoning Drift)的现象,具体如图15右图显示,强迫模型"想得更多"(增大 reasoning effort)非但不涨反而下滑——GPT-5 的 10 位准确率随推理深度从 40.82% 一路跌到 35.44%。这一现象根本原因在于当有价值信息位于领域知识与规则中时,缺乏准确工具反馈的"自由发挥"会让 Agent 幻觉出并不存在的约束、误读模糊描述。
典型样例如下:为强行归类一双女鞋,Agent 编造了"鞋面表面积超 90% 且无围条(welt)"等并不存在的属性,又忽略了"价格大于 12 美元"的规则,最终 10 位编码判错。
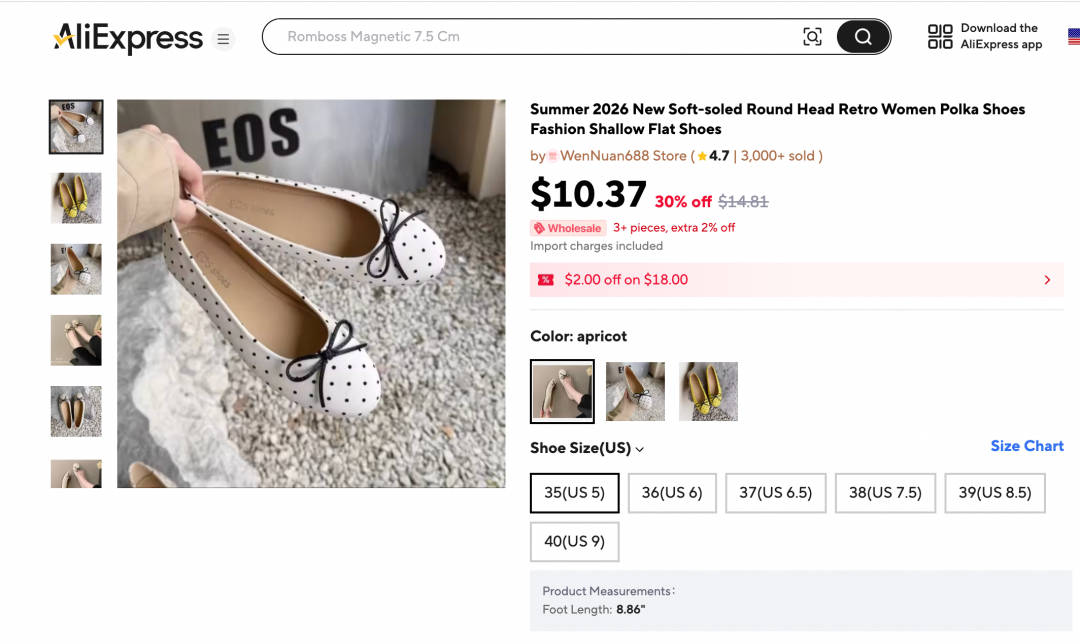
Figure 16|女鞋推理漂移案例:幻觉属性 + 忽略价格规则,一步错导致满盘皆输。
这启发我们,对于有价值信息位于领域知识与规则中的专业任务,应优先做知识与规则的检索利用,而非让模型自己「想」,才能避免幻觉与推理漂移。
3.4 分析二:到底哪些知识信息有用?
既然靠"想"和"投票"都不行,那到底哪些知识与信息真正驱动性能?答案清晰地指向三点:
1. 历史裁定库(CROSS)是最稳定可靠的增益: 接入 CROSS 后,三个骨干模型的 10 位准确率无一例外地大幅提升:GLM-5.2 从 38.77% 涨到 48.42%(+9.65),DeepSeek-V4-Pro 41.61%→49.37%(+7.76),Qwen3.7-Max 43.99%→49.37%(+5.38)。原因在于,CROSS 里的真实历史裁定天然是高质量的 few-shot 先例:当规则语义模糊、多个品目看似都成立时,Agent 可以直接检索相似判例、参照海关既往的裁定逻辑来消解歧义——相当于给模型配了一本"判例词典"。
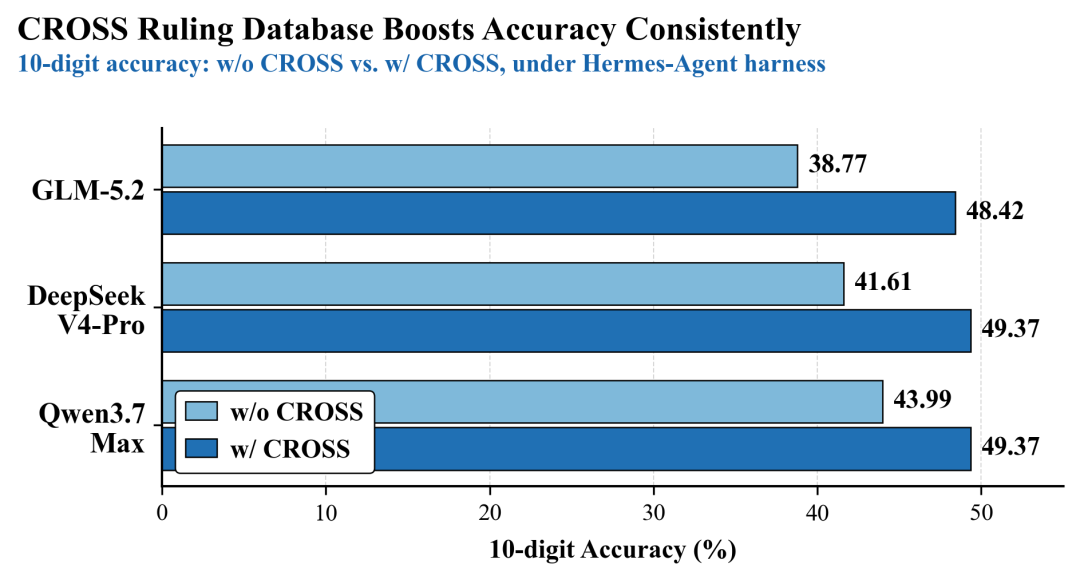
Figure 17|CROSS 历史裁定库带来一致增益:三个骨干模型接入 CROSS 后 10 位准确率均显著提升(GLM-5.2 +9.65、DeepSeek-V4-Pro +7.76、Qwen3.7-Max +5.38)。
2. 视觉信息有用,但只是边际增益: 图像能补齐文本描述缺失的物理细节(材质、表面工艺、形态等),但增益有限、且高度依赖骨干模型的视觉能力:GPT-5 从 42.72% 提升到 46.83%(+4.11),而 Claude-4-Sonnet 仅 +0.95(33.70%→34.65%)、GPT-4o 几乎纹丝不动(22.03%→22.31%,+0.28)。也就是说,只有足够强的 VLM 才能真正「看懂」并用上图里的信息;弱骨干即便喂了图片也用不起来。视觉是有益补充,却替代不了对规则的精确应用。
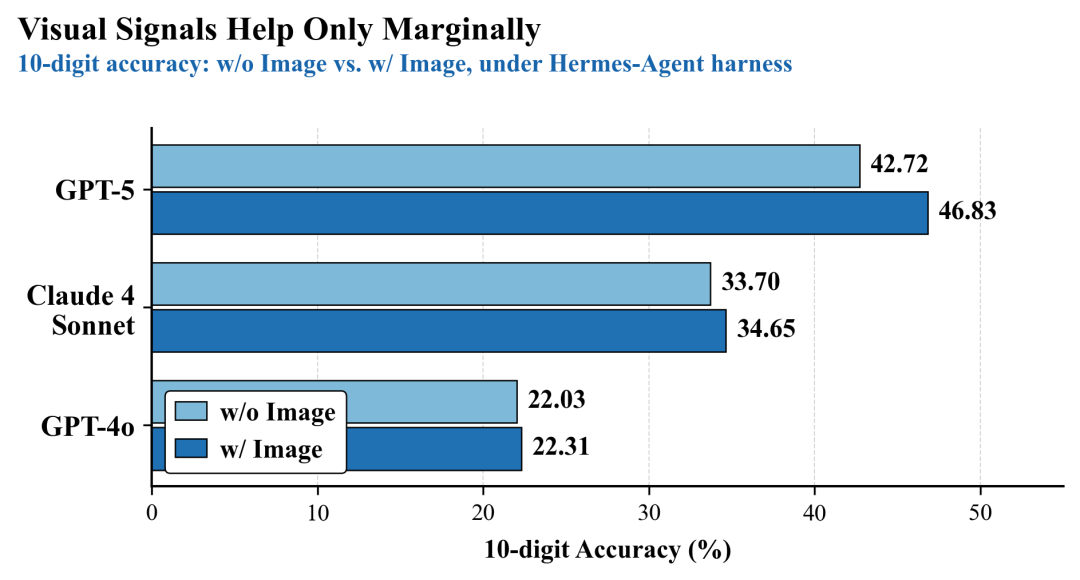
Figure 18|视觉信号仅带来边际增益:GPT-5 +4.11,Claude-4-Sonnet、GPT-4o 几乎无提升——越弱的骨干越用不上图像里的物理细节。
3. Agent Harness是是不可或缺的地基: 把裸模型(LLM)包进能"检索并应用最新专家规则与知识"的 Agent 框架后,10 位准确率从 28.96% 抬升到 37.42%(6 个 GPT-5 骨干 Agent 系统的平均,+8.5pt)。这说明本任务的关键并不在模型"记得多少",而在于能否即时检索到最新的分层规则/领域知识、并正确地逐层应用——这也正是它区别于普通分类、成为"专家级深度搜索"的根本。需要强调的是,规则不是简单塞进上下文就行:只有让 Agent 主动检索、按优先级动态裁决并逐层套用,才能把知识真正转化为准确率。
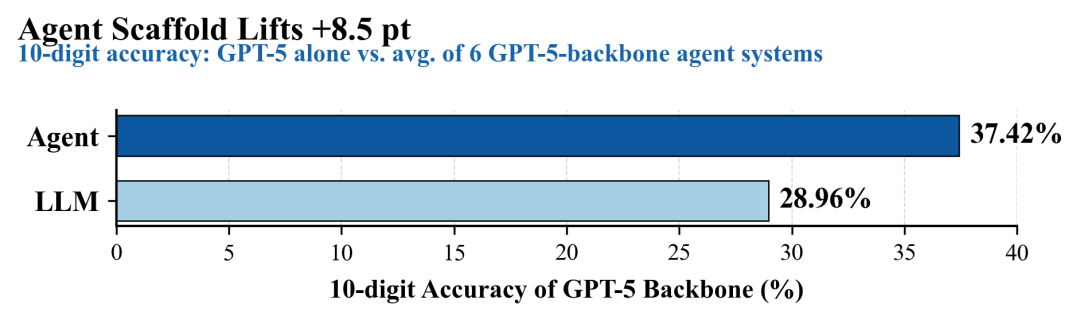
Figure 19|Agent scaffold 抬升 +8.5pt:6 个 GPT-5 骨干 Agent 系统的平均 10 位准确率(37.42%)显著高于裸 GPT-5(28.96%)——检索并应用最新规则/知识的工具框架是必需项。
综合来看,三类信号的重要性排序清晰:规则/知识检索(+8.5pt,地基)> CROSS 历史裁定(+5~10pt,稳定可靠)> 视觉信息(+4pt 且仅限强 VLM,边际补充)。这再次印证 HSCodeComp 是一个 “规则/知识中心"而非"检索算力中心” 的任务:决定成败的不是算得多快、想得多深,而是能否检索到正确的专家规则与判例,并严格、逐层地把它们应用到位。
3.5 分析三:HSCodeComp 挑战性体现在在长尾商品类目
最后,我们把视角拉回数据本身,验证"难度到底是不是天然的、以及它是否与品类分布相关"。跨 32 个一级品类,我们统计了两条互补的分布(下图):
-
CID(Challenging Product Distribution,最难样本分布): 所有基线系统都判错的"硬骨头"样本在各品类上的占比。
-
APD(Average Performance Distribution,平均性能分布): 各品类上所有基线系统的平均 10 位准确率。
两条分布(图中蓝色细条为该品类在数据集中的样本占比)共同揭示两点:
-
最难的样本集中在长尾类目: CID 显示,全军覆没的样本高度集中在 Novelty & Special Use(数据占比仅 1.3%)、Men’s Clothing(2.2%) 等长尾品类——它们描述非标、样本稀疏,恰好暴露了 Agent"把规则泛化到数据稀疏领域"的短板。
-
整体准确率普遍偏低: APD 显示,绝大多数品类的平均 10 位准确率不足 25%,仅 Hair Extensions & Wigs 约 47% 一枝独秀;即便是 Jewelry & Accessories、Home & Garden、Tools 这类数据占比最高的主流品类,准确率也低于 18%。
这说明 HSCodeComp 的难度并非由数据倾斜人为制造——难度是分层规则本身固有的,且与品类是否高频无关:越是长尾、越是非标描述,规则应用就越容易崩塌。
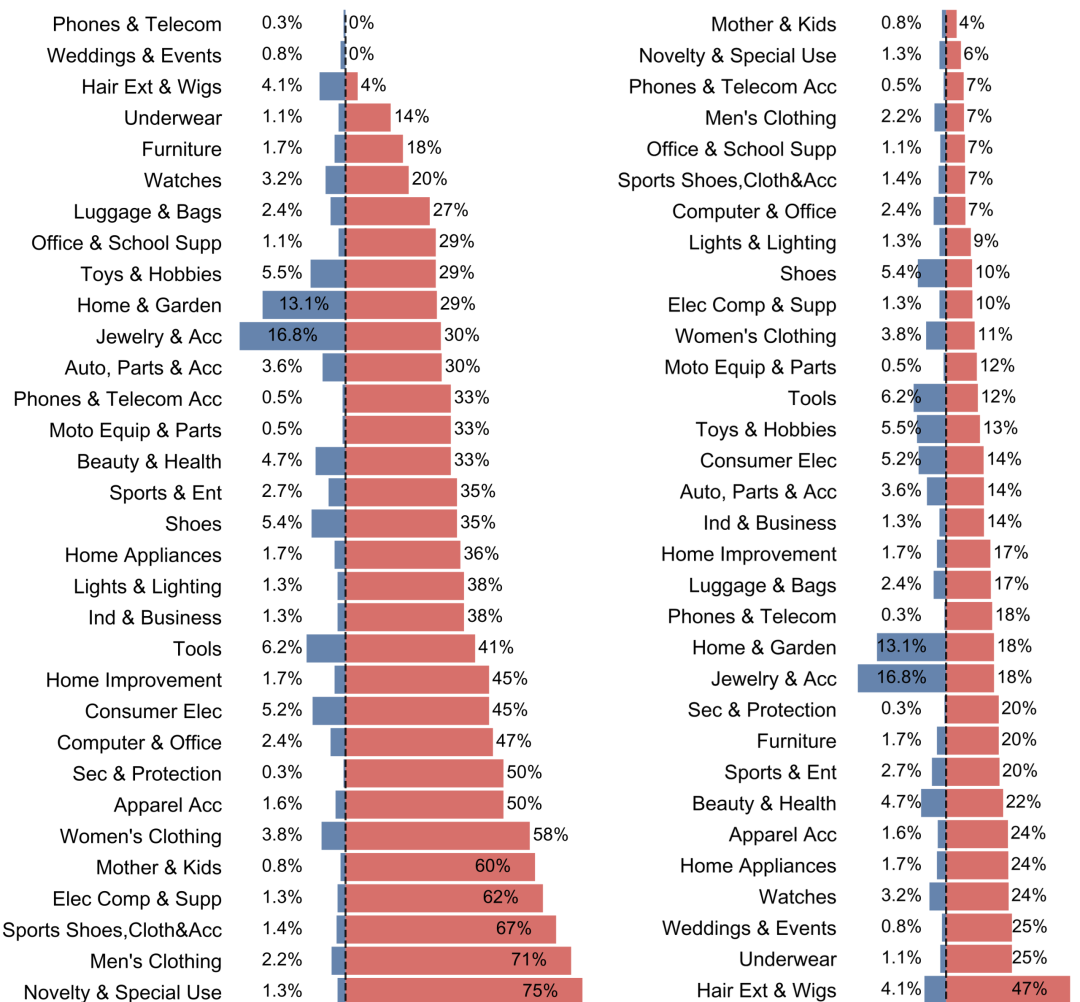
Figure 20|按一级品类的难度分布(源自论文)。左:最难样本分布(CID),红条为"全部基线判错"的样本占比;右:平均性能分布(APD),红条为各品类平均 10 位准确率;两侧蓝色细条均为该品类的数据占比。最难的样本集中在 Novelty & Special Use、Men’s Clothing 等长尾类目。
04Future Work 从基准到落地与展望
4.1 从基准到落地:先评测、后优化的完整闭环
HSCodeComp 不止是一篇评测论文。基于基准上获得的洞见,团队进一步在跨境贸易数字关务真实垂类场景中,设计了以 Qwen 基座为核心的 Agent 框架:通过在 6k 个人类专家标注数据上做 SFT + Agentic RL 优化,该 Agent 以约 65% 的准确率稳居 AI Agent 系统第一位。
但需清醒看到两点:
-
仍显著落后于人类专家(95%): 说明分层规则应用对当前 AI Agent 属于结构性挑战,难以通过简单 Scaling(换更大模型、堆更多数据)解决。这与 3.3 节 TTS 失效的结论一致。
-
下一步关键能力: 需强化错误回溯、规则优先级动态判定,以及把推理牢牢锚定在专家规则与动态知识之上的能力。
4.2 泛化到更广的专业垂类
正如 1.3 节所述,分层规则应用是众多高价值垂类的共性挑战:ICD-10 医疗编码、美国《联邦法规》(CFR)、法律合规与税务审计等等。因此,HSCodeComp 揭示的能力边界与诊断方法具备天然的跨垂类可迁移性——同一套"先评测、后优化"的闭环,可以复用到这些同构任务之上。面向未来,我们希望构建能够将推理牢牢锚定在专家规则与动态知识之上的 Agent:让模型不再依赖内部记忆去"猜",而是像专家一样逐级检索、严格应用规则,并在出错时可靠回溯。从而最大化AI Agent在各种专业垂类任务场景下的效果。
4.3 开源
HSCodeComp 全部数据与评测代码均已开源,社区可直接使用:
GitHub: https://github.com/ATH-MaaS/Marco-DeepResearch
Hugging Face 数据集:
https://huggingface.co/datasets/ATH-MaaS/HSCodeComp
论文: https://aclanthology.org/2026.acl-long.937
05致谢
HSCodeComp 能够顺利完成并获认可,离不开多方长期的支持与协作。首先,感谢阿里 ATH-MaaS(Alibaba Token Hub Model-as-a-Service)应用算法团队、产品和工程团队各位领导与团队成员在 Deep Research Agent 方向上的长期投入;也要特别感谢 AE 物流部的算法、工程和产运同学的的鼎力相助。同时,衷心感谢各位关务专家在数据集标注工作流中的专业付出。
最后,特别感谢 ACL 2026 Reviewer、AC、SAC、PC 与 Best Paper Committee 对 HSCodeComp 工作的高度认可。因项目参与人数较多,未能一一列名致谢,敬请谅解。HSCodeComp 是 ATH-MaaS 应用算法组 Marco-DeepResearch 系列的一部分,若对这一类问题感兴趣,欢迎交流与合作。

 248


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


