深度学习中的性能加速利器:深入浅出学习算子融合(Operator Fusion)

AI编译器-图常见优化算法-算子融合 通过将多个逐元素运算融合为一个大的逐元素运算,可以减少内存访问和计算的开销,从而提高性能。多个逐元素运算和批归一化融合:将多个逐元素运算和批归一化层融合为一个大的逐元素运算,减少内存访问和计算的开销。多个逐元素运算和全连接层融合:将多个逐元素运算和全连接层融合为一个大的全连接层,减少内存访问和计算的开销。多个逐元素运算和卷积层融合:将多个逐元素运算和卷积层融合为一个大的卷积层,减少内存访问和计算的开销。多个卷积层和逐元素运算融合:将多个卷积层和逐元素运算融合为一个大的卷积层,减少内存访问和计算的开销。 阅读详情
AI摘要

在深度学习模型日益复杂的当下,模型性能优化至关重要。算子融合是一种强大有效的技术,可减少内存访问、计算内核启动开销,提升缓存利用率。本教程介绍了其基本概念、优势、原理,结合 PyTorch 实例讲解融合方法,还提及推理阶段的优化。

        在深度学习模型日益复杂的今天,模型性能优化变得至关重要。除了算法层面的改进,从计算底层寻找优化空间是提升模型推理速度、降低延迟的关键。算子融合(Operator Fusion)正是这样一种强大而有效的技术。本教程将从基本概念入手,深入剖析其工作原理,并结合 PyTorch 实例讲解。

1.基本概念:

本部分将介绍算子融合的基础知识,如果已具备相关背景,可直接跳至后续章节。

        算子(Operator):指的是一个基本的操作,比如卷积(Conv2d)、批归一化(BatchNorm2d)、激活函数(ReLU)等。

        内存(Memory):通常指 GPU 的显存(DRAM)。

        计算单元(Compute Unit):指 GPU 上的 CUDA核心。

性能瓶颈:现代 GPU 的计算速度极快,但从显存中读取和写入数据的速度相对较慢。对于 Conv -> BN -> ReLU 这样的连续操作,标准流程是:

  1. 读:从显存读取输入数据。
  2. 算:执行 Conv 运算。
  3. 写:将 Conv 的结果写回显存。(conv结束)
  4. 读:从显存读取 Conv 的结果。
  5. 算:执行 BatchNorm 运算。
  6. 写:将 BatchNorm 的结果写回显存。(BN结束)
  7. 读:从显存读取 BatchNorm 的结果。
  8. 算:执行 ReLU 运算。
  9. 写:将最终结果写回显存。(RELU结束)

我们发现发现,这样计算有着大量的“读/写”操作(内存访问)浪费。

算子融合(Operator Fusion)就是将这些连续的、可以合并的算子(BN,RELU)在计算层面上融合成一个“超级算子”。这个超级算子在一次内核启动(Kernel Launch)中,连续执行多个操作,而不需要将中间结果写回全局显存。

于是:Conv -> BN -> ReLU 融合后就变成了 ConvBNReLU:

  1. 读:从显存读取输入数据。
  2. 算:在计算单元内部,依次完成 Conv、BN、ReLU 的所有计算。
  3. 写:将最终结果一次性写回显存。

2.算子融合的优势:

  1. 减少内存访问:这是最核心的优势,显著降低数据搬运延迟。
  2. 减少计算内核启动开销:每次调用一个独立的算子都需要一次 GPU 内核启动,这本身也有开销。融合后,多次启动变为一次。
  3. 提升缓存利用率:数据在计算单元的缓存(SRAM)中被连续使用,效率更高。

3. 融合的原理:

        这部分内容会稍微硬核一些,涉及计算机体系结构和编译器的一些基本概念。如果不是想要特别深入的了解,可以跳过。要理解融合为何有效,首先必须理解现代计算硬件(尤其是GPU)的性能瓶颈。

GPU的两个核心指标:

        1.计算能力 (Compute Power / FLOPS):指GPU每秒能执行的浮点运算次数。这个指标增长得非常快,得益于更多的计算核心和更高的时钟频率。

        2.显存带宽 (Memory Bandwidth):指GPU每秒能从其全局显存(VRAM)中读取或写入数据的总量。这个指标的增长速度远远落后于计算能力的增长。

        这种不平衡导致了所谓的 “内存墙” (Memory Wall) 问题:GPU的计算核心常常因为等待数据从缓慢的显存中传来而处于空闲状态。 换句话说,计算核心再大,显存带宽太小,也跑不快。

我们将深度学习中的算子(Operator)分为两类:

        1.计算密集型 (Compute-Bound):算子的计算量远大于其数据读写量。例如,大型矩阵乘法或大通道数的卷积。对于这类算子,性能主要取决于GPU的计算能力。

        2.访存密集型 (Memory-Bound):算子的数据读写量远大于其计算量。例如,ReLU, Add, BatchNorm, Dropout 等元素级(Element-wise)操作。对于这类算子,性能主要受限于显存带宽。

        残差模块中的 BatchNorm 和 ReLU 就是典型的访存密集型算子。它们本身的计算非常简单,但它们需要将整个特征图(Feature Map)从显存读入,计算完后再写回显存。这个过程的耗时主要花在了数据搬运上,而不是计算上。

        算子融合的根本目标就是最小化与全局显存(Global Memory)的交互次数。它通过将多个连续的算子合并成一个单一的、更大的GPU计算任务(称为一个 Kernel)来实现这一点。

我们用一个生动的“工厂流水线”比喻来解释:

场景一:未融合的流水线(Eager Mode)

一条流水线,有三个工人(Kernel):

        1.工人A (Conv2d):从一个巨大的仓库(全局显存)里取来原材料(输入Tensor),进行卷积加工,然后将半成品放入仓库的另一个货架上。

        2.工人B (BatchNorm2d):等工人A完成后,他再去仓库的那个货架上,把半成品取出来,进行标准化处理,处理完再放回仓库的新货架。

        3.工人C (ReLU):等工人B完成后,他再去仓库把处理过的半成品取出来,进行激活操作,最后把成品放回仓库。

问题:

  1. 往返仓库的耗时 (Memory Access Latency):每次去仓库取货、放货都非常耗时。这是主要的性能瓶瓶颈。
  2. 任务启动的开销 (Kernel Launch Overhead):每次调度一个工人开始工作,都需要一套启动指令和准备工作。当任务本身很简单时(比如ReLU),这个启动开销就显得很浪费。

这就是PyTorch默认的Eager模式的执行方式。每个nn.Module的forward调用都是一次独立的Kernel启动和一次完整的数据读写循环。

现在,我们把这三个工人换成一个连接在一条流水线上变成一组工人(Fused Kernel)。

一组工人(Fused Conv-BN-ReLU Kernel):

        1.一次性从仓库(全局显存)里取来原材料(输入Tensor)。

        2.工作台上(GPU片上高速缓存,如寄存器/L1 Cache),连续完成三道工序:卷积 -> 标准化 -> 激活。

关键:卷积产生的中间结果,没有放回仓库,而是直接递给了下一步的标准化处理。标准化的结果也没有放回仓库,而是立即用于激活。这些中间数据一直在高速工作台上流转。

所有工序完成后,才将最终的成品一次性放回仓库(全局显存)。

优化后:

        数据局部性 (Data Locality):中间数据在GPU芯片内部极高速的缓存中,避免了与缓慢的全局显存进行的往返交互。这是性能提升的最主要来源。

        减少启动开销:从三次任务启动减少到一次,降低了CPU与GPU之间的通信开销。

4.融合的方法:

以卷积残差模块为例:

我们来看一个标准的残差模块,它包含一个卷积分支和一个恒等映射identity(或1x1卷积)分支。我们主要关注其核心的卷积分支:
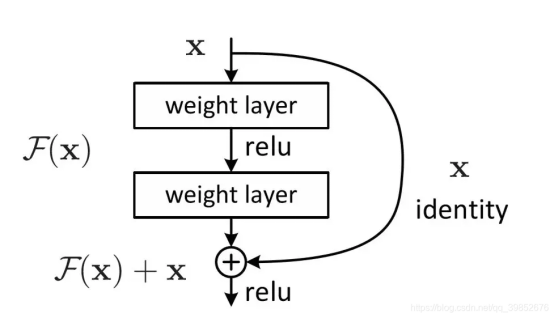
代码如下:

import torch
import torch.nn as nn
 
# 一个典型的卷积 -> BN -> ReLU 序列
class ConvBNReLU(nn.Sequential):
    def __init__(self, in_channels, out_channels, kernel_size=3, stride=1, padding=1):
        super().__init__(
            nn.Conv2d(in_channels, out_channels, kernel_size, stride, padding, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True)
        )
 
# 残差模块
class ResidualBlock(nn.Module):
    def __init__(self, channels):
        super().__init__()
        self.conv_branch = ConvBNReLU(channels, channels)
        # 加上残差连接
        # self.shortcut = nn.Identity() # 恒等映射
 
    def forward(self, x):
        out = self.conv_branch(x)     
        residual = x
        out += residual
        return out

在forward函数中,计算流是: Input -> Conv2d -> BatchNorm2d -> ReLU -> Add -> Output

未经优化的执行流程:

  1. Kernel 1 (Conv2d): 读取Input,计算卷积,结果Conv_Out写入显存。
  2. Kernel 2 (BatchNorm2d): 读取Conv_Out,计算BN,结果BN_Out写入显存。
  3. Kernel 3 (ReLU): 读取BN_Out,计算ReLU,结果ReLU_Out写入显存。
  4. Kernel 4 (Add): 读取ReLU_Out和residual,计算相加,最终结果Output写入显存。

可以看到,中间结果 Conv_Out, BN_Out, ReLU_Out 都被完整地写入和读出了一遍,造成了大量的显存带宽浪费。

在现代PyTorch (2.0及以后版本) 中,实现算子融合最简单、最强大的方式是使用 torch.compile。

torch.compile 是一个即时编译器(Just-In-Time, JIT),它的工作流程大致如下:

  1. Graph Acquisition (图捕获):torch.compile 使用一个名为 TorchDynamo 的技术来安全地捕获Python代码执行的计算图
  2. Graph Lowering (图降级):将捕获到的计算图转换成一种更底层的、与硬件无关的中间表示(IR)。
  3. Graph Compilation (图编译):由后端编译器(如 TorchInductor)接管。TorchInductor会分析这个IR,进行各种优化,其中就包括算子融合。它会智能地识别出像 Conv->BN->ReLU 这样的可融合模式,并将它们合并成一个优化的Kernel。TorchInductor通常会将这些融合后的算子编译成高效的Triton或C++代码。

只需要一行代码,就可以让PyTorch自动完成优化工作。

# 原始模型
model = ResidualBlock(channels=128)
 
# 使用torch.compile进行优化
optimized_model = torch.compile(model)

伪代码逻辑如下:

// Fused Kernel伪代码
__global__ void fused_conv_bn_relu(float* input, float* output, /* other params */) {
    // 1. 从全局显存加载一小块输入数据到共享内存(Shared Memory)或寄存器(Registers)
    // ... load data ...
 
    // 2. 在片上执行卷积计算
    float conv_result = perform_convolution(...);
 
    // 3. 立即用卷积结果进行BN计算,参数(gamma, beta, mean, var)已预先加载
    float bn_result = (conv_result - mean) / sqrt(var + epsilon) * gamma + beta;
 
    // 4. 立即用BN结果进行ReLU计算
    float relu_result = max(0.0f, bn_result);
 
    // 5. 将最终结果写回全局显存
    output[...] = relu_result;
}

在这个融合的Kernel中,conv_result 和 bn_result 都是存在于GPU核心旁边的极快存储中的临时变量,它们未被写入到位于显卡PCB板上的全局显存颗粒中。

在推理(Inference/Eval模式) 阶段,融合可以做得更彻底。

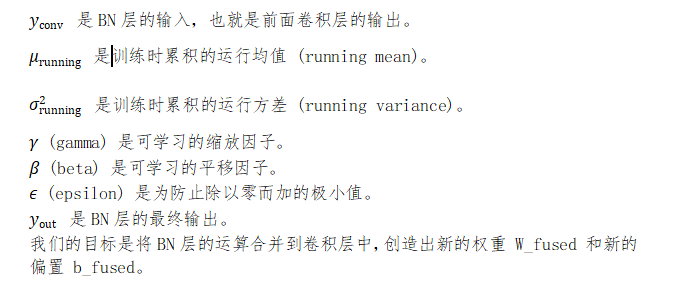
BatchNorm层的均值(running_mean)和方差(running_var)是固定的。因此,它的线性运算可以被数学上折叠(Fold) 到前面的卷积层中。

假设我们有一个输入 x,它先经过一个卷积层,再经过一个批标准化(BN)层。

我们来看数学公式:

卷积层 (Conv2d)的计算是:
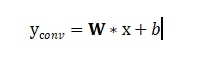
批标准化层 (BatchNorm2d):
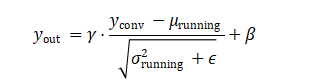
第1步:代入

将第一个公式(卷积层输出)代入第二个公式(BN层)中的 y_conv:
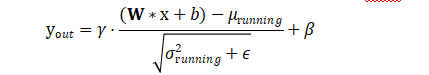
第2步:展开与重新组合

现在,我们对这个公式进行代数变换,把与输入 x 相关和不相关的项分开。

首先,把分母提出来,整理括号里的项:
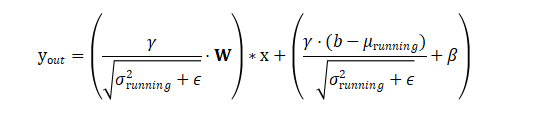
第3步:定义新的权重和偏置

观察上面的公式,它已经变回了 (新权重 * x) + 新偏置 的形式!我们只需要定义:

融合后的新权重 W_fused:
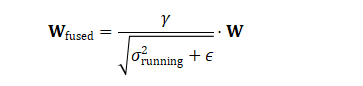
融合后的新偏置 b_fused:
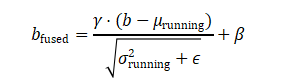
注意:如果原始卷积层没有偏置(bias=False),那么上式中的 b 就当作 0 来计算。

经过融合,原来的 Conv -> BN 两步计算,现在可以被一个单一的、带有新权重和新偏置的卷积层完全等效替代:

yout​=Wfused​∗x+bfused​

在推理时,编译器或部署工具会预先计算好 W_fused 和 b_fused。这样一来,原始的BN层就彻底消失了,它的所有数学作用都被完美地吸收进了卷积层。这不仅减少了一次内存读写和一次Kernel启动,还消除了BN层本身的计算,从而带来显著的加速效果。

5.总结

算子融合是深度学习性能优化的良好方法,它通过将多个操作合并为单一内核,从根本上解决了由内存访问延迟引起的性能瓶颈。

对于日常训练和开发,torch.compile 提供了最便捷、最智能的自动化融合方案。

对于追求极致推理性能的部署场景,手动折叠(如 Conv+BN Folding) 等技术能提供更进一步的优化。

希望本教程能帮助大家更好地理解并应用算子融合技术。

【深度学习编译器系列】4. 前端优化:算子融合 不同深度学习编译器的算子融合规则根据它们各自的算子能力而有所不同。不同深度学习编译器的算子融合算法主要分为两大类,一类是以TVM为代表的通用算子融合算法,它在算子级别做了融合规则的分类,然后用一个通用的算法对计算图上的所有算子进行融合。另一类是像XLA/Pytorch/OpenVINO这些,采用的是更加细粒度的算子融合算法,对于不同的规则定制不同的pass/function,然后这些pass都在计算图上进行遍历,最终输出优化后的计算图。 阅读详情

相关推荐

AI模型部署实战:量化、蒸馏与TensorRT优化实现10倍推理加速

模型压缩与加速是深度学习从实验室走向生产环境的关键技术,其核心在于解决模型推理速度慢、资源占用高的问题。从原理上看,它通过算法和系统优化,减少模型的计算量和内存需求。在技术价值上,它能显著降低部署成本、提升响应速度,是AI应用商业化的基石。应用场景广泛,涵盖云端服务器、边缘设备和移动端。本文聚焦于量化、知识蒸馏等核心热词,结合TensorRT等推理引擎,提供从诊断瓶颈到实战部署的全流程方案,帮助工程师实现数量级的性能飞跃。

weixin_34221775的博客 371

深度分析算子融合(TVM)

在计算机科学和特别是深度学习和机器学习领域,算子(Operator)或称为操作(Operation),是指在一个或多个数据上执行特定计算或变换的函数或算法。算子是构建和训练神经网络模型的基本构建块,它们定义了数据如何被处理和转换。

lay523的博客 3718

C++构建电商实时画像系统:高并发架构与性能优化实战

在实时数据处理领域,系统架构设计与性能优化是核心技术挑战。其原理在于通过高效的数据结构、并发模型和内存管理,实现对海量数据流的低延迟处理。这项技术的核心价值在于能够显著提升数据处理吞吐量、降低响应延迟,并优化硬件资源利用率,从而有效控制运营成本。在电商、广告、金融风控等对实时性要求极高的应用场景中,高性能计算引擎是支撑实时用户画像、个性化推荐等业务的关键基础设施。本文聚焦于如何利用C++语言特性,结合**无锁数据结构**和**SIMD指令集**优化,构建一套应对日均百亿级事件流的电商实时画像系统,详细剖析了

weixin_30455023的博客 484

TVM系列 - 图优化 - 算子融合

TVM系列 - 图优化 - 算子融合 图优化综述 声明一下,本文所有的理解都是基于个人理解。 图优化算是一个推理框架前端比较成熟的操作了,一般来说,针对模型做图优化有两个目的(对于通用框架来说,就加速减少计算一个目的了): 减少Node的数量, 不管是算子融合,还是无效节点去除,共同的目的就是减少整个graph中node的数量,因为对于框架来说,从一个node到另一个node之间就意味着数据的搬运。举个例子,我们知道算子合并最经典的就是将BN层融合到Conv层,我们姑且不论融合后计算量的减少,单单是减少了

Artyze的博客 1万+

mmgl:专为Transformer模型设计的C++高效推理库

Transformer架构作为现代深度学习,特别是大语言模型(LLM)和视觉Transformer(ViT)的核心,其高效推理部署是工程实践中的关键挑战。其原理基于自注意力机制,通过并行计算处理序列数据,在自然语言处理和计算机视觉领域展现出巨大技术价值。在实际应用场景中,开发者常需将训练好的模型集成到C/C++原生环境,如高性能服务器或资源受限的边缘设备,此时对推理引擎的轻量化、高性能和精细控制提出了更高要求。针对这一需求,mmgl库应运而生,它专注于Transformer模型的高效推理,通过纯C++实现、

weixin_33946020的博客 375

『算法理论学』深度学习推理加速方法之网络层与算子融合

首发于AI深度学习应用之路 写文章 任何事物都有连续性 --《极简主义》范式三:保持连续性的思维可以事半功倍 0.引子 在深度学习推理方面有多种提速方法,如模型剪枝量化与层算子融合等。 网络层与算子融合是非常有效的方法,本文将配合TensorRT与tflite推理框架介绍下网络层与算子融合的原理与应用。 1.融合理论 下面配合TensorRT介绍下网络层与算子融合的原理。 这是一个原始的Inception Block,首先input后会有多个卷积,卷积完后有Bia...

简明AI工作室 5432

算子融合(Operator Fusion):让 CUDA Kernel 告别访存瓶颈

将几个简单的算子融合只是开胃小菜。这项技术的终极浪漫在于打破模块间的宏观壁垒。例如极大提升大语言模型推理速度的核心技术,其本质也是一种极其复杂的算子融合。它通过精妙的分块(Tiling)算法,将复杂的机制(如矩阵乘法、Mask、Softmax 等数十个步骤)强行揉进了一个庞大的 Kernel 中,确保数据一旦被拉入 GPU 高速缓存(SRAM),就被榨干所有的计算价值后再放回显存。看到零碎的代码,脑海中浮现出硬件内部数据的流动轨迹,并试图用融合的思维将其截断,是实现极限性能优化的核心直觉。

m0_69378371的博客 442

【信息科学与工程学】【数据中心】 第十九篇 MFU的优化提升方法01

MFU作为一个综合性能指标,清晰地揭示了下游任务(模型训练/推理)对上游计算资源(GPU集群)的实际利用效率。它不仅是技术能力的体现,更直接关系到企业的运营成本和AI创新的速度。追求更高的MFU,本质上是在有限的资源和无限的算力需求之间寻找最优解,是AI基础设施领域持续演进的核心动力。总而言之,数据中心CPU的MFU不仅仅是一个软件性能指标,它是计算芯片微架构、服务器硬件设计、数据中心基础设施以及软件算法协同工作效果的终极体现。

weixin_49199313的博客 1240

Unity Sentis实战:从ONNX模型到GPUCompute加速推理全流程解析

ONNX(Open Neural Network Exchange)作为开放的神经网络交换格式,实现了不同深度学习框架间模型的标准化互操作。其原理在于将计算图结构、层参数与张量信息封装为统一中间表示,使模型具备跨平台移植能力。这一技术价值在于极大降低了AI模型在边缘设备与实时应用中的部署门槛,使开发者无需依赖云端服务或复杂本地环境。在游戏开发、移动应用等场景中,ONNX结合专用推理引擎能实现低延迟、高并发的模型执行。本文聚焦于Unity Sentis这一官方解决方案,详细阐述如何将PyTorch训练的模型经

weixin_30920597的博客 392

C语言实战:高效端口扫描器的多线程优化与性能对比

本文详细介绍了使用C语言开发高效端口扫描器的多线程优化技术,包括TCP全连接扫描、SYN半连接扫描和FIN扫描的实现原理。通过线程池、I/O复用技术和性能优化策略,显著提升扫描效率,并与Nmap进行性能对比。文章还涵盖了常见问题解决方案及安全伦理注意事项,为开发者提供全面的实战指导。

ol789012的博客 134

CloudCompare横截面工具实战:从点云切片到轮廓提取的完整流程

本文详细介绍了CloudCompare软件中Cross Section工具的核心功能与实战流程。从交互式裁剪框的精准操控,到包络线提取的参数设置与优化,再到内部轮廓提取及批量处理技巧,完整解析了如何从三维点云中高效提取建筑立面、隧道断面等关键轮廓信息,是点云数据处理与分析的实用指南。

weixin_29290963的博客 284

DeltaSplice-Human:40M参数与164万FLOPs的高效模型设计解析

在深度学习模型部署与优化领域,参数量与计算效率是衡量模型实用性的核心指标。参数本质上是模型从训练数据中学到的内在规则的数字化表达,其规模直接影响模型的存储与内存占用。而计算量通常以FLOPs衡量,决定了模型推理速度与能耗,这与硬件算力指标TOPS共同构成了评估模型部署可行性的关键。通过精巧的模型架构设计,如深度可分离卷积与线性注意力机制,可以在控制参数量的同时大幅降低FLOPs,实现精度与效率的平衡。这种高效设计对于移动端基因分析、边缘设备实时处理等计算资源受限场景具有重要价值,最终服务于像DeltaSpl

weixin_34034670的博客 317

GlobalPlatform Technology Secure Channel Protocol ‘03‘ 标准 - 安全通道协议简介

按照GlobalPlatform Technology Secure Channel Protocol '03' (SCP03)标准,描述了如何利用S-MAC,S-RMAC,S-ENC进行安全通信的过程。

mmmx777的专栏 6091

C++构建分布式语音识别系统:架构设计与性能优化实战

分布式系统通过将计算任务拆分到多台机器并行处理,有效解决了单机在并发、延迟和资源上的瓶颈。其核心原理在于利用数据并行或模型并行策略,结合高效的网络通信与资源调度,实现水平扩展与负载均衡。这一技术在高并发、低延迟的实时语音处理场景中价值尤为突出,例如在线会议、智能客服和车载语音系统,能够显著提升吞吐量与系统稳定性。本文聚焦于如何运用C++语言,从底层驱动分布式语音识别引擎的构建,深入探讨了包括gRPC通信、TensorRT推理加速在内的关键技术实现,为海量语音流的实时处理提供了可扩展的工程解决方案。

weixin_33770878的博客 364

张量分解浅谈(四 Tucker 分解)

学完了SVD算法之后,我们继续回到张量几大分解的学习上来,本期学习的主要内容是张量的 Tucker 分解 以及 前面的CP分解还留下一点没有说完,正好一并补齐!后面的公式我将采用颜色标记,红色代表必须掌握,蓝色尽量掌握! 在这之前先附一张图,包含了各种运算符号的名称含义,大部分是前面说过或者使用过的: Tensor decomposition一 . Tucker 分解公式介绍和原理二 . 张量的 n-Rank 一 . Tucker 分解公式介绍和原理 我们先来看一张被使用过很多次的Trucker 分解图

欢迎来到 豪哥 的博客 1万+

保姆级教程:在RV1126开发板上跑通YOLOv5口罩检测(从数据集到摄像头实时识别)

本文提供了一份详细的RV1126开发板部署YOLOv5口罩检测系统的全流程指南,涵盖数据集准备、模型训练优化、边缘部署及实时摄像头识别等关键步骤。重点解析了RV1126开发板的性能特征、YOLOv5模型训练调优技巧、RKNN模型转换量化策略,以及部署过程中的性能优化方案,帮助开发者高效实现边缘端目标检测应用。

weixin_27310985的博客 108

从零构建AI系统:深入神经网络底层原理与工程实践

深度学习作为人工智能的核心技术,其本质是通过神经网络模型从数据中学习复杂模式。理解神经网络的工作原理,需要掌握前向传播、反向传播、梯度下降等基础概念,这些原理共同构成了模型训练和优化的数学基础。掌握这些底层知识不仅能提升模型调试和性能优化的能力,还能为构建可靠、高效的AI系统奠定坚实基础。在实际工程中,从模型训练到部署上线涉及多个关键环节,如模型序列化、服务化部署和性能优化。本文通过解析全连接层、激活函数、损失函数等核心组件的从零实现,结合梯度检查、向量化优化等实践技巧,探讨如何将AI原型转化为稳定可用的产

weixin_30416871的博客 377

ERA5气象数据下载与解压全攻略:Python脚本一键搞定(附错误处理技巧)

本文提供了一套完整的ERA5气象数据自动化处理方案,涵盖从CDS API配置、智能批量下载到高效解压与数据验证的全流程。重点介绍了如何通过Python脚本实现一键式数据下载与批量解压,并分享了实用的错误处理技巧与性能优化策略,帮助科研人员高效获取和处理大规模气象数据。

k8l9m0n的博客 337

神经网络算子融合的几种方式

几种常见的神经网络算子融合方式

limengshi138392的博客 2238

Python爬招聘网站:Selenium+ActionChains破解滑动验证码,批量采集岗位数据(新手可跑)

通过本文实战,你不仅学会了用Selenium+ActionChains破解滑动验证码,还掌握了爬虫的核心优化思路——“模拟人类行为”是突破反爬的关键。这套逻辑不仅适用于招聘网站,还能迁移到其他有滑动验证码的平台(如电商、资讯网站)。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1187

【CANoe】CAPL_UDS安全算法dll制作

使用UDS进行刷写时,需要27服务解密后,才能正确执行刷写,本文提供两种制作27解密dll的方法,用于CANoe的CAPL脚本中。

星Yeah 的博客 1万+

量化之------算子融合

此外,还需要考虑硬件和软件的兼容性,因为不是所有的算子组合都能从硬件加速中受益。具体的实现会依赖于使用的深度学习框架和硬件架构。归一化层(如Layer Normalization, Batch Normalization等)后通常会接一个激活函数。如果一个操作的输出是另一个操作的输入,并且两个操作都是ElementWise的,那么它们可以融合。将这两个层融合可以减少对内存的访问和提高计算效率。这两个算子可以融合在一起,避免额外的内存访问。在一些操作中,如在计算梯度时,求和和乘法操作可以一起执行。

qq_40962125的博客 1309

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

pytorch中conv和bn算子融合

在模型优化的过程中必不可少的就是算子融合了,最近在一个项目中使用了resnet其中使用很多的bn,这就必须要优化了,在优化之后推理时间提高了百分之四十。 这部分代码是自己在网上查找资料写的,在查找的时候又在偶然中发现在pytorch1.10中有一个fx的库是可以很好处理这方面的东西的。后续我会对这个进行补充。 话不多说直接上代码: import os import torch import torch.nn as nn from build_net import make_fuse_model from

黄小黄的窝 3629

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

图神经网络设计中的算子融合策略

©作者 |刘曜齐单位|北京邮电大学硕士生来源|北邮GAMMA Lab本文主要的描述基于消息传递机制的图神经网络设计中应用的算子融合策略,带领读者了解有关算子融合的相关问题以及方法。引言目前,图神经网络(GNN)的程序编写主要依赖 GNN 框架,例如 PyG,DGL 等,并从中享受到高效的设计。现有的 GNN 设计大多基于消息传递机制,包括三大步骤:消息创建,消息聚合,特征更新。假定图 ...

Paper weekly 1304

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

【算子融合】Conv+BatchNorm+Relu

本文以公式推导的形式,介绍了为啥Conv+BatchNorm+Relu会和单纯的Conv消耗的时间是一样的。实际上,Conv+BatchNorm+Relu也可以推导成Conv的形式。仅仅是这个简单的计算公式,可随意进行添加。

零碎@流年絮语 的博客 2175

神经网络算子融合

算子融合技术

bbbeoy的专栏 1236
上一篇: Pytorch模型训练流程(简化标准版)
下一篇: ConvMixer模型:纯卷积为何能够媲美Transformer架构?深入浅出原理与Pytorch代码逐行讲解实现
黑箱内外
博客等级 码龄5年 1062粉丝 179原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值