


主要内容
- 1、剖析MapReduce作业运行机制
- 2、shuffle和排序
- 3、任务的执行
- 4、作业的调度
- 5、YARN平台简介
- 6、YARN的架构
一、剖析MapReduce作业运行机制
可以通过一个简单的方法调用来运行MapReduce作业:Job对象上的submit()。注意,也可以调用waitForCompletion(),它用于提交之前没有处理过的作业,并等待它的完成。submit()方法调用封装了大量的处理细节。
主从结构
- 主节点只有一个:JobTracker
- 从节点有很多个:TaskTracker
JobTracker负责
- 接收客户提交的计算任务
- 把计算任务分给TaskTracker执行
- 监控TaskTracker的执行情况
TaskTracker负责
- 执行JobTracker分配的计算任务
运行图
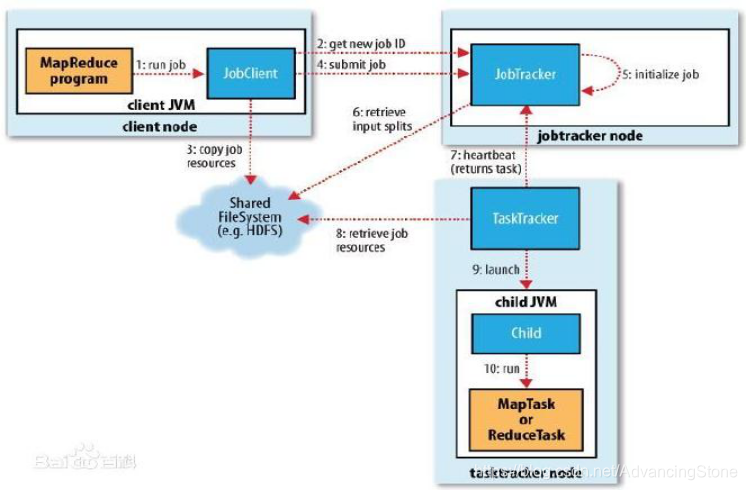
运行解析
- 作业的提交
- JobClient的run job()方法是用于新建JobClient实例并调用其submit job()方法的便捷方式(见图步骤1)。提交作业后,run job()每秒轮询作业的进度.如果发现自上次报告后有改变,便把进度报告到控制台。作业完成后,如果成功,就显示作业计数器。如果失败,导致作业失败的错误被记录到控制台。
- JobClient的submit job()方法所实现的作业提交过程如下:
- 向job tracker请求一个新的作业ID,通过调用JobTracker的getNewjobld()方法获取(步骤2)。
- 检查作业的输出说明。例如,如果没有指定输出目录或输出目录已经存在,作业就不提交,错误抛回给MapReduce程序。
- 计算作业的输入分片。如果分片无法计算,比如因为输入路径不存在,作业就不提交,错误返回给MapReduce程序。
- 将运行作业所需要的资源(包括作业JAR文件、配置文件和计算所得的输入分片)复制到一个以作业ID命名的目录下job tracker的文件系统中。作业JAR的副本较多(由mapred.submit.replication属性控制,默认值为10),因此在运行作业的任务时,集群中有很多个副本可供task tracker访问(步骤3)。
- 告知job tracker作业准备执行(通过调用JobTracker的submit job()方法实现)(步骤4)。
- 作业的初始化
- 当JobTracker接收到对其submit job()方法的调用后,会把此调用放入一个内部队列中,交由作业调度器(job scheduler)进行调度,并对其进行初始化。初始化包括创建一个表示正在运行作业的对象——封装任务和记录信息,以便跟踪任务的状态和进程(步骤5)。
- 为了创建任务运行列表,作业调度器首先从共享文件系统中获取JobClient已计算好的输入分片信息(步骤6)。然后为每个分片创建一个map任务。
- 创建的reduce任务数量由Job的mapred.reduce.task属性决定(setNumReduceTasks()设置),schedule创建相应数量的reduce任务。 任务在此时被指定ID。
- 除了map和reduce任务,还有setupJob和cleanupJob需要建立:由task trackers在所有map开始前和所有reduce结束后分别执行,这两个方法在OutputCommitter中(默认是FileOutputCommitter)。setupJob()创建输出目录和任务的临时工作目录,cleanupJob()删除临时工作目录。
- 作业分配
- tasktracker运行一个简单的循环来定期发送“心跳”(heartbeat)给jobtracker。“心跳”告知jobtracker,tasktracker是否还存活,同时也充当两者之间的消息通道。作为“心跳”的一部分,tasktracker是指明它是否已经准备好运行新的任务,如果是jobtracker会为它分配一个任务,并使用“心跳”的返回值与tasktracker进行通信(步骤7)。
- 每个tasktracker会有固定数量的map和reduce任务槽,数量有tasktracker核的数量和内存大小来决定。jobtracker会先将tasktracker的所有的map槽填满,然后才填此tasktracker的reduce任务槽。
- Jobtracker分配map任务时会选取与输入分片最近的tasktracker,分配reduce任务用不着考虑数据本地化。
- 任务的执行
- 通过从共享文件系统把作业的JAR文件复制到tasktracker所在的文件系统,从而实现作业的JAR文件本地化。同时,tasktracker将应用程序所需要的全部文件从分布式缓存复制到本地磁盘(步骤8)。
- tasktracker为任务新建一个本地工作目录,并把JAR文件中的内容解压到这个文件夹下。
- tasktracker新建一个TaskRunner实例来运行该任务(步骤9)。
- TaskRunner启动一个新的JVM来运行每个任务(步骤10),以便客户的map/reduce不会影响tasktracker。
- 进度和状态的更新
- MapReduce作业是长时间运行的批量作业,运行时间范围从数秒到数小时。这是一个很长的时间段,所以对于用户而言,能够得知作业进展是很重要的。一个作业和它的每个任务都有一个状态(status),包括:作业或任务的状态(比如,运行状态,成功完成,失败状态)、map和reduce的进度、作业计数器的值、状态消息或描述(可以由用户代码来设置)。
- map进度标准是处理输入所占比例,reduce是copy\merge\reduce(与shuffle的三个阶段相对应)整个进度的比例。
- Child JVM有独立的线程每隔3秒检查任务更新标志,如果有更新就会报告给此tasktracker;
- tasktracker每隔5秒给jobtracker发心跳;
- job tracker合并这些更新,产生一个表明所有运行作业及其任务状态的全局试图。
- JobClient通过每秒查询Jobtracker来接收最新状态。
- 作业的完成
- 当jobtracker收到作业最后一个任务已完成的通知后,便把作业的状态设置为“成功”。然后,在JobClient查询状态时,便知道任务已成功完成,于是JobClient打印一条消息告知用户,然后从runjob()方法返回。
- 如果jobtracker有相应的设置,也会发送一个HTTP作业通知。希望收到回调指令的客户端可以通过job.end.notification.url属性来进行这项设置。最后,jobtracker清空作业的工作状态,指示tasktracker也清空作业的工作状态
二、shuffle和排序
-
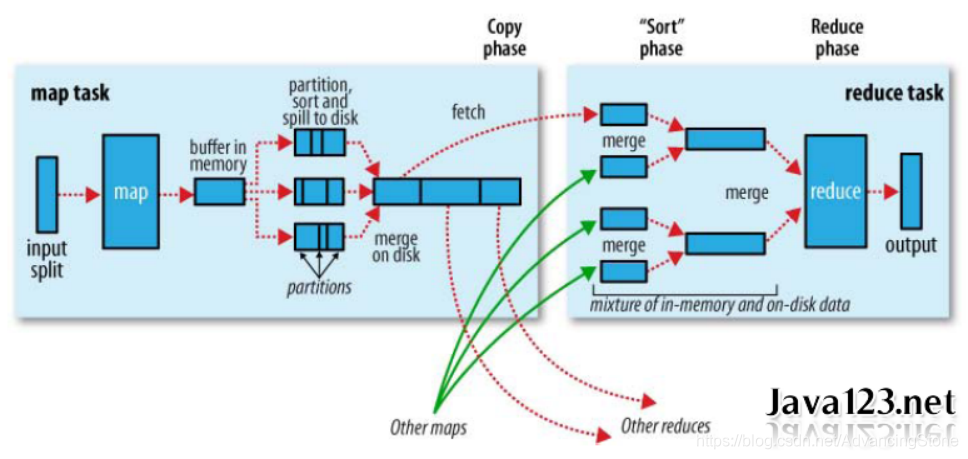
Mapreduce为了确保每个reducer的输入都按键排序。系统执行排序的过程-----将map的输出作为输入传给reducer 称为shuffle。
-
shuffle属于hadoop不断被优化和改进的代码库的一部分。
-
Map端
- map函数开始产生输出时,并不是简单地将它输出到磁盘。这个过程更复杂,利用缓冲的方式写到内存,并出于效率的考虑进行预排序。
- 每个map任务都有一个环形内存缓冲区,用于存储任务的输出。默认情况是100MB,可以通过io.sort.mb属性调整。一旦缓冲内容达到阀值(io.sort.spill.percent,默认0.80,或者80%),一个后台线程开始把内容写到磁盘中。在写磁盘过程中,map输出继续被写到缓冲区,但如果在此期间缓冲区被填满,map会阻塞直到写磁盘过程完成。在写磁盘之前,线程首先根据数据最终要传送到reducer把数据划分成相应的分区,在每个分区中,后台线程按键进行内排序,如果有一个combiner,它会在排序后的输出上运行。
- 一旦内存缓冲区达到溢出写的阙值,就会新建一个溢出写文件,因此在map任务写完其最后一个输出记录之后,会有几个溢出写文件。在任务完成之前,溢出写文件被合并成一个已分区且已排序的输出文件。配置属性io.sort.factor控制着一次最多能合并多少流,默认值是10。
- 如果已经指定combiner,并且溢出写次数至少为3(min.num.spills.for.combine属性的取值)时,则combiner就会在输出文件写到磁盘之前运行。前面曾讲过,combiner可以在输入上反复运行,但并不影响最终结果。运行combiner的意义在于使map输出更紧凑,使得写到本地磁盘和传给reducer的数据更少。
- 写磁盘时压缩map输出往往是个很好的主意,因为这样会让写磁盘的速度更快,节约磁盘空间,并且减少传给reducer的数据量。默认情况下,输出是不压缩的,但只要将mapred.compress.map.output设置为true,就可以轻松启用此功能。
- reducer通过HTTP方式得到输出文件的分区。用于文件分区的工作线程的数量由任务的tracker.http.threads属性控制,此设置针对每个tasktracker,而不是针对每个map任务槽。默认值是40,在运行大型作业的大型集群上,此值可以根据需要调整。
- Reduce端
- map输出文件位于运行map任务的tasktracker的本地磁盘(注意,尽管map输出经常写到map tasktracker的本地磁盘,但reduce输出并不这样),现在,tasktracker需要为分区文件运行reduce任务。更进一步,reduce任务需要集群上若干个map任务的map输出作为其特殊的分区文件。每个map任务的完成时间可能不同,因此只要有一个任务完成,reduce任务就开始复制其输出。这就是reduce任务的复制阶段(copy phase)。reduce任务有少量复制线程,因此能够并行取得map输出。默认值是5个线程,但这个默认值可以通过设置mapred.reduce.parallel.copies属性来改变。
- 由于reducer可能失败,因此tasktracker并没有在第一个reducer检索到map输出时就立即从磁盘上删除它们。相反,tasktracker会等待,直到jobtracker告知它可以删除map输出,这是作业完成后执行的。
- 如果map输出相当小,则会被复制到reduce tasktracker的内存(缓冲区大小由mapred.job.shuffle.input.buffer.percent属性控制,指定用于此用途的堆空间的百分比),否则,map输出被复制到磁盘。一旦内存缓冲区达到阙值大小(由mapred.iob.shuffle.merge.percent决定)或达到map输出阙值(由mapred.1nmem.merge.threshold控制),则合并后溢出写到磁盘中。
- 随着磁盘上副本的增多,后台线程会将它们合并为更大的、排好序的文件。这会为后面的合并节省一些时间。注意,为了合并,压缩的map输出(通过map任务)都必须在内存中被解压缩。
- 复制完所有map输出被复制期间,reduce任务进入排序阶段(sort phase更恰当的说法是合并阶段,因为排序是在map端进行的),这个阶段将合并map输出,维持其顺序排序。这是循环进行的。比如,如果有50个map输出,而合并因子(merge factor)是10(10为默认设置,由io.sort.factor属性设置,与map的合并类似),合并将进行5趟。每趟将10个文件合并成一个文件,因此最后有5个中间文件。
- 在最后阶段,即reduce阶段,直接把数据输入reduce函数,从而省略了一次磁盘往返行程,并没有将这5个文件合并成一个已排序的文件作为最后一趟。最后的合并既可来自内存和磁盘片段。
- 在reduce阶段,对已排序输出中的每个键都要调用reduce函数。此阶段的输出直接写到输出文件系统,一般为HDFS。
三、任务的执行
- 任务执行环境
- Hadoop为map任务或reduce任务提供运行环境相关信息。例如,map任务可以知道它处理的文件的名称,map任务或reduce任务可以得知任务的尝试次数,任务执行环境的属性可以从作业的配置信息中获得,通过为mapper或reducer提供一个configure()方法实现(其中,配置信息作为参数进行传递),便可获得这一信息。
- 推测执行
- MapReduce模型将作业分解成任务,然后并行地运行任务以使作业的整体执行时间少于各个任务顺序执行的时间。这使作业执行时间对运行缓慢的任务很敏感,因为只运行一个缓慢的任务会使整个作业所用的时间远远长于执行其他任务的时间。当一个作业由几百或几千任务组成时,可能出现少数“拖后腿”的任务是很常见的。
- 任务执行缓慢可能有多种原因,包括硬件老化或软件配置错误,但是,检测具体原因很困难,因为任务总能够成功完成,尽管比预计执行时间长。Hadoop不会尝试诊断或修复执行慢的任务,相反,在一个任务运行比预期慢的时候,它会尽量检测,并启动另一个相同的任务作为备份。这就是所谓的任务的“推测执行”(speculative execution).
- 如果同时启动两个重复的任务,它们会互相竞争,导致推测执行无法工作。这对集群资源是一种浪费。相反,只有在一个作业的所有任务都启动之后才启动推测执行的任务.并且只针对那些已运行一段时间(至少一分钟)且比作业中其他任务平均进度慢的任务。一个任务成功完成后,任何正在运行的重复任务都将被中止,因为已经不再需要它们了。因此,如果原任务在推测任务前完成,推测任务就会被终止;同样地,如果推测任务先完成,那么原任务就会被中止。
- 推测执行是一种优化措施,它并不能使作业的运行更可靠。如果有一些软件缺陷会造成任务挂起或运行速度减慢,依靠推测执行来避免这些问题显然是不明智的,并且不能可靠地运行,因为相同的软件缺陷可能会影响推测式任务。应该修复软件缺陷,使任务不会挂起或运行速度减慢。
- 默认情况下,推测执行是启用的。可以基于集群或基于每个作业,单独为map任务和reduce任务启用或禁用该功能。
- 任务JVM重用
- Hadoop在它们自己的Java虚拟机上运行任务,以区分其他正在运行的任务。为每个任务启动一个新的JVM将耗时大约1秒,对运行1分钟左右的作业而言,这个额外消耗是微不足道的。但是,有大量超短任务(通常是map任务)的作业或初始化时间长的作业,它们如果能对后续任务重用JVM.就可以体现出性能上的优势。
- 启用任务重用JVM后,任务不会同时运行在一个JVM上。JVM顺序运行各个任务。然而,tasktracker可以一次性运行多个任务,但都是在独立的JVM内运行的。
- 控制任务JVM重用的属性是mapred.job.reuse.jvm.num.tasks.它指定给定作业每个JVM运行的任务的最大数,默认值为1。不同作业的任务总是在独立的JVM内运行。如果该属性设置为-1,则意味着同一作业中的任务都可以共享同一个JVM,数量不限。JobConf中的setNumTasksToExecutePerjvm()方法也可以用于设置这个属性。
- 跳过坏记录
-
大型数据集十分庞杂。它们经常有损坏的记录。它们经常有不同格式的记录。它们经常有缺失的字段。理想情况下,用户代码可以很好地处理这些情况。但实际情况中,忽略这些坏的记录只是权宜之计。取决于正在执行的分析,如果只有一小部分记录受影响,那么忽略它们不会显著影响结果。然而,如果一个任务由于遇到一个坏的记录而发生问题——通过抛出一个运行时异常——任务就会失败。失败的任务将被重新运行(因为失败可能是由硬件故障或任务可控范围之外的一些原因造成的),但如果一个任务失败4次,那么整个作业会被标记为失败。如果数据是导致任务抛出异常的“元凶”,那么重新运行任务将无济于事,因为它每次都会因相同的原因而失败。
-
处理坏记录的最佳位置在于mapper和reducer代码。可以检测出坏记录并忽略它,或通过抛出一个异常来中止作业运行。还可以使用计数器来计算作业中总的坏记录数,看问题影响的范围有多广。
-
极少数情况是不能处理的,例如软件缺陷(bug)存在于第三方的库中,无法在mapper或reducer中修改它。在这些情况下,可以使用Hadoop的skipping mode选项来自动跳过坏记录。启用skipping mode后,任务将正在处理的记录报告给tasktracker。任务失败时,tasktracker重新运行该任务,跳过导致任务失败的记录。
-
由于额外的网络流量和记录错误以维护失败记录范围,所以只有在任务失败两次后才会启用skipping mode。因此对于一个一直在某条坏记录上失败的任务,tasktracker将运行以下task attempt得到相应的结果。
(1)任务失败。
(2)任务失败。
(3)开启skipping mode。任务失败,但是失败记录由tasktracker保存。
(4)仍然启用skipping mode。任务继续运行,但跳过上一次尝试中失败的坏记录。 -
在默认情况下,skipping mode是关闭的,用SkipBadRedcord类单独为map和reduce任务启用此功能。
SkipBadRecords.setMapperMaxSkipRecords(conf, 5) -
分片中的所有坏记录,需要增加最多task attempt次数(通过mapred.map.max.attemps和mapred.reduce.max.attemps进行设置)。
-
Hadoop检测出来的坏记录以序列文件的形式保存在_logs/skip子目录下的作业输出目录中。在作业完成后,可查看这些记录(例如,使用hadoop fs-text)进行诊断。
四、作业的调度
-
在Hadoop中,MapReduce的调度器可以选择。默认的调度器是原始的基于队列的FIFO调度器,还有两个多用户调度器,分别名为公平调度器和计算能力调度。
-
公平调度器
- Fair Scheduler(公平调度器)的目标是让每个用户公平地共享集群能力。如果只有一个作业在运行,它会得到集群的所有资源。随着提交的作业越来越多,空闲的任务槽会以“让每个用户公平共享集群”这种方式进行分配。某个用户的一个短的作业将在合理的时间内完成,即便另一个用户的长时间作业正在运行而且还在运行过程中。
- 作业都被放在作业池中,在默认情况下,每个用户都有自己的作业池。提交作业数超过另一个用户的用户,不会因此而比后者获得更多集群资源。可以用map和reduce的任务槽数来定制作业池的最小容量,也可以设置每个池的权重。
- Fair Scheduler支持抢占,所以,如果一个池在特定的一段时间内未得到公平的资源共享,它会中止运行池中得到过多资源的任务,以便把任务槽让给运行资源不足的池。
- Fair Scheduler是一个后续模块。要使用它,需要将其JAR文件放在Hadoop的类路径(classpath),即将它从Hadoop的contrib/fairscheduler目录复制到lib目录。随后,像下面这样设置mapred.jobtracker.taskScheduler属性:
org. apache. hadoop. mapred. FairScheduler - 经过这样的设置后,即可运行Fair Scheduler。但要想充分发挥它特有的优势和了解如何配置它(包括它的网络接口),请参阅Hadoop友行版src/cqntrib/fairscheduler目录下的README文件。
- 计算能力调度
- 针对多用户调度,Capacity Scheduler采用的方法稍有不同。集群由很多队列组成(类似于Fair Scheduler的任务池,这些队列可能是层次结构的(因此,一个队列可能是另一个队列的孩子),每个队列有一个分配能力。这一点与Fair Scheduler类似,只不过在每个队列内部,作业根据FIFO方式(优先级)进行调度。本质上,Capacity Scheduler允许用户或组织(使用队列进行定义)为每个用户或组织模拟一个独立的使用FIFO Scheduling的MapReduce集群。相比之下,Fair Scheduler(实际上支持[优先级]作业池内的FIFO作业调度,使其类似于能力调度)强制每个池内公平共享,使运行的作业共享池的资源。
五、YARN平台简介
- YARN的诞生
- 在Hadoop1.0版本中MapReduce架构存在的许多问题,例如:
(1)无法支持更多的计算模型:MapReduce将两阶段计算模型Map-Reduce固化到Hadoop中系统中,无法很容易的支持更多的计算框架,比如DAG或者迭代计算框架,尽管当前很多计算框架,比如Giraph,通过在Map-Only类型的作业中初步实现了BSP模型,但用于Map类型资源均是一样的,无法实现资源定制化;
(2)应用程序相关和资源管理相关的逻辑全部放在一个服务(JobTracker)中,使得主服务压力过大,进而限制了系统的扩展性。 - 为了解决这些问题,YARN便诞生了
- YARN的作用
- Yarn/MRv2最基本的想法是将原JobTracker主要的资源管理和job调度/监视功能分开作为两个单独的守护进程。有一个全局的ResourceManager(RM)和每个Application有一个ApplicationMaster(AM),Application相当于map-reduce job或者DAG jobs。
- ResourceManager和NodeManager(NM)组成了基本的数据计算框架。
ResourceManager协调集群的资源利用,任何client或者运行着的applicatitonMaster想要运行job或者task都得向RM申请一定的资源。 - ApplicatonMaster是一个框架特殊的库,对于MapReduce框架而言有它自己的AM实现,用户也可以实现自己的AM,在运行的时候,AM会与NM一起来启动和监视tasks。
六、YARN的架构
-
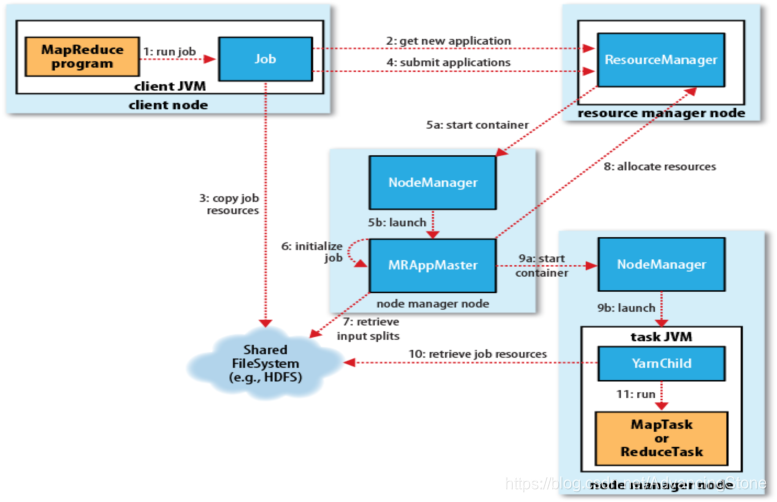
YARN架构图,如下:
-
作业提交
- MapReduce 2中的作业提交是使用与MapReduce 1相同的用户API(步骤1)
- MapReduce 2实现了ClientProtocol,当mapreduce.framework.name设置为yarn时启动。提交的过程与经典的非常相似。从资源管理器(而不是jobtracker)获取新的作业ID,在YARN命名法中它是一个应用程序ID(步骤2)。
- 作业客户端检查作业的输出说明,计算输入分片(虽然有选项yarn.app.mapreduce.am.compute-splits-in-cluster在集群上来产生分片,这可以使具有多个分片的作业从中受益)并将作业资源(包括作业JAR、配置和分片信息)复制到HDFS(步骤3)。
- 最后,通过调用资源管理器上的submitApplication()方法提交作业(步骤4)。
- 作业初始化
- 资源管理器收到调用它的submitApplication()消息后,便将请求传递给调度器(scheduler)。调度器分配一个容器,然后资源管理器在节点管理器的管理下在容器中启动应用程序的master进程(步骤5a和5b)。
- MapReduce作业的application master是一个Java应用程序,它的主类是MRAppMaster。它对作业进行初始化:通过创建多个对象以保持对作业进度的跟踪,因为他将接受来自任务的进度和完成报告(步骤6)。
- 接下来,它接受来自共享文件系统的在客户端计算的输入分片(步骤7)。对每一个分片创建一个map任务对象以及有mapreduce.job.reduces属性确定的多个reduce任务对象。
- 分配任务
- 如果作业不适合作为uber任务运行,那么application master就会为该作业中的所有map任务和reduce任务向资源管理器请求容器(步骤8)。附着心跳信息的请求包括每个map任务的数据本地化信息,特别是输入分片所在的主机和相应机架信息。调度器使用这些信息来做调度决策(像jobtracker的调度器一样)。
- 任务执行
- 一旦资源管理器的调度器为任务分配了容器,application master就通过与节点管理器通信来启动容器(步骤9a和9b)。
- 该任务由主类为YarnChild的Java应用程序执行。在它运行任务之前,首先将任务需要的资源本地化,包括作业的配置。JAR文件和所有来自分布式缓存的文件(步骤10)。
- 最后,运行map任务或reduce任务(步骤11)。
- YARN是Yet Another Resource Negotiator的简称,它仍可认为采用了master/slave结构,总体上采用了双层调度架构,它主要以下几部分组成:
- ResourceManager:负责资源管理的主服务,整个系统只有一个,负责资源管理、调度和监控,它支持可插拔的资源调度器,自带了FIFO、Fair Scheduler和Capacity Scheduler三种调度器;
- NodeManager:负责单个节点的资源管理和监控,它定期将资源使用情况汇报给ResourceManager,并接收来自ApplicationMaster的命令以启动Container(YARN中对资源的抽象),回收Container等;
- ApplicationMaster:负责管理单个应用程序,它向ResourceManager申请资源,并使用这些资源启动内部的任务,同时负责任务的运行监控和容错等;
- Container:对资源的抽象,它封装了某个节点上的CPU、内存等资源,ApplicationMaster只有获得一个Container后才能启动任务,另外,ApplicationMaster本身也是运行在一个Container之中。
- container规范
- Container是YARN中资源的抽象,它封装了某个节点上一定量的资源(CPU和内存两类资源)。
- Container由ApplicationMaster向ResourceManager申请的,由ResouceManager中的资源调度器异步分配给ApplicationMaster;
- Container的运行是由ApplicationMaster向资源所在的NodeManager发起的,Container运行时需提供内部执行的任务命令(可以使任何命令,比如java、Python、C++进程启动命令均可)以及该命令执行所需的环境变量和外部资源(比如词典文件、可执行文件、jar包等)。
- 另外,一个应用程序所需的Container分为两大类,如下
- 运行ApplicationMaster的Container:这是由ResourceManager(向内部的资源调度器)申请和启动的,用户提交应用程序时,可指定唯一的ApplicationMaster所需的资源;
- 运行各类任务的Container:这是由ApplicationMaster向ResourceManager申请的,并由ApplicationMaster与NodeManager通信以启动之。
-
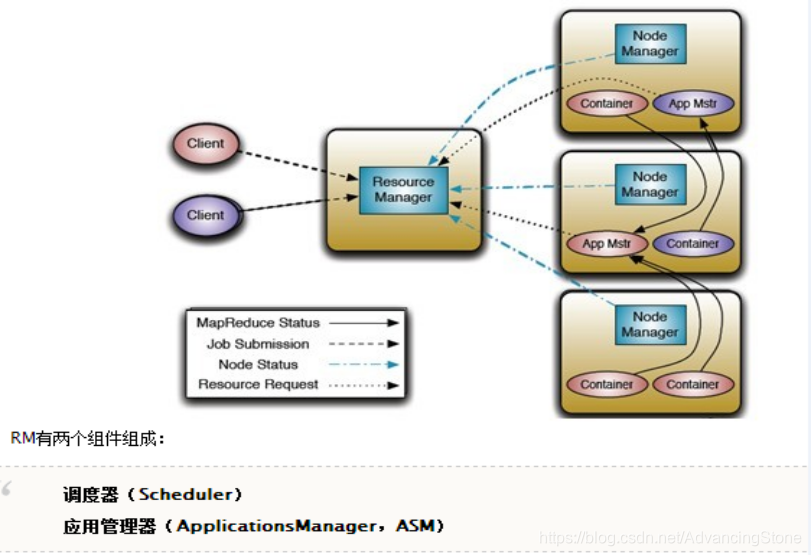
用户将应用程序提交到ResourceManager上
-
ResourceManager为应用程序ApplicationMaster申请资源,并与某个NodeManager通信,以启动ApplicationMaster;
-
ApplicationMaster与ResourceManager通信,为内部要执行的任务申请资源,一旦得到资源后,将于NodeManager通信,以启动对应的任务。
-
所有任务运行完成后,ApplicationMaster向ResourceManager注销,整个应用程序运行结束。

 1125


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


