


目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
大家好,这里是海浪学长计算机毕设专题,本次分享的课题是
🎯基于机器学习的高考辅导书籍推荐系统
项目背景
随着教育信息化的快速发展,学生在备战高考的过程中面临着海量的学习资源选择,如何从中筛选出适合自己的高考辅导书籍成为了一个亟待解决的问题。高考辅导书籍种类繁多,涵盖了各个学科和知识点,学生往往因缺乏有效的推荐工具而在学习资源的选择上感到困惑。推荐系统作为一种智能化的信息过滤技术,能够为学生提供个性化的书籍推荐,从而提高学习效率,增强学习体验。
数据集
通过分析用户的历史行为、兴趣偏好和学习需求,数据集是构建个性化推荐模型的基础,旨在为学生提供适合其学习需求的书籍推荐。数据集通常包括书籍的基本信息,还可能包含用户的行为数据,如用户对书籍的评分、购买记录和浏览历史,以及用户的基本信息。数据集的构建可以通过网络爬虫技术从各大在线书店、教育平台和论坛抓取数据,也可以利用公开的教育资源。高质量的数据集不仅需要准确和全面的信息,还需经过清洗和标注,以确保其一致性和有效性,从而为推荐算法提供可靠的数据支持,最终提升用户的学习体验和满意度。
设计思路
网络爬虫是一种自动化程序,旨在通过互联网收集和提取信息,其工作流程包括发送HTTP请求、解析网页内容、提取数据并将其存储到本地数据库或文件中。这种技术广泛应用于数据挖掘、搜索引擎索引、市场分析和竞争情报等领域。在构建高考辅导书籍推荐系统时,网络爬虫可以用于抓取各大在线书店和教育平台上的书籍信息,为简化爬虫开发过程,Scrapy作为一个强大的开源框架,提供了一整套工具和库,使得数据抓取变得高效而简单。支持异步处理、强大的选择器以及内置中间件,用户可以灵活定义爬虫类,抓取所需网页并提取相关数据,为高考辅导书籍推荐系统提供可靠的数据支持。

推荐系统旨在解决现代社会中信息过载的问题,通过高效地过滤和选择信息,帮助用户以个性化的方式检索符合个人需求的资源。在信息量爆炸性增长的背景下,用户常常面临选择困难,难以从海量信息中找到真正感兴趣的内容。推荐系统通过分析用户的历史行为、兴趣偏好和社交信息,智能地为用户推荐相关商品、服务或内容,进而提升用户体验并促进个性化服务的发展。这种技术在电商、社交媒体、在线内容平台等各个领域都发挥着至关重要的作用。
传统的推荐算法通常分为三大类:基于内容过滤的推荐算法、基于协同过滤的推荐算法以及混合推荐算法。基于内容过滤的推荐算法主要依赖于用户的过往选择和偏好记录,向用户推荐与其兴趣相似的物品。这类算法通过用户的显性或隐性反馈,分析用户的交互记录,学习并标记特征,计算用户喜好与待推荐物品内容的相似度,从而生成推荐列表。相对而言,基于协同过滤的推荐算法利用已有用户群体的历史行为数据,通过分析预测目标用户可能感兴趣的项目,可以分为基于用户的协同过滤和基于物品的协同过滤。混合推荐算法则整合了多种推荐算法的优势,弥补单一算法的局限性,以更全面地满足用户的个性化需求。

基于协同过滤的推荐算法是推荐系统中最为广泛应用的一类,其核心思想在于利用其他用户的历史行为数据来推测目标用户的兴趣。用户协同过滤通过计算用户相似性来筛选出与目标用户兴趣相近的邻近用户,进而推荐这些邻近用户所喜欢但目标用户尚未接触的物品。该算法的推荐过程包括用户相似性度量、邻近用户选择和推荐生成等步骤。

混合推荐算法通过集成多种推荐算法的优点,能够有效克服单一算法所带来的局限性。其常见类型包括加权融合、级联融合、并行融合、特征组合融合和模型集成混合。加权融合方法通过为不同推荐算法的输出结果赋予不同权重,结合这些加权结果生成最终推荐列表。级联融合则先使用一个算法生成初步推荐列表,再将其作为输入传递给其他算法进行精细化处理。并行融合允许多种推荐算法并行执行,然后将结果合并。特征组合融合通过整合不同算法提取的特征,形成更丰富的用户和物品特征表示,以构建推荐模型。模型集成混合通过对多个推荐模型的输出进行综合决策,形成最终推荐列表。这些方法的应用不仅提高了推荐系统的准确性,还增强了用户体验。

知识图谱是一种通过图形化的方式组织和表示知识的结构化数据,旨在将复杂的知识信息以图的形式呈现,从而实现知识的连接与理解。它由节点和边组成,节点通常代表实体(如人物、地点、物品等),而边则表示实体之间的关系(如“属于”、“位于”、“相关”等)。构建知识图谱的过程通常包括数据收集、数据清洗、实体识别和关系抽取等步骤。数据收集可以来自多种来源,如数据库、文本数据和社交媒体等。数据清洗则确保数据的质量和一致性,实体识别通过自然语言处理技术识别出文本中的关键实体,关系抽取则利用机器学习或规则基方法提取实体之间的关系。最终,这些步骤会形成一个结构化且可查询的知识图谱,为后续的应用提供基础。

通过网络爬虫技术,可以自动化地抓取所需数据,包括书籍的书名、作者、出版社、评分以及用户评论等。使用爬虫技术可以减少人工收集数据的时间和成本,并确保数据的广泛性和多样性。选择合适的网站和页面结构是非常重要的,这样才能有效提取有用信息。数据预处理是清洗和准备原始数据的过程,以确保数据质量和一致性。预处理的步骤包括去除重复项、处理缺失值以及数据格式转换等。数据清洗可以通过多种方法实现,比如使用Pandas库来处理和转换数据格式。数据预处理的目标是生成一个干净且结构化的数据集,为模型训练提供坚实的基础。
import scrapy

class BookSpider(scrapy.Spider):
    name = 'book_spider'
    start_urls = ['https://example.com/books']

    def parse(self, response):
        for book in response.css('div.book'):
            yield {
                'title': book.css('h2.title::text').get(),
                'author': book.css('p.author::text').get(),
                'rating': book.css('span.rating::text').get(),
                'reviews': book.css('p.review::text').get(),
            }
        next_page = response.css('a.next::attr(href)').get()
        if next_page is not None:
            yield response.follow(next_page, self.parse)
特征工程是将原始数据转换为适合模型训练特征的过程。它包括特征提取、特征选择和特征构建等步骤。在高考辅导书籍推荐系统中,可以通过分析用户行为数据(如评分、购买记录)和书籍特征(如类别、主题)来生成特征矩阵。特征提取可以使用自然语言处理技术,如TF-IDF(词频-逆文档频率),来提取书籍评论中的文本特征。这些特征将成为模型训练的输入,有助于提高推荐的准确性。采用混合推荐算法,将基于内容的推荐和协同过滤相结合。基于内容的推荐依赖于书籍的特征,而协同过滤则基于用户历史行为数据。这种混合方法可以提高推荐的准确性,适应不同用户的需求。
from surprise import Dataset, Reader
from surprise import SVD
from surprise.model_selection import train_test_split

# 准备评分数据
reader = Reader(rating_scale=(0, 5))
data = Dataset.load_from_df(df[['user_id', 'book_id', 'rating']], reader)

# 划分训练集和测试集
trainset, testset = train_test_split(data, test_size=0.2)

# 训练模型
model = SVD()
model.fit(trainset)
通过使用一些指标(如均方根误差、平均绝对误差等)来验证模型的效果。评估结果可以帮助我们了解模型的准确性,并根据反馈进行优化。在模型评估过程中,可以使用测试集进行模型预测,评估模型在未见数据上的表现,以确保模型的泛化能力。
from surprise import accuracy

# 进行预测
predictions = model.test(testset)

# 计算RMSE
rmse = accuracy.rmse(predictions)
print(f'RMSE: {rmse}')
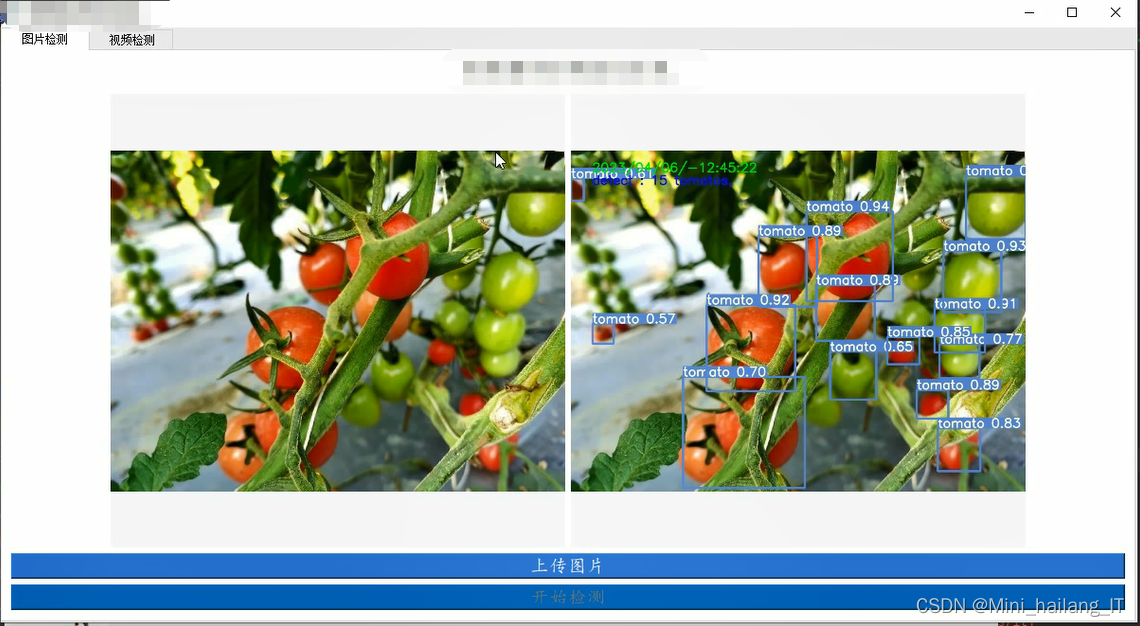
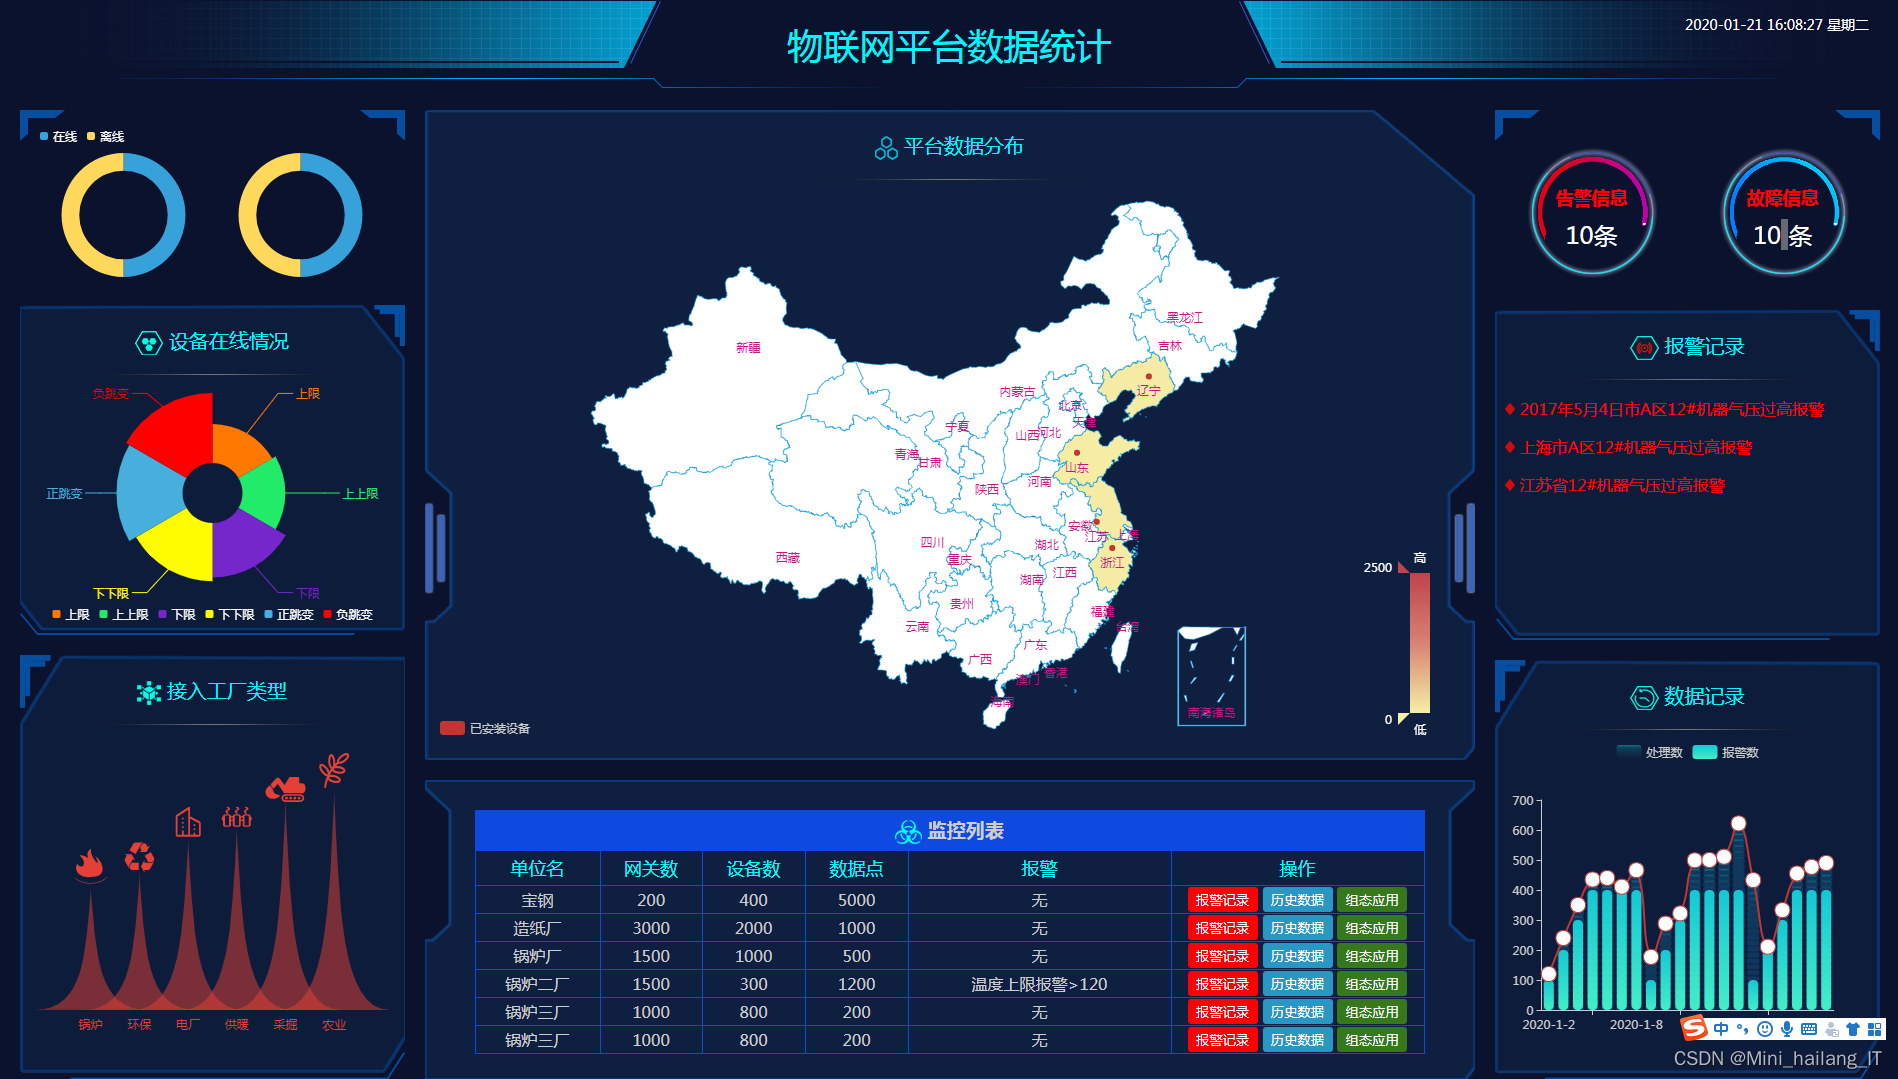
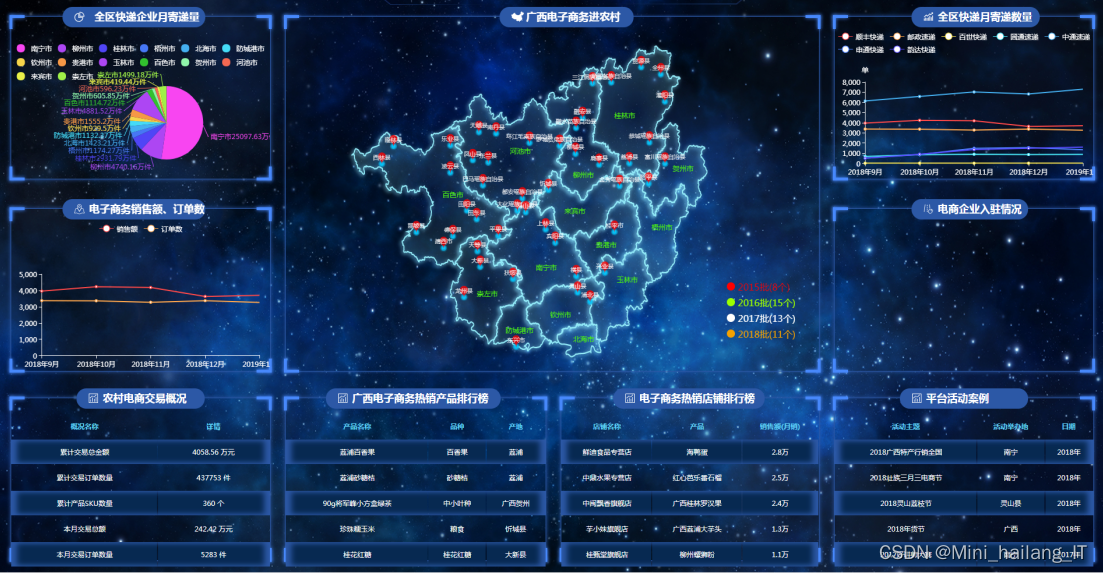
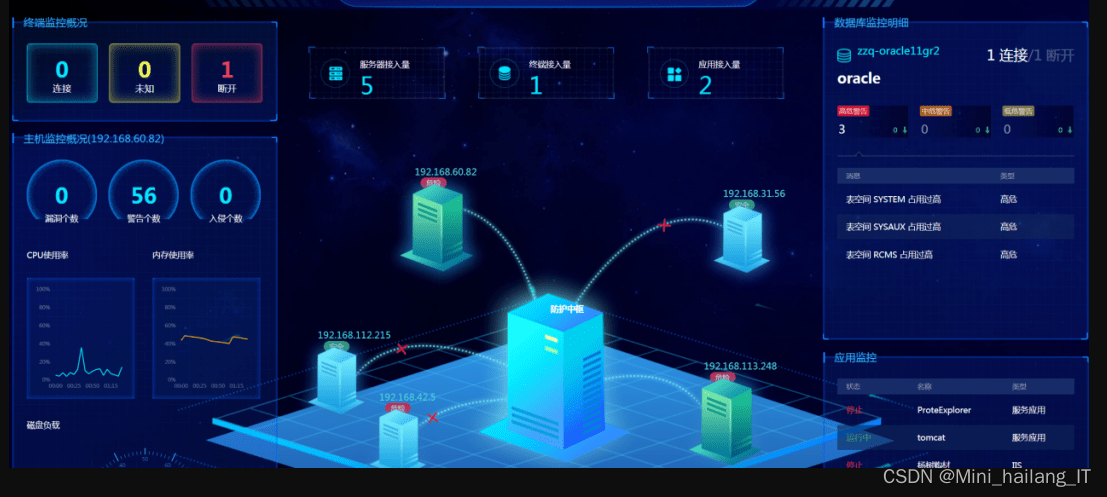
海浪学长项目示例:


 211


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


