


目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
大家好,这里是海浪学长计算机毕设专题,本次分享的课题是
🎯基于计算机视觉的道路裂缝识别与分析
项目背景
道路裂缝是影响交通安全和道路使用寿命的重要因素,及时检测和修复裂缝能够有效降低维护成本和事故风险。传统的道路裂缝检测方法通常依赖人工巡查,效率低且容易漏检。随着计算机视觉和深度学习技术的发展,基于图像处理的自动化道路裂缝检测系统应运而生。这种技术不仅提高了检测的准确性和效率,还为道路维护提供了数据支持,促进了智能交通系统的发展。
数据集
道路裂缝数据集可以选择自主拍摄或从互联网获取数据。自主拍摄可以通过使用高分辨率相机或无人机在不同的道路和环境条件下拍摄裂缝图像,以确保数据的多样性和代表性;此外,互联网采集则可以利用开放的数据集、社交媒体或在线图像库,获取已标注的道路裂缝图像,丰富数据来源,提升数据集的规模。通过使用标注工具LabelImg),研究人员可以为每个图像中的裂缝区域绘制边界框,并为其分配相应的类别标签。标注时需确保准确性与一致性,以提高后续模型训练的效果。

在数据集划分与扩展阶段,将收集到的图像数据分为训练集、验证集和测试集,通常采用70%-80%用于训练,20%-30%用于验证和测试。此外,通过数据扩展技术(如旋转、翻转、缩放等),可以增加训练样本的多样性,从而提升模型的泛化能力。
设计思路
卷积神经网络(CNN)是一种处理类似网格结构数据的神经网络。CNN通过卷积层和池化层等特殊结构,学习数据的局部特征和全局特征,有效提取图像等数据中的高层次特征,具备较好的特征提取和分类能力。卷积神经网络的基本结构包括输入层、卷积层、池化层、激活函数和全连接层。

输入层是第一层,负责将输入数据进行预处理并转换成适合后续网络结构的形式。输入层需根据卷积神经网络的计算模型调整数据,包括大小调整、裁剪、归一化、数据增强等,以确保输入信息的数组维度与卷积神经网络计算维度匹配。经过预处理后,网络能够更好地提取有效特征信息,提高模型性能。常见的数据预处理方法包括归一化处理、平均值处理和主要成分分析。
卷积层通过卷积运算对输入数据进行特征提取,每个神经元对输入数据的局部区域进行卷积操作,局部区域称为感受野,感受野的大小由卷积核和步长决定。通过多个卷积核并设置不同参数,卷积层可以提取多个特征图。池化层的主要目的是对局部区域的特征进行聚合,检测特征的存在而不关注具体位置。

池化操作的意义在于特征不变性和特征降维。特征不变性保持图像数据的不变性,经过缩小、放大、平移、旋转等处理后,池化操作去除非核心数据信息,保留主要特征。特征降维通过聚合局部区域的特征并减小特征图的尺寸降低数据维度,去除冗余数据,提高计算效率和泛化能力。激活函数在神经网络中发挥重要作用,必须是非线性且可导的函数,以引入非线性运算,支持反向传播。

全连接层也称为输出层,常用于神经网络最后几层,将前面层的特征组合和映射,生成最终输出结果。在分类任务中,全连接层将特征表示映射到类别概率或类别标签;在回归任务中,将特征映射到目标变量的预测值。
YOLOv5是一种先进的目标检测算法,具有高效性和实时处理能力,其整体结构由多个重要组件构成。首先,输入层负责接收原始图像并将其调整为统一的尺寸,以适应后续的处理需求。紧接着,骨干网络采用CSPNet结构,专注于提取图像中的特征,能够有效捕捉到不同层次的视觉信息。接下来,颈部网络通过特征融合和增强,提升了对不同尺度目标的检测能力,确保模型能够精准识别小型和复杂目标。头部网络则负责最终的输出,生成每个目标的边界框和类别概率,确保检测结果的准确性。在激活函数方面,YOLOv5使用Leaky ReLU和Sigmoid,以引入非线性并保证类别概率的有效性。此外,模型结合了自定义的损失函数,通过优化定位、分类和置信度损失,进一步提升检测性能。为了增强模型的鲁棒性和泛化能力,YOLOv5还集成了多种数据增强技术,如随机裁剪、颜色变换和旋转等。

收集大量的道路裂缝图像数据图像可以来自于实际的道路监控视频、无人机拍摄或人工拍摄的图片。收集的数据应涵盖不同类型和形状的裂缝,以提高模型的泛化能力。收集到的图像需要进行标注,通常使用标注工具(如LabelImg或VIA)为每个裂缝绘制边界框,并为其分配类别标签(如“裂缝”)。标注后的数据集通常以XML或JSON格式保存。对收集到的图像进行预处理。这包括图像的缩放、归一化、数据增强等。图像通常会被调整为固定尺寸(如640x640像素),以满足模型的输入要求。同时,为了提高模型的鲁棒性,可以应用数据增强技术,如旋转、翻转、亮度调整等,这样可以增加训练样本的多样性,防止过拟合。
import cv2
import numpy as np

def preprocess_image(image):
    # 调整图像大小
    image_resized = cv2.resize(image, (640, 640))
    # 归一化到[0, 1]
    image_normalized = image_resized / 255.0
    return image_normalized
选择目标检测模型YOLOv5对模型进行配置,包括设置学习率、批次大小、优化器等超参数。对于YOLOv5,可以使用其提供的配置文件进行简单的参数调整。完成数据预处理和配置后,开始对模型进行训练。训练过程中,模型通过输入训练集图像,计算损失函数,并根据损失值更新模型参数。通常会记录训练过程中的损失值和验证集的准确率,以监测模型性能。
# 示例:YOLOv5的配置文件
# 修改学习率、批次大小等参数
hyp:
  lr0: 0.01  # 初始学习率
  lrf: 0.1   # 学习率衰减
  momentum: 0.937  # 动量
  ...
模型评估使用验证集计算模型的精度、召回率和F1分数等指标。此外,可以通过调整超参数、增加数据集或使用不同的数据增强技术,进一步优化模型性能。经过训练和优化,最终将模型部署到实际应用中。可以将模型导出为ONNX格式、TensorRT等,以便在边缘设备或云服务中进行实时道路裂缝检测。
# 示例:评估模型性能
from sklearn.metrics import classification_report

# 预测验证集
predictions = model.predict(images_val)
# 计算并打印分类报告
print(classification_report(labels_val, predictions))
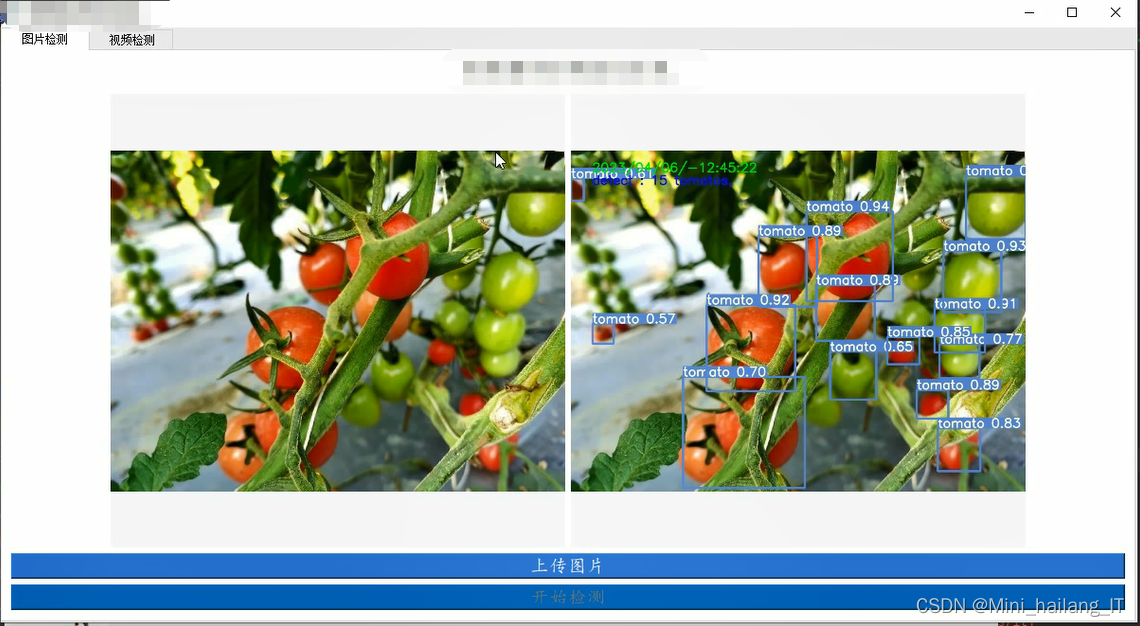
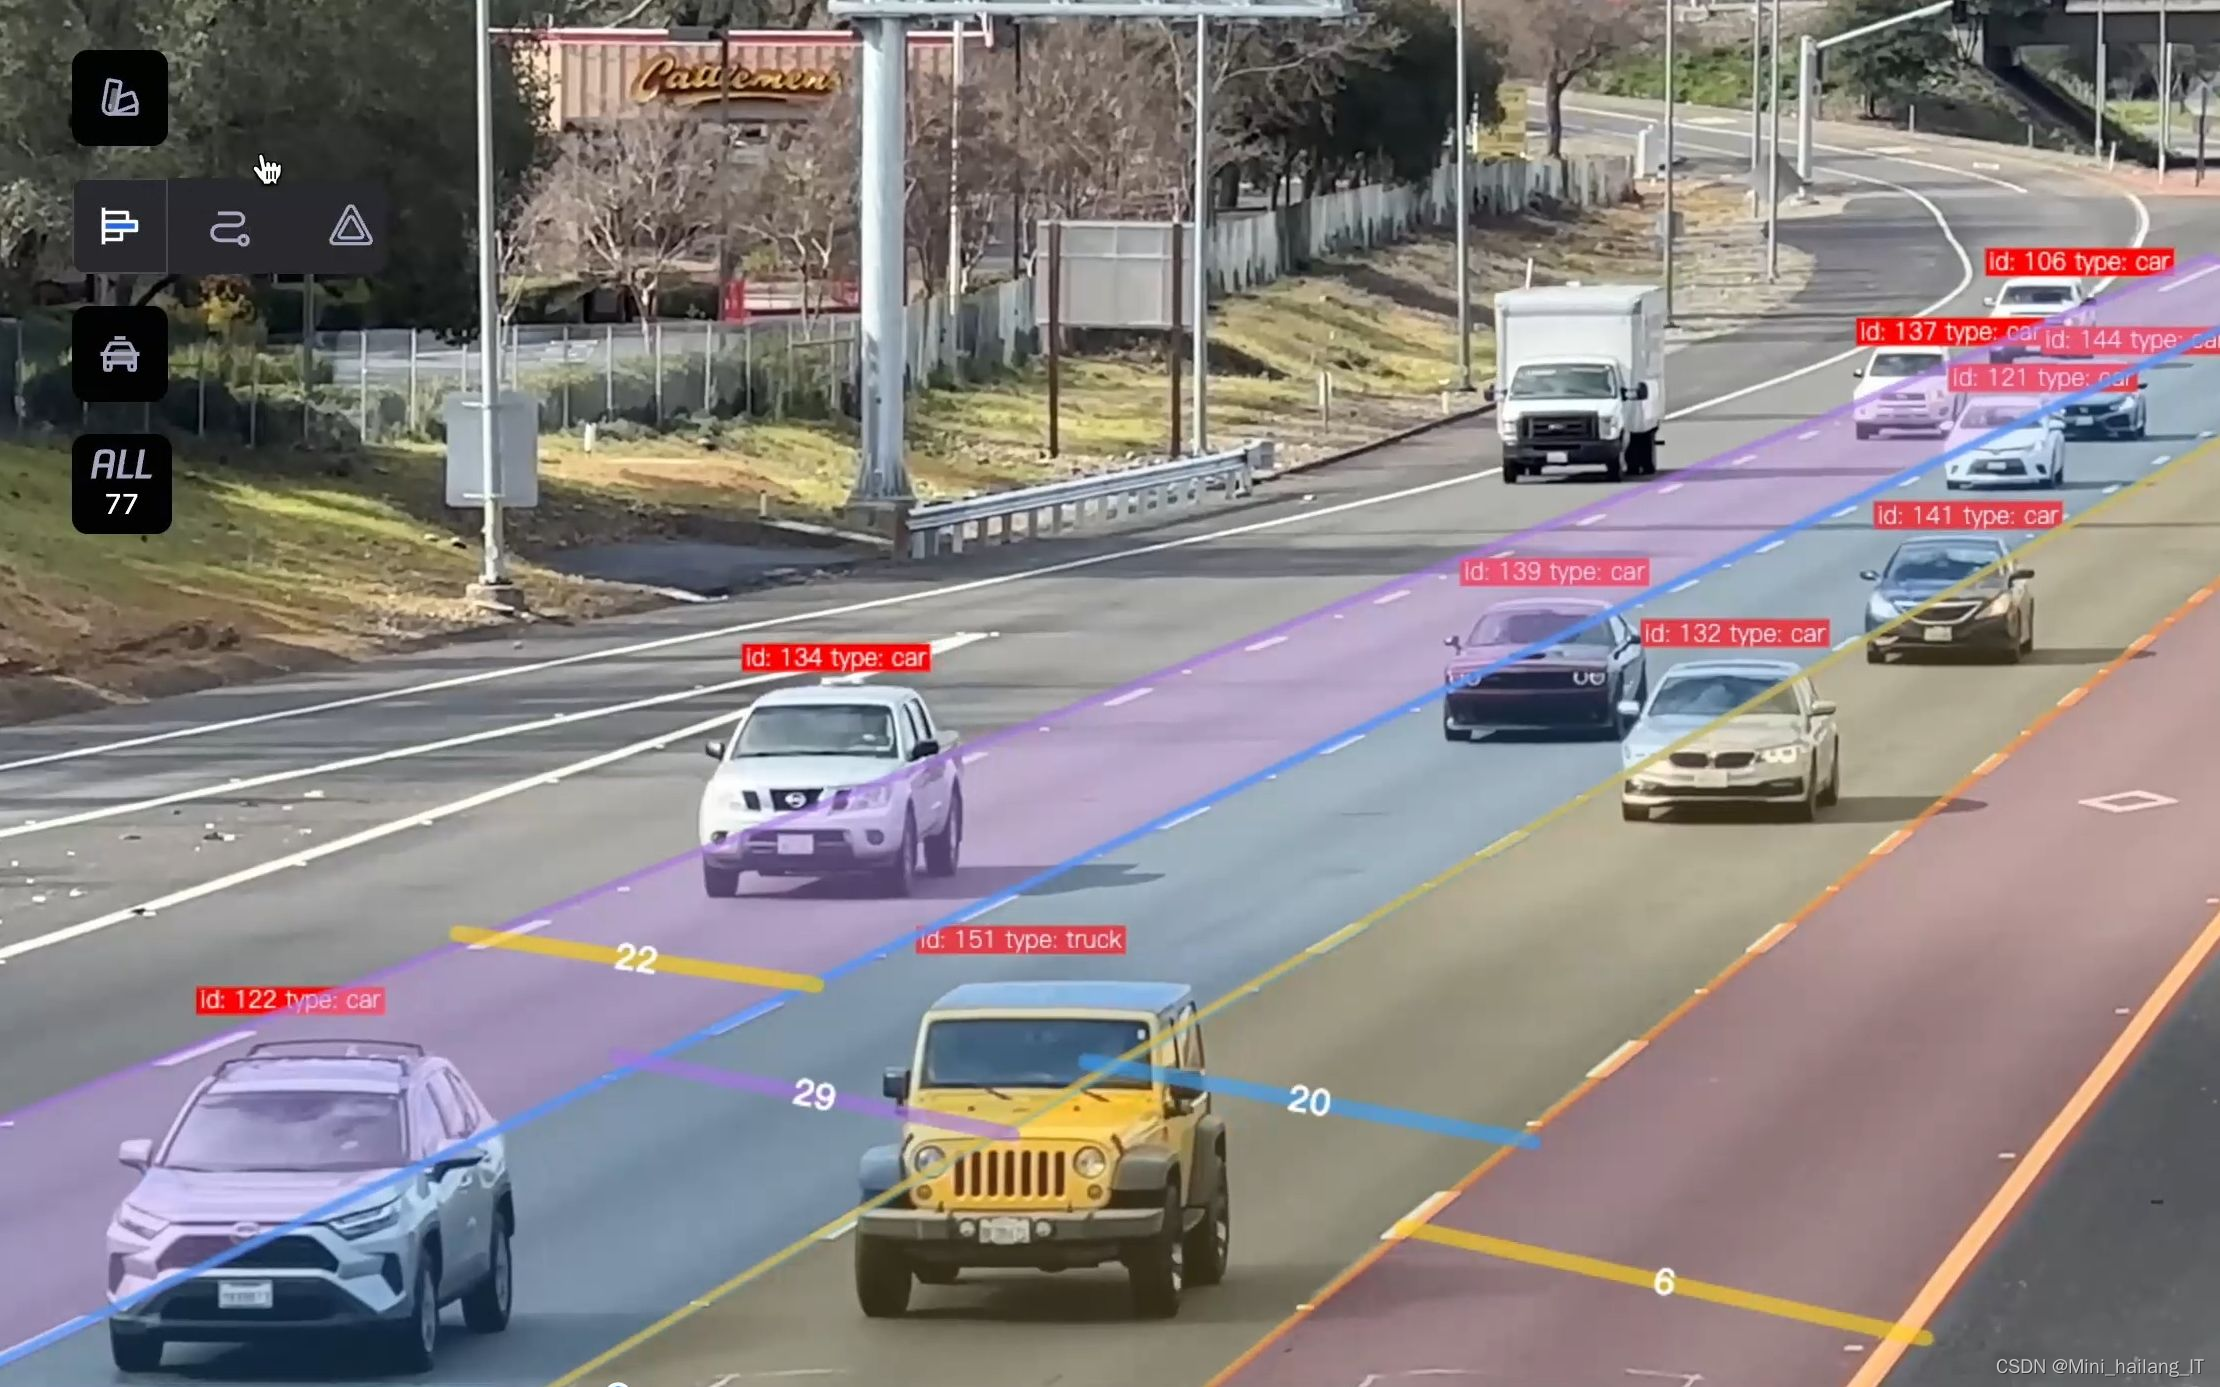
海浪学长项目示例:


 351


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


