




目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
大家好,这里是海浪学长计算机毕设专题,本次分享的课题是
🎯基于YOLO的运动健身动作检测与识别方法研究
项目背景
随着人们对健康和健身的重视,运动健身行业迅速发展,相关的智能监测和指导技术也逐渐受到关注。运动健身动作的准确识别不仅对个人训练效果的提升至关重要,还能帮助教练进行更有效的指导。传统的动作检测方法往往依赖于人工监测,存在效率低、主观性强的问题。YOLO作为一种高效的目标检测算法,能够实现对健身动作的实时监测与识别。通过结合计算机视觉与深度学习技术,可以为运动健身提供智能化的解决方案,提升健身效果和安全性。
数据集
图像采集选择自主拍摄或从互联网获取数据。自主拍摄能够更好地控制拍摄条件,例如光照、角度和背景,从而获取高质量的样本。拍摄时,应涵盖多种运动动作、不同的姿势和多样化的场景,以确保数据集的多样性和代表性。另外,互联网采集可以利用现有的公开数据集或视频平台上的运动视频,快速收集到大量样本,但需要注意版权和数据的质量。

数据标注是数据集制作中的关键环节,通常使用专业的标注工具,如LabelImg或Labelbox,对采集到的图像进行标注。标注的内容包括运动动作的类别、关键点、边界框等信息。准确的标注可以显著提高后续模型训练的效果,因此在标注过程中需要仔细检查,确保每个样本的标注信息准确无误。此外,可以考虑邀请运动专业人士进行复核,以提高标注的可靠性。

将数据集划分为训练集、验证集和测试集,常见的比例为70%用于训练、15%用于验证、15%用于测试。这样的划分可以确保模型的泛化能力,避免过拟合。同时,为了进一步增强数据集的多样性,可以使用数据扩展技术,如旋转、翻转、缩放、添加噪声等方法,生成更多样本。
设计思路
卷积神经网络 (CNN) 作为深度学习模型的基础,在图像识别、自然语言处理等方面有广泛应用,其基本结构由卷积层、池化层、全连接层以及激活函数组成。

卷积层是卷积神经网络中的基础组件,在图像识别应用中,主要功能是提取输入图像数据的相关特征,图像数据以三维像素矩阵的形式呈现,分别表示为矩阵的长度、宽度以及深度,长度与宽度代表尺寸大小,深度代表色彩通道数。例如,对于 RGB 彩色图像,矩阵深度为 3,黑白图像的矩阵深度为 1。卷积层基于卷积核矩阵对输入的图像矩阵进行卷积运算,产生一系列卷积特征矩阵,这些矩阵可以捕捉到输入图像中的不同层次特征。但仅依赖一个卷积层的特征提取能力是不够的,通常可以堆叠多个卷积层来构建复杂的特征提取器,从而提高网络模型的表现能力。

池化层可以有效防止模型出现过拟合问题,增强模型的鲁棒性和泛化能力。池化层通过将图像特征中的高频与低频进行分离,使图像特征表示更为简洁。池化层基于滑动窗口划分区域,对图像中的每个区域进行降采样,这不仅可以缩小图像数据尺寸,还可以减少计算量、参数量以及相关信息的损失。此外,池化层还可通过改变填充和调整步幅的方式来改变滑动窗口的移动方式。池化层常用的两种表达方式为最大池化和平均池化,两者均可以对图像特征进行降采样,从而减少参数数量和模型计算。

全连接层常应用于不同卷积神经网络模型,将原先通过卷积和池化处理后的数据与上一层数据进行全连接,输出相应的预测结果值或概率分布,以一维向量表示。全连接层所处的具体位置在模型最后一层或倒数第二层,在网络模型中全连接层的权重和偏置值参数可以学习,通过网络模型训练得出。
激活函数在深度学习模型中逐步拟合数据并输出期待值,通常位于模型的隐藏层或输出层。在卷积神经网络中,激活函数分为线性或非线性函数两种。引入线性激活函数,常被称为单位函数,对应的输出是输入的线性组合,主要用于减少网络模型的参数量和加深网络模型的深度,但其学习能力是有限的。引入非线性激活函数,可以增强模型的非线性表达,提高模型的拟合能力,模型学习能力会随着隐藏层个数增加而有所突破。

YOLOv5是一种基于深度学习的实时物体检测模型,属于YOLO系列的最新版本。该模型通过将目标检测任务转化为回归问题,在单个神经网络中同时预测边界框和类别概率。YOLOv5在速度和精度上表现出色,适用于各种应用场景,如视频监控、无人驾驶、智能安防等。与之前版本相比,YOLOv5引入了一些新的设计元素和优化策略,包括更高效的模型结构、数据增强技术以及改进的损失函数,使得模型在保持高帧率的同时,能有效提高检测精度。

YOLOv5的网络架构主要由三个部分组成:骨干网络、颈部网络和头部网络。骨干网络负责提取图像特征,通常采用CSPNet结构,以提高模型的表现和计算效率。颈部网络通过自适应特征拼接(PANet)增强不同尺度特征之间的信息流,从而提高小物体的检测能力。头部网络则负责输出最终的检测结果,包括边界框的坐标和对应的类别概率。此外,YOLOv5支持多种模型尺寸(如s、m、l、x),用户可以根据具体需求选择合适的模型,以实现最佳的性能与效率平衡。

收集包含不同运动健身动作的视频或图像数据。这些数据可以从公开数据集获取,也可以通过自定义录制运动视频来创建。数据集应包含多种动作、不同的角度和不同的环境,以增强模型的泛化能力。数据集需要标注,通常使用Bounding Box或关键点标注来定义每个动作的位置和类别。数据预处理包括图像缩放、归一化、数据增强等步骤。图像缩放是将所有图像调整到统一尺寸,归一化是将像素值缩放到[0, 1]范围内,以提高模型训练的稳定性。数据增强可以通过随机旋转、翻转、裁剪等方式生成更多样本,从而提高模型的鲁棒性。
# 示例代码:数据增强
from torchvision import transforms

# 定义数据增强的转换
transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
])

# 应用转换
from PIL import Image

image = Image.open('exercise_image.jpg')
augmented_image = transform(image)
选择合适的模型架构对于运动健身动作检测与识别至关重要。常用的模型包括卷积神经网络(CNN)、基于YOLO的目标检测模型。根据具体任务选择合适的框架(如PyTorch或TensorFlow),然后构建模型。使用准备好的数据集对模型进行训练。需要定义损失函数和优化器,通常使用交叉熵损失和Adam优化器。通过多次迭代,不断调整模型参数,以最小化损失函数。
# 示例代码:使用PyTorch构建简单CNN模型
import torch
import torch.nn as nn

class SimpleCNN(nn.Module):
    def __init__(self):
        super(SimpleCNN, self).__init__()
        self.conv1 = nn.Conv2d(3, 16, kernel_size=3, stride=1, padding=1)
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
        self.fc1 = nn.Linear(16 * 112 * 112, 256)
        self.fc2 = nn.Linear(256, 10)  # 假设有10个动作类别

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))
        x = x.view(-1, 16 * 112 * 112)
        x = F.relu(self.fc1(x))
        x = self.fc2(x)
        return x

model = SimpleCNN()
通过在验证集或测试集上评估模型的性能,通常使用准确率、召回率和F1-score等指标。可以使用混淆矩阵可视化模型的分类效果,从而了解模型在哪些动作上表现较好或较差。将训练好的模型应用于实际场景中。可以将模型导出为ONNX格式,或者使用Flask等框架构建API,以便在移动设备或Web应用中进行实时运动检测与识别。
# 示例代码:模型评估
from sklearn.metrics import classification_report, confusion_matrix

# 预测
y_pred = model(test_loader)
# 假设y_true为真实标签
print(classification_report(y_true, y_pred))
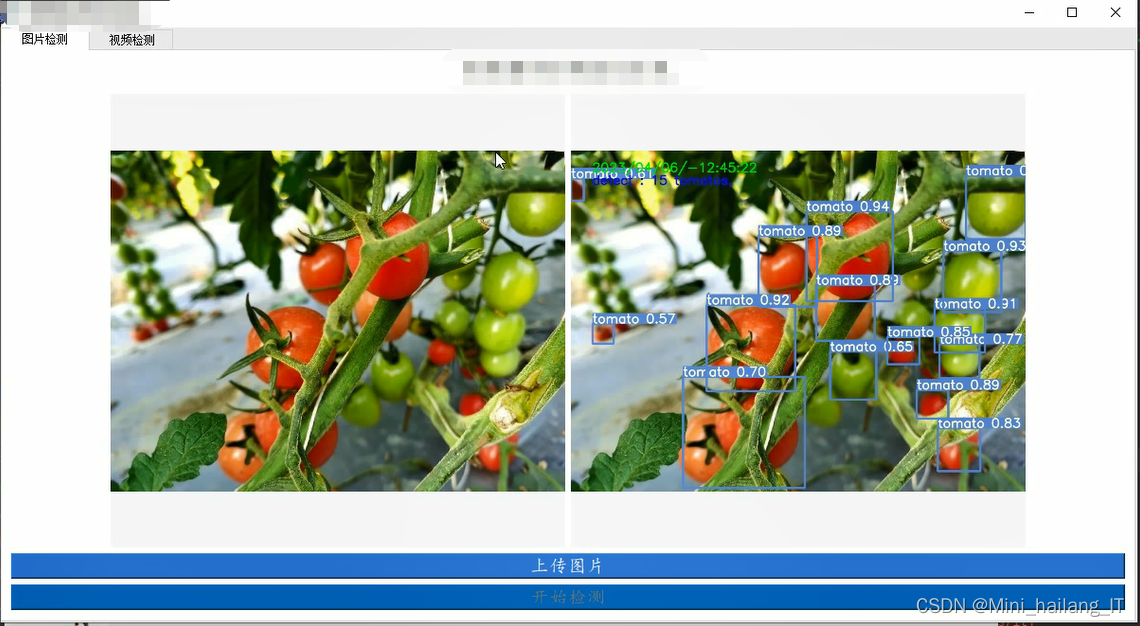
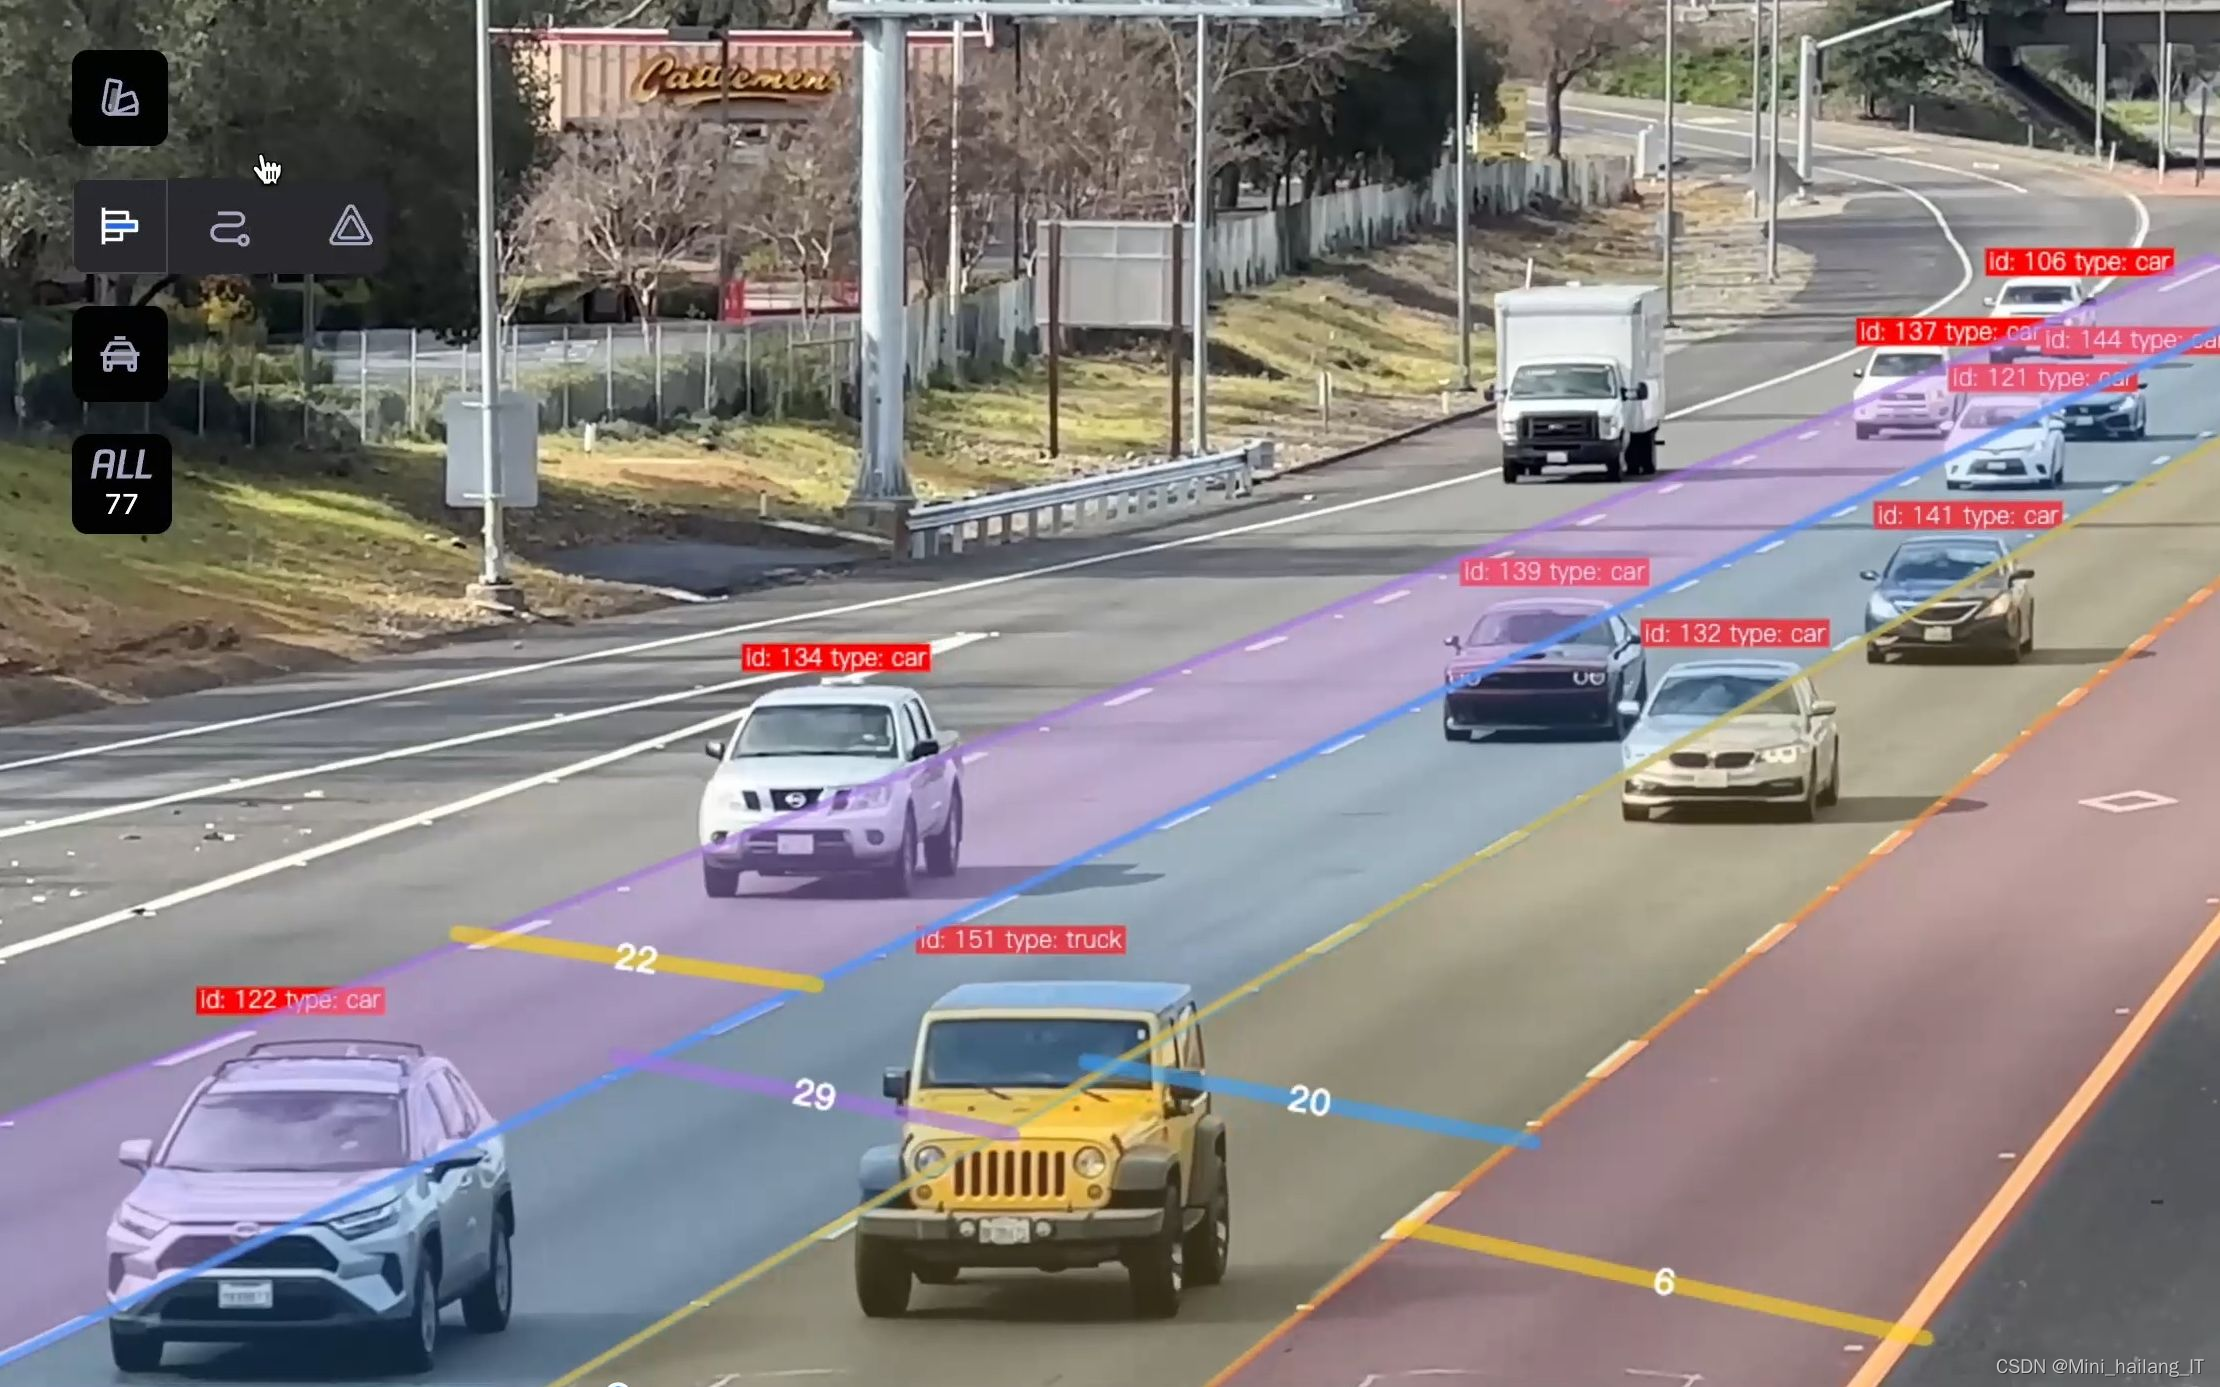
海浪学长项目示例:

 327


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


