


目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
大家好,这里是海浪学长计算机毕设专题,本次分享的课题是
🎯基于深度学习的猫咪行为检测算法研究
项目背景
随着宠物经济的快速发展,越来越多的人开始养猫,猫咪的健康与行为管理成为宠物主人和兽医关注的重点。传统的猫咪行为监测方法往往依赖人工观察,效率低下且容易受到主观因素的影响。深度学习技术的迅猛发展为动物行为识别提供了新的解决方案,通过计算机视觉与机器学习算法,可以实现对猫咪行为的自动检测与分析。这不仅可以帮助宠物主人实时了解猫咪的行为状态,还可以为兽医提供数据支持,辅助诊断潜在的健康问题。研究基于深度学习的猫咪行为检测算法,不仅具有重要的实际应用价值,同时也对计算机视觉和深度学习领域的研究提供了新的思路和方向。
数据集
图像采集
-
自主拍摄:使用高分辨率相机或智能手机进行猫咪行为的拍摄。选择不同的环境(如室内、户外)和时间(如白天、夜晚)进行拍摄,以捕捉猫咪在不同情境下的行为表现。应尽量记录多种行为(如吃饭、玩耍、睡觉、抓挠等),并从多个角度和距离进行拍摄,以确保数据的多样性和代表性。
-
互联网采集:通过视频分享平台(如YouTube)或开放图像数据集(如Kaggle)收集猫咪行为的相关图像和视频。进行关键词搜索(如“cat behavior”、“cat playing”等),确保所选图像和视频的相关性和清晰度。在使用互联网资源时,要遵循版权法规,避免侵犯他人权利。
数据标注
-
使用标注工具(如LabelImg、VGG Image Annotator等)对收集的图像和视频进行标注。根据目标行为,选择适合的标注方式(如框选、关键点标注等)。可以为每个行为分配不同的标签(如“吃饭”、“玩耍”、“睡觉”),并确保标注的一致性。
-
在标注过程中,确保标注的准确性和完整性。可以考虑多位标注人员进行交叉验证,以提高标注质量。
数据集划分
-
将标注好的数据集进行划分,通常采用训练集(70%)、验证集(15%)和测试集(15%)的比例。这种划分有助于评估模型的性能,确保训练和测试数据的独立性。
-
训练集用于模型的训练,验证集用于调整模型参数,测试集用于评估模型的最终性能。
设计思路
基础理论
卷积神经网络(CNN)是一种深度学习模型,专门用于处理具有网格结构的数据,如图像。CNN通过卷积层提取特征,这些卷积层使用小的滤波器在输入图像上滑动,以捕捉局部特征。与传统的全连接神经网络相比,CNN在参数共享和局部连接方面具有显著优势,能够显著减少模型的复杂性和计算成本。CNN通常由多个卷积层、池化层和全连接层组成,其中池化层用于降低特征图的维度,从而提高计算效率并增强模型的鲁棒性。通过层层提取和组合特征,CNN能够有效识别图像中的模式,广泛应用于图像分类、目标检测和行为识别等领域。

3D卷积计算是在2D卷积的基础上扩展出一个额外的维度,通常用于处理具有时间序列特征的数据,如视频。与2D卷积只在空间维度(高度和宽度)上进行卷积操作不同,3D卷积在空间维度的基础上增加了时间维度,这样每个卷积核不仅可以提取图像的空间特征,还能捕捉随时间变化的动态特征。在视频数据中,时间维度表示为连续帧之间的变化,3D卷积通过在空间和时间两个维度上滑动卷积核,能够有效学习到视频中物体运动、行为变化等时间动态特征。这种方法在动作识别、视频分类和视频生成等任务中展现了强大的性能,因为它能够同时考虑到图像的空间信息和时间信息,从而更全面地理解视频内容。通过使用3D卷积,深度学习模型能够更准确地捕捉到视频中的复杂动态模式,提高了对视频数据的分析能力。

注意力机制是一种模仿人类视觉聚焦的计算方法,旨在提高模型对重要信息的关注度。在处理序列数据或图像时,模型可能会面临信息过载的情况,注意力机制通过为输入的不同部分分配不同的权重来解决这一问题,使模型能够集中在最相关的信息上。具体而言,注意力机制通过计算输入特征的加权和来生成上下文表示,从而有效提高模型在特定任务上的性能。该机制在自然语言处理和计算机视觉等领域表现出色,使得模型能够在复杂场景中更好地理解和解析信息。

多头注意力机制是注意力机制的一种扩展,它通过并行计算多个注意力头来进一步增强模型的信息处理能力。在多头注意力中,输入特征被线性变换为多个不同的子空间,使得每个注意力头能够捕捉到输入数据中的不同特征和关系。通过将这些头的输出进行拼接或加权平均,多头注意力机制可以有效整合来自不同视角的信息,从而提供更丰富的上下文表示。这种方法在Transformer模型中得到了广泛应用,极大地提升了模型在任务如机器翻译和图像标注等方面的表现,尤其在处理复杂的长序列和高维数据时,展现出显著的优势。

模型训练
构建一个丰富多样的猫咪行为数据集,这包括捕捉猫咪在不同环境和背景下的行为,例如吃东西、玩耍、打盹、清洁等。数据来源可以是自己拍摄的视频,也可以是从社交媒体、视频平台或公开数据集获取的。为了确保数据集的多样性,建议收集不同品种、不同年龄和不同性格的猫咪行为样本。此外,数据的标注工作也非常重要,研究者需要使用标注工具对视频或图像中的各种行为进行准确的标记,这为后续模型的训练提供了可靠的基础。
# 示例代码:使用OpenCV读取视频帧
import cv2

video_path = 'path/to/your/video.mp4'
cap = cv2.VideoCapture(video_path)

while cap.isOpened():
    ret, frame = cap.read()
    if not ret:
        break
    # 显示视频帧
    cv2.imshow('Frame', frame)
    if cv2.waitKey(1) & 0xFF == ord('q'):
        break

cap.release()
cv2.destroyAllWindows()
预处理包括图像的缩放、归一化、增强等操作。首先,需要将图像和视频帧调整为统一的尺寸,以便输入到模型中。通常选择的尺寸为640x640像素。其次,为了提高模型的鲁棒性,应用数据增强技术,如随机旋转、翻转及颜色变换等,可以有效扩充训练集,降低过拟合风险。此外,将数据进行归一化处理,使其值域在0到1之间,有助于加速模型的收敛速度。经过预处理的数据能够更好地匹配模型输入的要求,提高模型训练的效果。
import cv2
import numpy as np

def preprocess_image(image):
    # 调整图像大小
    image = cv2.resize(image, (640, 640))
    # 归一化
    image = image.astype(np.float32) / 255.0
    return image
卷积神经网络(CNN)通常是处理图像数据的首选模型。YOLOv5是一个高效的目标检测算法,特别适合实时图像和视频处理。YOLOv5通过将图像划分为网格,并预测每个网格中的目标类别和边界框,能够快速且准确地检测多个目标。为了进一步提升模型的性能,可以结合多头注意力机制,它通过并行计算多个注意力头来增强模型的信息处理能力,使得模型可以更好地捕捉图像中的重要特征。选择合适的模型和网络架构是成功的关键。
import torch

# 加载YOLOv5模型
model = torch.hub.load('ultralytics/yolov5', 'yolov5s', pretrained=True)
将预处理后的数据输入到模型中进行训练。使用适当的损失函数(如交叉熵损失)和优化器(如Adam或SGD)来更新模型的参数是至关重要的。在训练过程中,研究者需要监控模型的损失值和准确率,以评估模型的学习进展。通常,训练会进行多个周期(epoch),在每个周期结束时可以在验证集上进行评估,以确保模型没有过拟合。合理的超参数选择(如学习率、批大小等)可以显著提升训练效果。
# 假设我们已定义好数据加载器
from torch.utils.data import DataLoader

# 训练模型
for epoch in range(num_epochs):
    for images, labels in train_loader:
        outputs = model(images)
        loss = compute_loss(outputs, labels)  # 自定义损失函数

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
根据模型评估的结果,进行模型优化是提升性能的重要步骤。这可能包括调整超参数(如学习率、批大小)以获得更好的训练效果,或者采用更复杂的模型架构,如引入更深的网络层次或融合多头注意力机制来提升特征提取能力。此外,数据增强策略的调整也能显著改善模型的泛化能力。通过不断迭代优化,研究者可以提升模型在实际应用中的表现,使其能够更准确地检测猫咪行为。经过训练和优化的模型需要进行部署,以便在实际应用中使用。部署可以通过构建API来实现,这样用户可以上传视频或图像,并获取猫咪行为的实时检测结果。Flask或FastAPI等框架是常用的Web框架,可以快速构建模型服务。
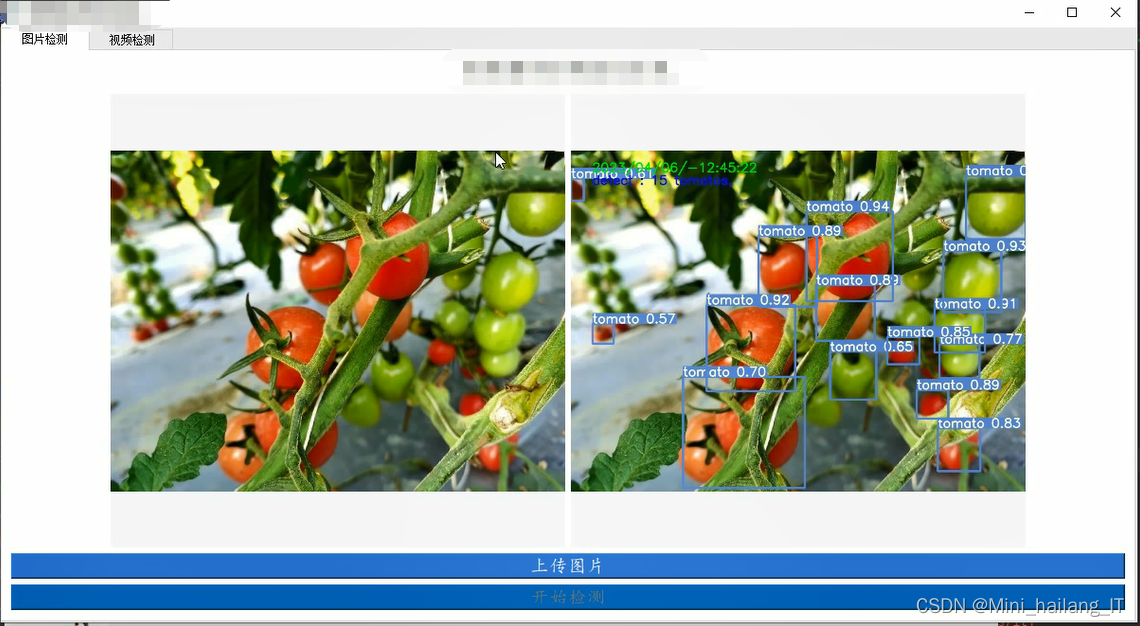
海浪学长项目示例:


 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


