毕业设计:基于深度学习的微博谣言检测系统 人工智能

基于LSTMGRU的微博突发事件分析与谣言检测(附完整的代码+报告) 基于LSTMGRU的微博突发事件分析与谣言检测(附完整的代码+报告+毕业设计) 阅读详情

目录

前言

设计思路

一、课题背景与意义

二、算法理论原理

三、检测的实现

最后


前言

       📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。

        🚀对毕设有任何疑问都可以问学长哦!

         选题指导:

        最新最全计算机专业毕设选题精选推荐汇总

        大家好,这里是海浪学长毕设专题,本次分享的课题是

        🎯基于深度学习的微博谣言检测系统

设计思路

一、课题背景与意义

       微博谣言早期检测系统的背景和意义源于社交媒体平台上谣言的广泛传播和对社会的潜在危害。随着社交媒体的普及和信息传播的快速性,谣言可以在短时间内迅速扩散,对公众产生负面影响,包括误导和恐慌等。因此,建立谣言早期检测系统具有重要意义。

二、算法理论原理

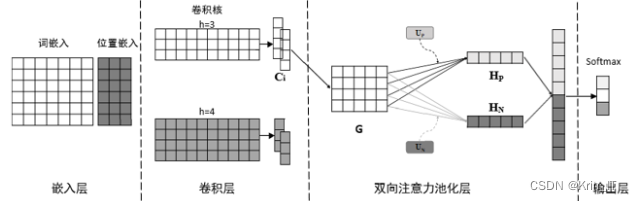
       DSA-CNN是一种基于卷积神经网络的模型,结合了双向情感词注意力机制,共分为四层结构:嵌入层、卷积层、注意力池化层和输出层。

  • 嵌入层:将句子转换为词向量矩阵和位置向量矩阵。这一层的目的是将文本表示为向量形式,以便后续的卷积操作。
  • 卷积层:通过不同尺寸的卷积核提取局部特征,生成特征图。卷积层能够捕捉文本中的局部信息,对不同大小的特征进行提取。
  • 注意力池化层:将注意力机制用于对CNN模型池化层的改进,并基于训练得到的双向情感词向量,采用注意力机制获得卷积特征图中重要的正向和负向情感特征。通过注意力机制,模型可以关注句子中与情感相关的重要信息。
  • 输出层:使用Softmax函数获得分类结果。将经过注意力池化层处理后的特征进行拼接,然后经过Softmax函数进行分类概率的计算,得到最终的分类结果。

相关代码示例:

model = DSA_CNN_Model()

# 定义损失函数和优化器
criterion = CrossEntropyLoss()
optimizer = Adam(model.parameters(), lr=0.001)

# 训练模型
for epoch in range(num_epochs):
    # 前向传播
    output = model.forward(input_data)
    
    # 计算损失
    loss = criterion(output, target_labels)
    
    # 反向传播和优化
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

    # 输出训练信息
    if (epoch+1) % 10 == 0:
        print('Epoch [{}/{}], Loss: {:.4f}'.format(epoch+1, num_epochs, loss.item()))

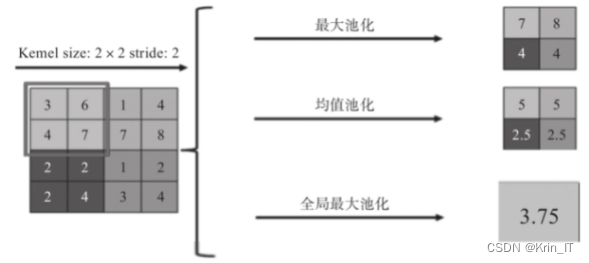
       在文本分类中,传统的CNN池化层常用的方法是最大池化和平均池化。然而,最大池化方法只关注最显著的影响因素,忽略了其他因素的影响,而平均池化方法对所有信息进行同等处理,无法区分不同情感特征词的重要性。这些池化方法都有可能丢失上下文中的信息,对语义特征的提取产生影响。
       为了更有效地提取文本特征,注意力机制被引入到CNN池化层的改进中。注意力机制可以计算一组特征中的不同重要程度,并根据查询向量给予更大的权重。将注意力机制应用于CNN池化层改进中,可以对不同影响的特征进行有效区分。相比于最大池化,基于注意力的池化方法包含了更多文本信息。
相关代码示例:

import torch
import torch.nn as nn

class AttentionPooling(nn.Module):
    def __init__(self, input_size, query_size):
        super(AttentionPooling, self).__init__()
        self.linear = nn.Linear(input_size, query_size)
        self.softmax = nn.Softmax(dim=1)

    def forward(self, features):
        # features: 输入的特征图,形状为(batch_size, num_features, feature_size)

        # 计算查询向量
        query = self.linear(features)  # (batch_size, num_features, query_size)

        # 计算注意力分数
        attention_scores = self.softmax(query)  # (batch_size, num_features, query_size)

        # 加权池化
        pooled_features = torch.bmm(attention_scores.transpose(1, 2), features)  # (batch_size, query_size, feature_size)

        # 返回注意力池化后的特征
        return pooled_features

       在常见的文本分类模型中,注意力机制的查询向量通常与网络权重向量类似,随机初始化并进行训练。然而,这种方法受到初始化效果的影响,并增加了过拟合的风险。提出了双向情感词向量的概念,通过情感词典的构造和训练得到,综合考虑了积极和消极情感词的总体情感信息,并以词向量的形式表示。将双向情感词向量作为注意力机制的查询向量,可以在向量空间中与情感特征有较高的相似度,从而在短文本中从积极和消极情感两个方向挖掘更多信息,减轻了随机初始化的影响,防止过拟合。
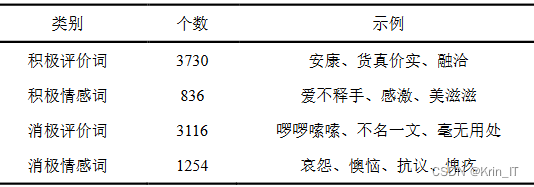
       情感词向量的训练是一个非监督学习过程,需要使用大量包含情感信息的文本语料。为了获取这些语料,可以使用爬虫技术在网络上爬取包含情感的文本。通常,电商平台和社交媒体平台是包含大量情感语料的良好来源,因此可以选择这些平台进行数据爬取。

       获取到的情感语料库需要进行预处理。一种常用的预处理方法是使用分词工具,例如jieba库,对文本进行分词操作。在此过程中,还需要将融合情感词典添加到jieba的自定义词典中,以确保能够准确地划分情感词。对于每一条语料,如果句子中存在情感词典中的积极情感词,则将其替换为"<pos>"标记;同样地,将所有消极情感词替换为"<neg>"标记。

相关代码示例:

import jieba

# 加载自定义词典
jieba.load_userdict('emotion_dict.txt')

# 情感词典
emotion_dict = {
    '积极情感词1': '<pos>',
    '积极情感词2': '<pos>',
    '消极情感词1': '<neg>',
    '消极情感词2': '<neg>'
}

# 定义文本预处理函数
def preprocess_text(text):
    # 分词
    words = jieba.lcut(text)

    # 替换情感词
    for i, word in enumerate(words):
        if word in emotion_dict:
            words[i] = emotion_dict[word]

    # 拼接处理后的文本
    processed_text = ' '.join(words)

    return processed_text

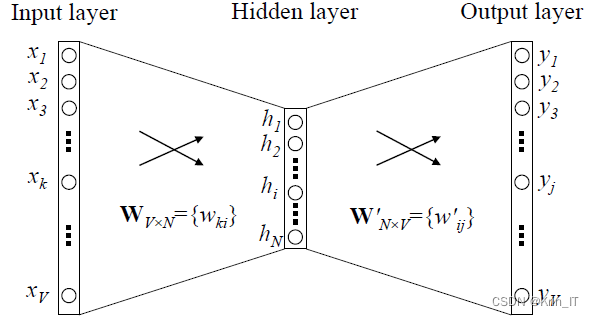
Word2Vec是一种神经网络算法,用于将文本词汇转换为向量表示。它包括CBOW和Skip-gram两种模型,CBOW根据临近词预测中心词,而Skip-gram根据中心词预测临近词。通过训练神经网络,Word2Vec可以生成高维空间中的词向量,将文本信息转化为可计算的向量形式,以便进行后续的文本分析和语义相关性计算等任务。
 

相关代码示例:

from gensim.models import Word2Vec
from gensim.models.word2vec import LineSentence

# 读取语料文件
corpus_file = 'corpus.txt'

# 训练Word2Vec模型
model = Word2Vec(sentences=LineSentence(corpus_file), 
                 sg=1,  # 使用Skip-gram模型
                 size=100,  # 特征向量维度
                 window=5,  # 上下文窗口大小
                 min_count=5,  # 词频阈值,低于该阈值的词将被忽略
                 workers=4)  # 并行训练的线程数

# 保存训练好的模型
model.save('word2vec.model')

# 加载已保存的模型
model = Word2Vec.load('word2vec.model')

# 获取词向量
word_vector = model.wv['word']

# 计算词语之间的相似度
similarity = model.wv.similarity('word1', 'word2')

# 寻找与目标词最相似的词语
similar_words = model.wv.most_similar('target_word', topn=5)

# 获取模型中的所有词汇
vocabulary = model.wv.vocab

三、检测的实现

       谣言数据来源于微博社区管理中心。微博社区管理中心是微博平台专门用于维护平台网络秩序和治理违规行为的官方网站,接受并处理网民的举报,并进行公开审核,受到大众监督。在微博平台上,所有被举报处理的微博谣言都会被公开在微博社区管理中心的不实信息中。谣言数据取自于处于公示阶段的近三年数据,共爬取了其中已发布谣言的原微博4000多条。为了保证所收集的谣言数据有一定的关注度,剔除了其中转发评论过少的数据和重复数据,最终剩下3850条谣言数据。

       评价指标选择了准确率(Accuracy)和宏平均F1值(Macro F1)。准确率和宏平均F1值是根据真阳性(TP)、真阴性(TN)、假阳性(FP)和假阴性(FN)进行计算得出的。简而言之,准确率衡量了模型正确分类的比例,宏平均F1值综合了模型在各个类别上的精确度和召回率。
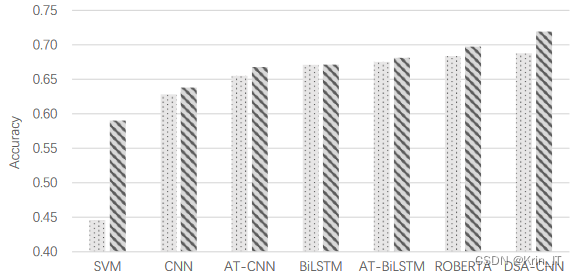
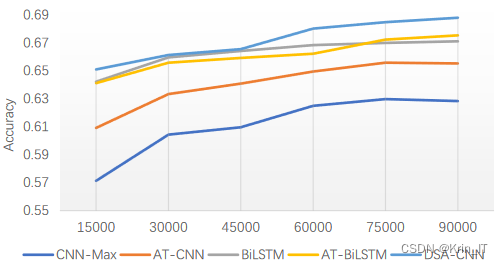
       改进后的模型模型在实验中始终表现最好,无论是在小数据集还是大数据集上都具有良好的学习能力。在小数据集上,DSA-CNN的学习能力与两个LSTM模型基本相当,优于其他CNN模型,这表明通过预训练的情感词向量和注意力机制使得CNN在小数据集上也能提取一定的特征。随着数据集的增大,DSA-CNN模型的准确率也逐步提升,并获得一定的改善,这说明更大的数据量使得网络能够学习到更多的知识。
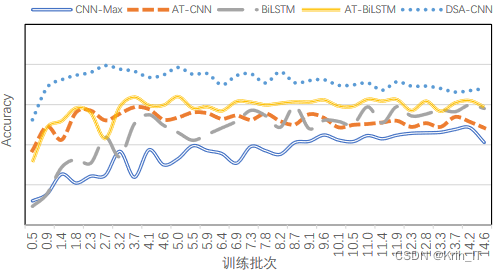
       改进后的模型在池化层采用预训练的情感词向量作为查询向量,减少了随机初始化的影响,使得收敛速度相比AT-CNN进一步提升。在实际操作中可以提前结束神经网络的训练过程。总的来说,训练速度是评价模型质量的重要因素之一,注意力机制和预训练的情感词向量能够显著提高模型的训练速度和收敛性能。 
创作不易,欢迎点赞、关注、收藏。

毕设帮助,疑难解答,欢迎打扰!

最后

GCN+Attention多任务谣言检测系统设计与实现 谣言检测本质上是融合文本语义、用户行为与传播结构的复合型任务,单一文本分类模型难以捕捉谣言的动态传播路径与多维判别需求。基于图卷积神经网络(GCN)可建模用户间转发关系形成的拓扑结构,而注意力机制则能自适应聚焦关键节点与矛盾文本片段,二者协同提升真伪判定、源节点识别与立场分析的联合性能。该技术方案兼顾结构建模能力与语义细粒度表达,在微博等中文舆情场景中具备强可解释性与工程落地价值,适用于毕业设计、轻量级舆情监控系统开发及多任务学习实践。 阅读详情

相关推荐

中文谣言检测从数据清洗到模型评估的完整实践指南

文本分类是自然语言处理中的基础任务之一,其核心在于将非结构化文本映射到预定义类别。在实际工程中,类别不平衡、数据泄漏和评估指标选择往往比模型结构更影响最终效果。中文谣言检测作为典型的短文本二分类场景,需要处理微博平台特有的噪声符号、事件级关联和时效性信息。常见技术路线包括基于TF-IDF与逻辑回归的基线方案,以及TextCNN、预训练模型等深度学习方法。数据清洗阶段需按特定顺序过滤话题、@用户、链接和特殊符号,并谨慎处理否定词;评估阶段应重点关注宏F1和谣言类召回率,而非仅依赖准确率。事件级划分和固定随机种

weixin_32501329的博客 85

基于机器学习的微博突发事件分析与谣言检测

近年来,国内外先后爆发了由谣言传播引发的群体性突发事件,严重扰乱了人们的生活秩序,影响了社会的稳定,造成的损失超出了社会资源所能承受的能力[4]。又如2018年10月28日,重庆万州公交车坠江事件相关微博引起了人们的关注,事件发生后由于官方权威媒体没有及时发布调查结果通报,导致一时间网络上出现了许多有关公交车司机不规范驾驶导致事故的相关谣言,而处在消息不对称一端的用户在网络谣言的误导下纷纷针对公交车司机进行舆论攻击,直到权威媒体公布事故调查真相时,才将谣言止住。最后介绍本文的研究内容以及章节结构安排。

wm1634208243的博客 456

谣言检测不是文本分类:基于图结构与双路注意力的多任务建模

谣言检测本质上是信息传播建模问题,而非孤立文本的二分类任务。其核心原理在于将社交传播过程抽象为异构图结构,通过图卷积神经网络(GCN)捕获节点间依赖关系,并借助双路注意力机制分别建模文本语义可信度与传播路径可信度。该技术显著提升模型可解释性与鲁棒性,尤其适用于含转发/回复关系的真实舆情数据(如Weibo、PHEME)。在毕业设计与轻量级舆情监控系统中,它支持三任务联合输出——文本可信度、传播异常度、节点立场倾向,兼顾精度、部署效率与决策溯源能力。

weixin_32181267的博客 165

使用PaddlePaddle进行微博谣言检测

近期,在新冠肺炎疫情防控的关键期,网上各种有关疫情防控的谣言接连不断,这些谣言操纵了舆论感情,误导了公众判断,更影响了社会稳定。本项目基于基于循环神经网络(RNN)的课言检测模型实现了微博谣言检测 本实践使用 Paddle Fluid API 编程并搭建一个循环神经网络(Recurrent Neural Network,RNN),进行谣言检测。主要分为五个步骤: 1.数据准备 2.模型配置 3.模...

qq_34519470的博客 3921

多模态虚假新闻检测:图文语义对齐与对比学习实战

多模态虚假新闻检测本质是建模文本与图像在语义空间中的对齐偏差,而非简单特征拼接。其核心原理在于通过跨模态特征投影、归一化与对比学习(如InfoNCE损失),构建可比、可判别的联合嵌入空间。该技术显著提升模型对图文矛盾(如文字称地震而图片为旧纪录片空镜)的识别能力,具备强鲁棒性与抗噪性。典型应用场景包括社交媒体谣言治理、新闻内容风控及AIGC生成内容鉴伪。本文聚焦微博谣言数据集(Weibo-Rumor)上的工程落地,覆盖BERT+ResNet双塔对齐、In-batch对比训练、F1-macro/AUC科学评估

weixin_42524100的博客 254

多任务谣言检测系统:图神经网络+注意力+双任务联合建模

谣言检测是社交网络内容安全的关键技术,其本质在于建模信息传播的拓扑结构与语义立场关联。基于图神经网络(GNN)可显式刻画转发树等传播图结构,结合多头自注意力机制(MSA)实现节点特征的动态加权聚合;再通过共享编码器下的双任务联合建模,同步完成立场分类与谣言判定,兼顾任务相关性与梯度平衡。该范式显著提升小样本场景下的泛化能力与标签利用效率,广泛适用于PHEME、SemEval等主流数据集,在本科毕设、课程设计及轻量级NLP-GNN融合实践中具备强落地性。本文聚焦ABGCN架构的完整实现闭环,涵盖图构建、BiG

weixin_29056101的博客 137

深度学习毕业设计 CNN实现谣言检测系统 - python 机器学习

Hi,大家好,学长今天向大家介绍 一个深度学习项目基于CNN实现谣言检测。

caxiou的博客 1790

基于多模态特征融合的短视频谣言检测系统:从原理到工程实践

深度学习通过模拟人类感知,正逐步实现对图像、文本、音频等多模态信息的综合理解。其核心原理在于利用神经网络提取不同模态的高维特征,并通过特征融合技术实现信息互补,从而提升模型对复杂数据的表征与决策能力。这一技术价值在于突破了单一模态分析的局限,在内容安全、智能交互、医疗诊断等领域展现出巨大潜力。尤其在内容安全领域,面对融合了视觉、听觉和文本的短视频谣言,传统的单模态检测方法往往失效。本文聚焦的**基于多模态特征融合的短视频谣言检测系统**,正是应用**注意力机制**等先进融合策略,教会计算机综合“看”画面、“

weixin_33754065的博客 431

基于LSTM的谣言检测系统的设计与实现

基于LSTM的谣言检测系统的设计与实现 [关键词]自然语言处理;谣言检测;LSTM;深度学习;社交媒体;文本分类;用户响应;传播路径

席万里的博客 1085

谣言检测新范式:图神经网络+多任务学习+跨节点注意力

谣言检测本质上是基于传播结构的多源证据推理问题,而非单纯文本分类。其核心原理在于建模信息传播的拓扑性、时序性和多粒度性——图神经网络(GCN)刻画转发关系结构,多任务学习协同优化真伪判别、传播深度与用户可信度,跨节点注意力机制则实现帖子可疑表述与评论辟谣证据的语义对齐。该技术组合显著提升模型鲁棒性与可解释性,广泛适用于微博、Twitter等社交平台的实时谣言识别系统,并为毕业设计与工业落地提供高复现性baseline。

weixin_31715171的博客 140

AI人工智能与TensorFlow的教育科技应用

随着科技的飞速发展,AI人工智能在各个领域都展现出了巨大的潜力,教育领域也不例外。本文章的目的在于深入探讨AI人工智能与TensorFlow在教育科技中的具体应用,包括智能教学系统的开发、学生学习情况的评估与预测等方面。范围涵盖了从基础概念到实际项目应用的各个层面,旨在为教育科技工作者和相关研究者提供全面且深入的技术指导。本文将首先介绍AI人工智能和TensorFlow的核心概念及其联系,让读者对相关技术有基本的了解。接着详细讲解核心算法原理和具体操作步骤,并结合数学模型和公式进行深入分析。

AI智能探索者的博客 1697

深度学习CNN谣言识别检测系统

这两年开始,各个学校对毕设的要求越来越高,难度也越来越大… 毕业设计耗费时间,耗费精力,甚至有些题目即使是专业的老师或者硕士生也需要很长时间,所以一旦发现问题,一定要提前准备,避免到后面措手不及,草草了事。!全市通缉!!')print('预测结果为:', lab[np.argmax(result.numpy())])

8848

ClickHouse分布式表原理:大数据分片存储与查询

我是一名资深大数据工程师,专注于ClickHouse优化和分布式架构设计。拥有5年以上大数据开发经验,曾为多家电商、金融公司提供ClickHouse解决方案。欢迎关注我的博客(),一起探讨大数据技术!留言互动:你在使用ClickHouse分布式表时遇到过什么问题?欢迎在评论区分享,我会一一解答!

AI大模型应用之禅 959

深度学习毕业设计 CNN谣言检测系统 - python

Hi,大家好,学长今天向大家介绍 一个深度学习项目基于CNN实现谣言检测。

kooerr的博客 611

SRA数据库

简介 序列读取存档(sequence Read Archive,SRA)数据是可通过多个云提供商和NCBI服务器获得的,它是最大的可公开获得的高通量测序数据存储库。 SRA接受来自生活各个部门以及宏基因组学和环境调查的数据。 SRA存储原始测序数据和比对信息,以提高可重复性并通过数据分析促进新发现。 NCBI网站储存二代测序原始数据的数据库 SRA官网 从Entrez搜索结果中下载SRA序列 例如查找SRA Entrez中BALB / c小鼠淋巴结组织的RNA-Seq记录 获取搜索结果 SRA se

qq_44520665的博客 5911

IKM 测试题 - Java SE 8 评估测试题目

IKM 测试题 - Java SE 8 评估测试题目

licheng11y的博客 1314

计算机毕业设计Python+Flask微博舆情分析 微博情感分析 微博爬虫 微博大数据 舆情监控系统 大数据毕业设计 NLP文本分类 机器学习 深度学习 AI

计算机毕业设计Python+Flask微博舆情分析 微博情感分析 微博爬虫 微博大数据 舆情监控系统 大数据毕业设计 NLP文本分类 机器学习 深度学习 AI

全网计算机/大数据辅导(自媒体)道祖第一人、全网粉丝100W+,专注于大学生项目实战开发,讲解,毕业答疑辅导,高校老师/讲师/同行合作。以及产品测评宣传、工具推广等合作。同时招收学生代理、校园代理。 2525

产品缺陷检测:表面缺陷检测_(1).产品缺陷检测基础理论

确定像素之间的相似性准则,如灰度值的差异。

zhubeibei168的博客 832

毕业设计选题:基于机器学习的虚假新闻识别系统 人工智能 python

毕业设计选题-基于深度学习的虚假新闻识别系统 该模型能够学习虚假新闻与真实新闻之间的语义和结构差异,从而精准地识别虚假新闻。无论您对深度学习技术感兴趣,还是希望在机器学习、算法或人工智能领域探索,抑或对深度学习和虚假新闻识别技术充满好奇,都将为您提供宝贵的灵感和研究方向。该虚假新闻识别系统在新闻媒体、社交媒体平台、信息验证等领域具有广泛的应用前景。对于计算机科学、自然语言处理、数据科学等专业的毕业生而言,掌握数据处理、模型构建和性能评估等关键技能,为您的毕业设计奠定坚实的基础。

2301_79555157的博客 3490

C# 调用高德地图关键词 API

今天我们要一起探索如何使用 C# 来调用高德地图的关键词搜索 API,从而实现精准的地理位置搜索功能。高德地图的关键词搜索 API 可以帮助我们轻松地实现这一点,它能够返回一系列匹配关键词的地点坐标和其他相关信息。通过简单的几行 C# 代码,我们就实现了调用高德地图关键词搜索 API 的功能。接下来,我们将在一个 C# 控制台应用中实现调用高德地图关键词搜索 API 的功能。此外,如果要在生产环境中使用,还需要考虑安全性问题,例如不要在客户端暴露 API 密钥。🔥关注墨瑾轩,带你探索编程的奥秘!

java专栏 1105

人工智能专业毕业设计选题灵感集锦:新颖课题 25届

人工智能专业毕业设计选题合集涵盖了深度学习、机器学习、算法、人工智能、大数据、信息安全、推荐系统、目标检测等多个热门领域。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心收集了各种有趣且具有挑战性的选题,旨在帮助学生们在毕业设计中展现他们的技术实力和创新能力。不论是对于对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能的领域的同学,本合集都能为您提供丰富的选题资源和灵感。

2301_79555157的博客 1236

FPGA 学习笔记:Vivado 2020.2 MicroBlaze MIG 测试 DDR3 篇四

FPGA 学习笔记:Vivado 2020.2 MicroBlaze MIG 测试 DDR3 篇四

坚韧与专注 2162

人工智能毕业设计选题宝典:新兴课题与挑战

人工智能毕业设计选题合集涵盖了深度学习、机器学习、算法、人工智能、大数据、信息安全、推荐系统、目标检测等多个热门领域。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心收集了各种有趣且具有挑战性的选题,旨在帮助学生们在毕业设计中展现他们的技术实力和创新能力。不论是对于对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能的领域的同学,本合集都能为您提供丰富的选题资源和灵感。

毕设帮助,疑难解答,欢迎打扰! 1099

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

深度学习类毕业设计选题汇总:2025

深度学习类毕业设计选题研究方向包括计算机视觉、自然语言处理、语音识别、强化学习和生成模型等研究方向。对于计算机专业、人工智能专业、大数据专业、信息安全专业、软件工程专业、的毕业生而言,不论是对于对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能的领域的同学,都能为您提供丰富的选题资源和灵感。

机器学习,深度学习,计算机视觉爱好者,整理分享技术资料与项目案例。 1610

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

人工智能领域毕业设计选题宝典:指导建议

人工智能领域毕业设计选题合集涵盖了深度学习、机器学习、算法、人工智能、大数据、信息安全、推荐系统、目标检测等多个热门领域。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心收集了各种有趣且具有挑战性的选题,旨在帮助学生们在毕业设计中展现他们的技术实力和创新能力。不论是对于对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能的领域的同学,本合集都能为您提供丰富的选题资源和灵感。

毕设帮助,疑难解答,欢迎打扰! 848

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

上一篇: 毕业设计:基于卷积神经网络的验证码识别系统 机器视觉 人工智能
下一篇: 毕业设计- 基于深度学习的小样本时间序列预测算法 - Attention
Mini_hailang_IT
博客等级 码龄9年 5936粉丝 640原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值