毕业设计:复杂场景下的文本检测与识别系统

自然场景文本检测识别技术综述 其它机器学习、深度学习算法的全面系统讲解可以阅读《机器学习-原理、算法与应用》,清华大学出版社,雷明著,由SIGAI公众号作者倾力打造。 书的购买链接 书的勘误,优化,源代码资源 番外青蛇: 姐, 图像文本检测和识别领域现在的研究热点是什么? 白蛇: 白纸黑字的扫描文档识别技术已经很成熟,而自然场景图像文本识别的效果还不理想。倾斜字、艺术字、变形字、模糊字、形似字、残缺字、光影遮蔽、多语... 阅读详情

目录

前言

一、课题背景与意义

二、算法理论技术

2.1 场景文本检测

2.2 算法实现

三、模型训练

3.1 数据处理

3.2 实验环境

3.3 结果分析

最后


前言

 📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。

        🚀对毕设有任何疑问都可以问学长哦!

         选题指导:

        最新最全计算机专业毕设选题精选推荐汇总

        大家好,这里是海浪学长毕设专题,本次分享的课题是

        🎯复杂场景下的文本检测与识别系统


一、课题背景与意义

        在现实生活中,复杂场景中的文本检测与识别一直是计算机视觉领域的重要研究方向。复杂场景指的是包含多种复杂背景、光照不均、尺度变化、遮挡等因素的图像或视频中的文本。传统的文本检测与识别方法在这些复杂场景中常常面临困难,无法实现准确的文本定位和识别,限制了相关应用的发展。复杂场景下的文本检测与识别系统在提升图像和视频理解能力、改善自动驾驶和智能交通系统、促进图像搜索和信息检索技术以及推动深度学习和计算机视觉发展方面具有重要意义。

二、算法理论技术

2.1 场景文本检测

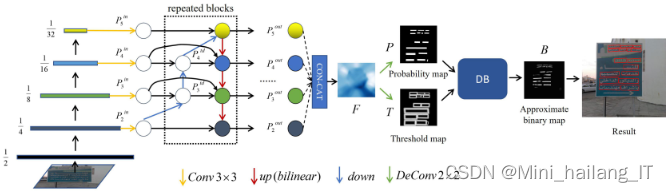
        近年来,基于像素分割的文本检测算法成为主流,如PSENet和DBNet。PSENet通过对每个文本实例生成不同规模的文本内核来进行多个预测,而DBNet则使用一个缩小的文本内核,并引入自适应阈值图和可微分二值化方法来提高后处理效率。然而,DBNet在特征提取与融合过程中存在特征丢失问题,导致标定的文本框不够准确,尤其对长文本中的字符标定困难。为解决这些问题,提出加强网络的特征提取与融合部分,通过引入SA注意力机制提升特征提取能力,并采用双向特征融合机制和高效的上采样方式。同时,在训练方式上采用预训练后微调的形式,使用多语种数据集进行预训练,以实现检测多语种文本并在实际场景中表现更好的效果。
毕业设计:复杂场景下的文本检测与识别系统

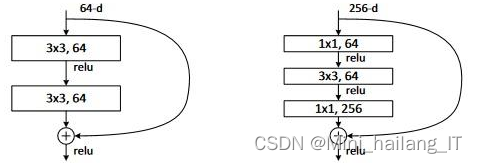
        在文本检测中,为了在复杂背景下检测形式多样的文本,首先需要一个强大的特征提取器。基于深度学习的方法使用卷积神经网络来提取特征作为检测任务的基础。网络层越深,可更新的神经元越多,对于特定任务的拟合能力更强,但深层网络也会面临梯度消失/爆炸和网络退化等问题。ResNet通过引入残差单元有效克服了深层神经网络中的梯度消失和网络退化问题,使得文本检测任务可以通过深层网络获得良好的效果。此外,ResNet广泛使用3×3卷积操作,而Nvidia GPU对该操作进行了优化,使得ResNet在Nvidia GPU上的训练和推理效率都非常高。
毕业设计:复杂场景下的文本检测与识别系统

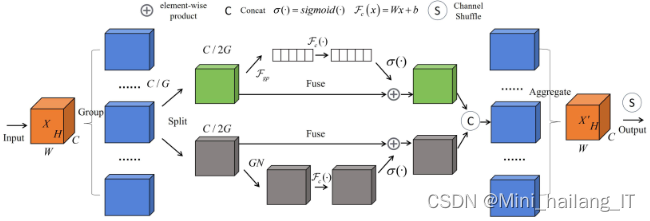
        为了提高主干网络在场景文本特征提取方面的准确性,在ResNet中加入了SA(Spatial and Channel)注意力机制。SA注意力机制结合了空间注意力和通道注意力,以提升主干网络的特征提取能力。
        通道注意力机制的目标是根据通道的重要性,在特征图中为不同通道分配不同的权重,增强重要通道的信息,抑制不重要通道,并通过不同权重对特征进行重新组合。在自然场景图像中存在噪声,通道注意力机制可以抑制噪声通道的影响。
        空间注意力机制的目标是在特征图中确定最重要的位置。图像中的不同区域对于检测任务的贡献程度不同,通过空间注意力机制,网络能够快速有效地关注到关键区域,提高检测的精确性和效率。
毕业设计:复杂场景下的文本检测与识别系统

代码如下(示例):

class SAAttention(nn.Module):
    def __init__(self, in_channels, reduction_ratio=16):
        super(SAAttention, self).__init__()
        self.pool = nn.AdaptiveAvgPool2d(1)
        self.fc1 = nn.Conv2d(in_channels, in_channels // reduction_ratio, kernel_size=1, stride=1, padding=0)
        self.relu = nn.ReLU(inplace=True)
        self.fc2 = nn.Conv2d(in_channels // reduction_ratio, in_channels, kernel_size=1, stride=1, padding=0)
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        # Spatial attention
        spatial_attention = self.pool(x)
        spatial_attention = self.fc1(spatial_attention)
        spatial_attention = self.relu(spatial_attention)
        spatial_attention = self.fc2(spatial_attention)
        spatial_attention = self.sigmoid(spatial_attention)

        # Channel attention
        channel_attention = torch.mean(x, dim=(2, 3), keepdim=True)
        channel_attention = self.fc1(channel_attention)
        channel_attention = self.relu(channel_attention)
        channel_attention = self.fc2(channel_attention)
        channel_attention = self.sigmoid(channel_attention)

        # Apply attention
        x = x * spatial_attention + x * channel_attention

        return x

2.2 算法实现

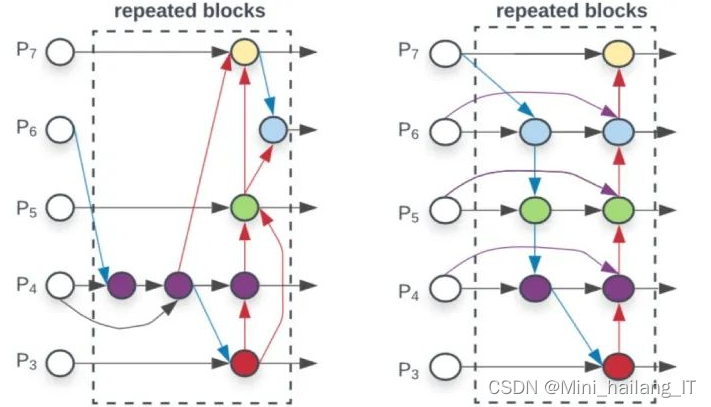
        在目标检测任务中,无论是大文本还是小文本,都需要进行准确的检测。为了解决这个问题,需要在不同的特征层之间进行特征融合,以获得更好的检测结果。深层特征通常携带更丰富的语义信息,可以用于检测大尺寸目标,而浅层特征更适合检测小尺寸目标。FPN(Feature Pyramid Network)通过将深层特征图逐个上采样到次深层特征图来进行特征融合,但这种单向信息流的方式不可避免地导致信息损失。
        为了增强文本检测网络的特征融合性能,使得不同大小的文本都能更好地被检测到,本学位论文采用了双向特征融合机制(BiFPN)。双向特征融合包括从高语义特征图向低语义特征图的上采样融合和从低语义特征图向高语义特征图的下采样融合。通过对不同特征层进行加权融合,根据其重要程度进行特征层级别的注意机制。双向特征融合模块可以在模型中重复使用,并根据需要选择重复次数。通过双向特征融合,不同特征层之间的信息得到了良好的交流和融合,从而提高了文本检测的性能。
毕业设计:复杂场景下的文本检测与识别系统

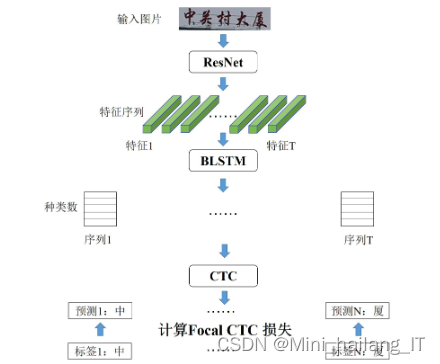
        对CRNN算法进行改进,并将其应用于场景中文识别中。通过替换主干网络为ResNet18和ResNet34,增强了对复杂图像特征的提取能力。引入Focal CTC损失解决了中文数据集中的样本不平衡问题,并提升了模型对出现次数较少字符的识别能力。同时,采用在线数据增强技术缓解了过拟合问题。这些改进使得CRNN算法在场景中文识别中表现更好,提高了模型的性能和鲁棒性。
毕业设计:复杂场景下的文本检测与识别系统

代码如下(示例):

class CRNN(nn.Module):
    def __init__(self, backbone='resnet18', num_classes=1000):
        super(CRNN, self).__init__()

        # Define the backbone network
        if backbone == 'resnet18':
            self.backbone = models.resnet18(pretrained=True)
            backbone_out_channels = 512
        elif backbone == 'resnet34':
            self.backbone = models.resnet34(pretrained=True)
            backbone_out_channels = 512
        else:
            raise NotImplementedError("Backbone '{}' is not supported.".format(backbone))

        # Remove the last fully-connected layer
        self.backbone = nn.Sequential(*list(self.backbone.children())[:-1])

        # Add the CRNN layers
        self.rnn = nn.GRU(backbone_out_channels, hidden_size=256, num_layers=2, bidirectional=True)
        self.fc = nn.Linear(256 * 2, num_classes)

    def forward(self, x):
        # Extract features using the backbone network
        features = self.backbone(x)
        features = features.squeeze(2).permute(2, 0, 1)  # Shape: (T, N, C)

        # Apply the RNN layers
        recurrent_features, _ = self.rnn(features)

        # Apply the fully-connected layer
        output = self.fc(recurrent_features[-1])

        return output

三、模型训练

3.1 数据处理

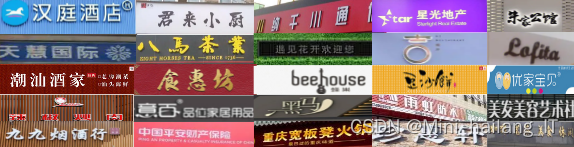
        由于网络上没有现有的合适的数据集,我决定自己去现场进行拍摄,收集图片并制作了一个全新的数据集,专注于文本检测任务。这个数据集包含了各种真实场景中的文本图片,涵盖了不同的背景、字体、大小和方向等多样性。通过现场拍摄,我能够捕捉到真实的环境和多样的文本样式,这将为我的研究提供更准确、可靠的数据。
毕业设计:复杂场景下的文本检测与识别系统

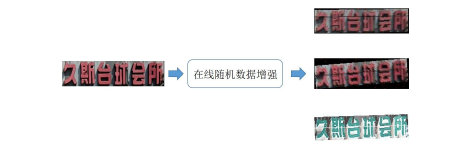
        在不定长文本识别任务中,由于文本标注不可改变且字符之间有位置关系,数据增强不能破坏这些属性。因此,本研究采用了一系列数据增强方法,如对比度调整、亮度调整、锐度调整、加横线、旋转、添加椒盐噪声和颜色翻转等。这些方法在保留原数据字符的主要特征和字符间顺序关系的同时,给文本图像引入一定的扰动,以提升模型的鲁棒性。
3.2 实验环境

        本研究在硬件环境方面使用了Ubuntu 20.04操作系统,并配置了两张NVIDIA GeForce RTX 3090显卡和Intel Xeon Gold 6130H CPU。这样的硬件配置可以提供较高的计算性能和并行处理能力,有助于实现高效的场景文本检测。

        在软件环境方面,采用Python作为编程语言,并使用PyTorch 1.8.1作为深度学习框架。此外,CUDA版本为11.1,可以充分利用NVIDIA显卡的计算能力加速深度学习任务。这样的软件环境配置为场景文本检测提供了强大的工具和库支持。

3.3 结果分析

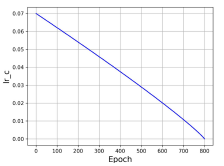
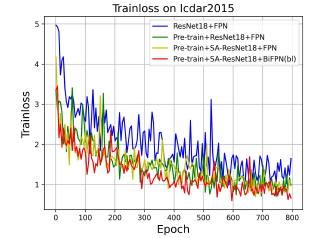
        在模型训练过程中,采用了预训练和微调的策略。首先,在合成数据集上进行了100轮的预训练,通过大规模合成数据的训练来初始化模型权重。然后,在真实数据集上进行微调,通过在真实场景中对模型进行微调来提高其性能和泛化能力。训练过程中,使用了批量大小为16和初始学习率为0.007的设置,并采用指数递减的学习率调度策略。通过这种组合训练策略,模型能够充分利用合成数据和真实数据的优势,达到更好的性能和泛化能力。
        在数据集上,通过将ResNet18和FPN组合进行训练得到了基线模型。随后采用预训练后微调的策略,在基线模型的基础上进行改进。首先,在ResNet18中引入SA注意力机制以增强网络对关键特征的关注。接着,将FPN替换为双向特征融合机制BiFPN,并改变了上采样中的插值方式,使用双线性插值来提升上采样结果的精度。通过这些改进,旨在提高文本检测模型在数据集上的性能和准确度。这些研究和改进有望推动文本检测领域的进展,并为实际应用提供更准确和可靠的文本检测技术。

最后

SSD与Resnet融合的车牌识别系统毕业设计 SSD(Single Shot MultiBox Detector)是一种被广泛用于对象检测的深度学习模型,以其在速度和精度上的平衡优势,在实时车牌检测中尤为突出。与传统R-CNN系列相比,SSD模型通过在多个尺度上进行目标预测,大大提升了检测速度。Caffe是一个由伯克利人工智能研究(BAIR)实验室主导开发的深度学习框架,主要用于图像处理和模式识别。Caffe拥有高效的内存使用和计算速度,是众多研究人员和开发者进行深度学习实验的首选工具之一。 阅读详情

相关推荐

智能文档OCR识别系统:基于YOLOv8与CRNN的毕业设计实践

OCR文字识别是计算机视觉与自然语言处理的交叉任务,在文档数字化和办公自动化中至关重要。主流的深度学习方案常采用两段式架构:先通过目标检测网络定位图像中的文本区域,再利用序列识别模型将裁剪区域解码为字符序列。YOLOv8作为高效的目标检测框架,能够快速提取文档中的文本行和表格区域;CRNN结合CTC解码则擅长处理中文等大字符集序列预测,兼顾精度与训练成本。这种检测与识别解耦的设计,既便于单独调优,也适合在有限硬件条件下复现。本文围绕智能文档OCR识别系统的完整流程,讲解数据准备、模型训练、部署演示及常见避坑

weixin_28725407的博客 221

毕设项目分享 基于深度学习的中文汉字识别 - 深度学习 卷积神经网络 机器视觉 OCR

最近在帮一位同学做中文汉字识别项目,学长在这记录和发布一些项目相关知识基础和部分实现,欢迎同学们讨论学习🧿。

kooerr的博客 948

工业场景数字识别:基于深度学习的检测与识别系统实战

光学字符识别(OCR)是计算机视觉领域的基础技术,其核心原理是通过图像处理和模式识别算法,将图像中的文字信息转换为可编辑的文本数据。随着深度学习技术的发展,特别是卷积神经网络(CNN)的应用,OCR系统的准确率和鲁棒性得到了显著提升,使其能够应对复杂多变的真实场景。这项技术的核心价值在于实现了信息提取的自动化,极大地提升了数据处理的效率和准确性。在工业制造、物流分拣、文档数字化等众多领域,OCR技术都发挥着关键作用。本文聚焦于工业质检这一典型应用场景,深入探讨如何构建一个高鲁棒的深度学习OCR系统,其中涉及

weixin_29029995的博客 237

文本检测实战:使用OpenCV实现文本检测(EAST 文本检测器)

在本教程中,您将学习如何使用 OpenCV 使用 EAST 文本检测器检测图像中的文本。 EAST 文本检测器要求我们在我们的系统上运行 OpenCV 3.4.2 或 OpenCV 4 。 论文原文:https://arxiv.org/abs/1704.03155 代码地址:https://github.com/argman/EAST 在今天教程的第一部分中,我将讨论为什么在自然场景图像中检测文本会如此具有挑战性。 从那里我将简要讨论 EAST 文本检测器,我们为什么使用它,以及是什么让算法如此

AI浩 9013

VS Code配置Java开发环境避坑指南:从JDK到Spring Boot插件全流程

本文详细介绍了在VS Code中配置Java开发环境的完整流程,涵盖JDK选择、环境变量配置、核心插件安装、构建工具优化及Spring Boot项目专项设置。特别针对常见问题提供避坑方案,帮助开发者快速搭建高效稳定的开发环境,提升Java和Spring Boot开发效率。

weixin_28839699的博客 979

微信图片.dat文件解密实战:用Python一键转PNG(附完整代码)

本文详细介绍了如何通过Python解密微信图片.dat文件并转换为PNG格式的完整教程。文章深入解析了微信.dat文件的异或加密原理,提供了自动检测密钥的Python脚本,并分享了批量解密和性能优化的实用技巧,帮助用户轻松恢复和整理微信聊天图片。

weixin_29096377的博客 465

毕业设计-基于深度学习的文字识别系统

毕业设计-基于深度学习的文字识别系统:​文字识别是指电子设备(例如扫描仪或数码相机)检查纸上打印的字符,然后用字符识别方法将形状翻译成计算机文字的过程;即,对文本资料进行扫描,然后对图像文件进行分析处理,获取文字及版面信息的过程。如何除错或利用辅助信息提高识别正确率,是OCR最重要的课题。衡量一个OCR系统性能好坏的主要指标有:拒识率、误识率、识别速度、用户界面的友好性,产品的稳定性,易用性及可行性等。在文字识别领域中,深度学习的运用,促使文字识别技术的发展,提升文字识别技术的应用价值。文 字识别技术就是

Hai_Lang_IT的博客 2685

GPOPSII 对控制量变化率进行约束,避免控制量振荡

在这篇文章中,在GPOPSII中通过对控制量变化的约束,优化求解得到更平滑的控制量曲线,更符合真实控制约束。

Dannyfomer的博客 1870

毕业设计选题-基于深度学习的名片识别算法系统 人工智能 python OCR

毕业设计选题:基于深度学习的名片识别算法系统的毕业设计。通过融合先进的计算机视觉技术和深度学习算法,该系统能够高效准确地识别名片中的关键信息,如姓名、职位、联系方式等,为快速数字化和管理名片提供便利。为计算机科学、人工智能、图像处理等专业的毕业生提供了一个富有挑战和创新的研究课题。无论您对深度学习技术保持浓厚兴趣,还是希望在图像识别、模式识别或人工智能领域深入研究,将为您提供丰富的资源和启发。通过深入学习和实践,您将掌握名片识别算法系统的设计原理和实现方法,为未来的信息管理和智能办公领域做出重要贡献。

Hai_Lang_IT的博客 1254

《UE4游戏开发》之 《音效系统的实现》

音效系统需要负责管理什么事情: 1.1 确定声音控制的分类:如背景音乐、技能音效、界面音效、角色配音等,不同游戏对声音有不同的分类 1.2 控制每个分类的声音的开启与关闭,以及调节每个分类声音的大小 解决如何分类: 2.1 首先需要知道ue4为声音分类提供了什么:SoundClass通常需要一个根分类【SC_RPG_Master】,便于总体控制音效,以及指定引擎默认启动的音效 打开SoundClass资产【SC_RPG_Master】,对根控制的设置,将逐级传递并按比例进行设置,以此达到控制一类声音的目的.

qq_21919621的博客 2126

第一章 DRM 子系统概述:1.2 专栏定位与技术覆盖范围

本专栏系统解析Linux内核DRM图形子系统的核心技术,涵盖GEM对象管理、TTM内存机制、DRM-Fence同步等核心模块,深入剖析DMA-BUF共享、DMA_Resv资源管理等关键技术。通过解读内核源码与用户态接口(libdrm),结合进程管理、匿名inode等底层机制,构建完整的DRM知识体系。专栏兼顾深度与易懂性,辅以实际应用场景分析,既适合图形驱动开发新手入门,也可满足资深工程师进阶需求,帮助读者掌握从内核实现到应用开发的全栈知识。

图形/计算GPU的驱动与虚拟化技术分享园地 3029

毕业设计:复杂背景下的闯红灯识别系统 目标检测

毕业设计:复杂背景下的闯红灯识别系统为计算机毕业设计提供了一个创新的方向,结合了深度学习和计算机视觉技术,为毕业生提供了一个有意义的研究课题。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,提供了一个具有挑战性和创新性的研究课题。无论您对深度学习技术保持浓厚兴趣,还是希望探索机器学习、算法或人工智能的领域的同学,能为您提供灵感和指导。该系统利用先进的深度学习算法和计算机视觉技术,能够在复杂背景下准确地识别行人闯红灯的行为,为交通安全提供有效的监测和预警。

2301_79555157的博客 1508

复旦微实现串口在线升级BOOT.BIN

将该 demo 生成的 app(升级用)和 fsbl、最简化 bit 文件(可选)打包成 BOOT.BIN,作为 golden image 烧写在 qspi flash 偏移 0 地址开始的位置,其中最简化 bit 文件为在线升级功能提供必要的物理通道(如果不需要,可以不打包该文件),golden image 一旦发布基本不需要进行升级,由该 golden image 负责和上位机进行通信交互,完成业务 app、业务 bit 文件、uboot 以及操作系统 image 等文件在线升级,在qspi flash

wangjie36的博客 3174

毕业设计选题-计算机视觉:复杂场景下的车牌识别系统 人工智能 深度学习 YOLO

毕业设计选题-计算机视觉:复杂场景下的车牌识别系统利用先进的图像处理和机器学习算法,能够准确地检测和识别车辆的车牌号码,为交通管理和安全监控提供重要的技术支持。在多种复杂场景下展现出出色的车牌识别性能,具备广泛的应用前景。为计算机科学、人工智能、图像处理等专业的毕业生提供了一个具有挑战性和创新性的研究课题。无论您对对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能的领域的同学,还是对深度学习和车牌识别技术充满好奇的读者,都将为您提供灵感。

毕设帮助,疑难解答,欢迎打扰! 1738

uniapp(全端兼容) - 最新实现全局设置修改字体大小功能,统一修改全部页面所有文字的大小(标准/小/中/大字号切换,用户修改后整个项目立即生效)设置应用字体的大小(详细示例代码,一键复制开箱即用

uni-app,支付宝微信小程序,h5,手机端H5网页,移动端网站,安卓app,ios苹果app,nvue,全局设置字体大小,退出后还能记录字号大小,uniApp将全部页面的字体字号进行修改,uniapp设置改变全局字体大小功能,动态调整应用字体大小,详细教程,动态显示字体大小,可调整显示字体大小,如何解决不同端字体大小的问题,除了rem还有什么方法,设置全局字体大小,用户设置字号大小,应用字体大中小,实现用户全局设置应用字体大小,老年模式字体设置思路,h5端不行怎么办,移动端不生效,修改全局字号,一键改整

✅ 精选推荐文章 8885

黑猫带你学eMMC协议第2篇:eMMC部分相关名词释义

1 前言 1.1 声明 本文依据eMMC JEDEC5.1、网络资料及个人工作经验整理而成,如有错误请留言。 本文结合eMMC JEDEC5.1协议手册查看效果更佳。 1.2 本文背景 本文关键词不包括emmc jedec5.1协议第3章节:《Terms and definitions》内容。关于emmc协议层的关键词,直接查阅spec相关章节即可,清晰明了,此处没必要再列出。 本文为本人工作学习中常听到或常用到关乎于emmc/flash的一些关键词合集,没有固定分类,不需要强行记忆,供查询使用。 1.

黑猫奥利奥的博客 7434

毕业设计-基于深度学习的智能车牌识别系统

毕业设计-基于深度学习的智能车牌识别系统:智能车牌识别技术是智能交通工程领域的重要环节,在交通监视与控制方面占有举足轻重的地位。从车 牌识别的一般流程出发,设计基于CenterNet目标检测以及CNN卷积神经网络的智能车牌识别系统。利用CenterNet网络 高效定位车牌位置,通过对检测截取出的车牌进行直方图增强、灰度处理、倾斜矫正、边框去除等图像预处理,有效增强图片对比度,便于提取有用的特征信息。将处理后的车牌信息传入卷积神经网络进行训练,结果显示智能车牌识别系 统有较高的准确率和时效性,对于不同光照、不

Hai_Lang_IT的博客 5967

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

毕业设计:基于深度学习的铁轨障碍物检测与识别系统

毕业设计:基于深度学习的铁轨障碍物检测与识别系统实现对铁轨上障碍物的自动检测和识别。具有较高的检测和识别准确率,能够显著提高铁路安全防护能力。本研究为计算机毕业设计提供了一个创新的方向,结合了深度学习和计算机视觉技术,为毕业生提供了一个有意义的研究课题。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,提供了一个具有挑战性和创新性的研究课题。无论您对深度学习技术保持浓厚兴趣,还是希望探索机器学习、算法或人工智能的领域的同学,本研究能为您提供灵感和指导。

Hai_Lang_IT的博客 2077

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

(毕设版)基于 YOLOv5 的交通信号标志识别系统(Python+PyQt+OpenCV・目标检测)大数据毕业设计✅

(毕设版)基于 YOLOv5 的交通信号标志识别系统(Python+PyQt+OpenCV・目标检测)大数据毕业设计✅

q_3375686806的博客 1033

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

【毕业设计】基于深度学习的路面交通标志检测识别系统

毕业设计:基于深度学习的路面交通标志检测识别系统结合了深度学习和计算机视觉技术,实现了路面交通标志的自动检测和识别。该系统利用深度神经网络模型,能够准确地定位和识别道路上的各类交通标志,包括限速标志、禁停标志、指示标志等。通过大规模数据集的训练和优化,该系统在复杂的交通场景下表现出了出色的性能和鲁棒性。本文研究为计算机毕业设计提供了一个创新的方向,结合了深度学习和计算机视觉技术,为毕业生提供了一个有意义的研究课题。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,提供了创新型的课题。

2301_79555157的博客 2106

毕业设计救星:快速搭建万物识别系统的完整教程

准备标注好的数据集(至少每类50张图片)使用提供的train.py脚本进行微调:bash训练完成后,替换models目录下的权重文件通过这个万物识别系统镜像,你应该能够在短时间内搭建起智能货架系统的核心功能,为毕业设计答辩赢得宝贵时间。现在就可以拉取镜像试试,体验开箱即用的便利。添加数据库支持,记录识别历史开发库存管理功能,基于识别结果自动更新库存实现实时视频流处理,而不仅是静态图片添加用户界面,方便超市员工使用。

ThunderstormDragon65的博客 321

毕业设计:基于深度学习的野生动物种类识别系统 目标检测 人工智能

毕业设计:基于深度学习的野生动物种类识别系统融合了深度学习和计算机视觉技术,旨在解决野生动物种类识别的难题。将介绍系统的设计原理和关键技术,探讨其在野生动物保护和生态研究领域的应用前景。为计算机、软件工程、人工智能和大数据等专业的毕业生提供了一个有意义的研究课题。无论您对深度学习技术保持浓厚兴趣,还是希望探索机器学习、算法或人工智能领域的同学,本文将为您提供灵感和指导,引领您进入这个具有挑战性和创新性的研究领域。

毕设帮助,疑难解答,欢迎打扰! 2812

毕业设计 基于深度学习二维码检测识别系统

今天学长向大家分享一个毕业设计项目**毕业设计 基于深度学习二维码检测识别系统 **毕业设计 深度学习二维码检测识别二维条码/二维码(2-dimensional barcode)是用某种特定的几何图形按一定规律在平面(二维方向上)分布的、黑白相间的、记录数据符号信息的图形;

2601_96189646的博客 201

毕业设计 毕设分享 深度学习yolo11水果识别系统(源码+论文)

🔥这两年开始毕业设计和毕业答辩的要求和难度不断提升,传统的毕设题目缺少创新和亮点,往往达不到毕业答辩的要求,这两年不断有学弟学妹告诉学长自己做的项目系统达不到老师的要求。并且很难找到完整的毕设参考学习资料。 为了大家能够顺利以及最少的精力通过毕设,学长分享优质毕业设计项目提供大家参考学习,今天要分享的是 🚩 **毕业设计 毕设分享 深度学习yolo11水果识别系统(源码+论文)** 🥇学长这里给一个题目综合评分(每项满分5分) 难度系数:3分 工作量:4分 创新点:5分

HUXINY的博客 1487

毕业设计 深度学习yolo11水稻病害检测识别系统(源码+论文)

本文介绍了一种基于YOLOv11深度学习模型的水稻病害智能检测系统。针对传统检测方法效率低、精度不足的问题,该系统采用改进的YOLOv11算法,结合PyQt5框架构建了完整的GUI应用。系统能够实时识别稻瘟病、纹枯病等主要水稻病害,准确率达92.3%,检测速度达45FPS。创新点包括首次将YOLOv11应用于农业病害检测、改进NMS算法提升重叠病变识别率等。实验表明,该系统相比传统方法在复杂田间环境下具有更强的鲁棒性,可为农业生产提供高效的病害诊断工具,助力智慧农业发展。

knooor的博客 1010

基于 YOLOv8 与 VisDrone 数据集的无人机目标检测跟踪识别系统​ 深度学习 PySide界面设计 大数据 毕业设计✅

基于 YOLOv8 与 VisDrone 数据集的无人机目标检测跟踪识别系统​ 深度学习 PySide界面设计 大数据 毕业设计✅

vx_biyesheji0001的博客 988
上一篇: 毕业设计- 基于深度学习的小样本时间序列预测算法 - Attention
下一篇: 【毕设选题指导】2024 数据分析与挖掘方向毕业设计选题推荐
Mini_hailang_IT
博客等级 码龄9年 5936粉丝 640原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值