


机器学习经典赛题:工业蒸汽量预测(4)
机器学习经典赛题:工业蒸汽量预测(4):模型验证(模型评估与调参)
5.1 模型评估的概念和方法
5.1.1 欠拟合与过拟合
数据关系是样本的分布规律,或者是特征与对应样本之间的关系。当一个模型恰到好处地表达了数据关系时,认为这个模型拟合效果好。欠拟合(underfitting)也叫高偏差(bias),是指算法所训练的模型不能完整地表达数据关系。在这种情况下,一般可通过增加额外的特征、增加多项式特征、减少
λ
\lambda
λ的值等方法来优化模型。过拟合(overfitting)也叫高方差(variance),指的是算法所训练的模型过多地表达了数据关系,此时很有可能表达的是数据间的噪声关系。在这种情况下,一般可通过收集更多的数据、使用更少的特征、增加
λ
\lambda
λ的值等方法来优化模型。
举例:
# 首先生成一个数据集并可视化
np.random.seed(2012)
x = np.random.uniform(-3.0, 3.0, size=100)
X = x.reshape(-1, 1)
y = 0.5 * x ** 2 + x + np.random.normal(0, 1, size=100)

plt.scatter(x, y)
plt.show()
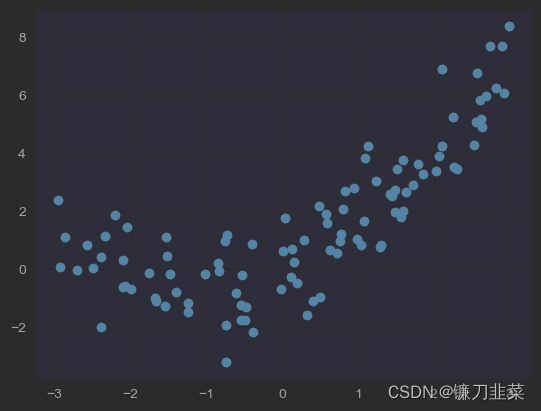
首先,使用线性回归模型对数据进行拟合
from sklearn.linear_model import LinearRegression
lin_reg = LinearRegression()
lin_reg.fit(X, y)
lin_reg.score(X,y)
# 0.5632635759258182
显然,直线拟合数据程度比较低。考虑使用均方误差作为指标来评价拟合程度,代码如下:
from sklearn.metrics import mean_squared_error
y_predict = lin_reg.predict(X)
mean_squared_error(y, y_predict)
# 2.6840905248259093
绘制拟合结果,观察拟合情况:
y_predict = lin_reg.predict(X)
plt.scatter(x, y)
plt.plot(np.sort(x),y_predict[np.argsort(x)],color='r')
plt.show()
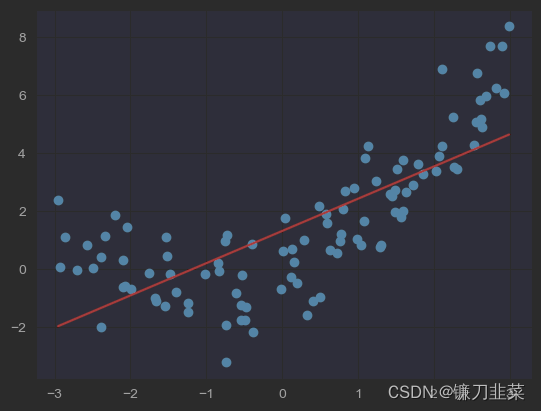
下面使用多项式回归拟合,首先封装Pipeline管道,便于下一步灵活调整多项式回归模型参数。代码如下:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import PolynomialFeatures
from sklearn.preprocessing import StandardScaler

def PolynomialRegression(degree):
    return Pipeline([('poly',PolynomialFeatures(degree=degree)),
                     ('std_scaler',StandardScaler()),
                     ('lin_reg',LinearRegression())])
#%%
poly2_reg = PolynomialRegression(degree=3)
poly2_reg.fit(X, y=y)
y2_predict = poly2_reg.predict(X)
# 比较真实值和预测值的均方误差
mean_squared_error(y, y2_predict)
# 1.116721965068975
讲模型拟合结果可视化显示,如下所示:
plt.scatter(x, y)
plt.plot(np.sort(x), y2_predict[np.argsort(x)],color='r')
plt.show()
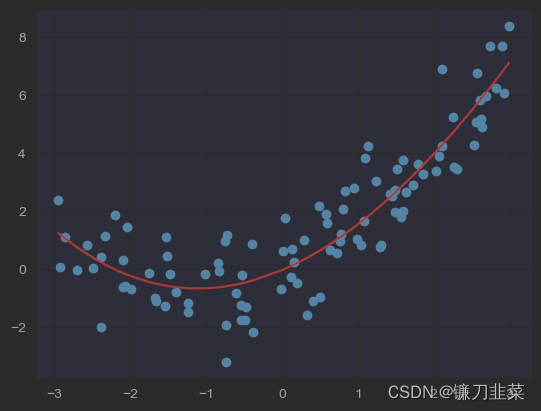
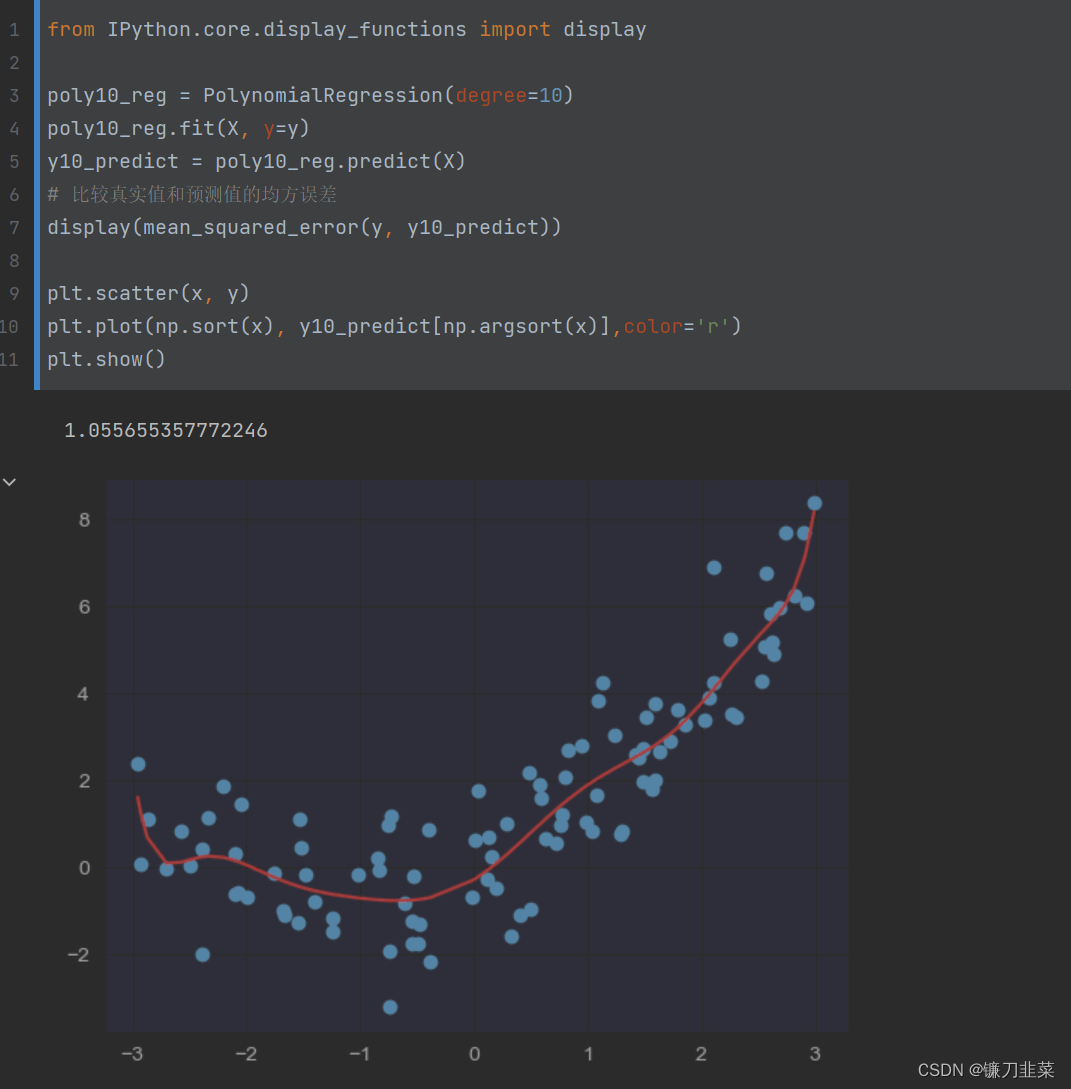
调整多项式参数为degree=10,进行预测:
调整多项式参数为degree=100,进行预测:
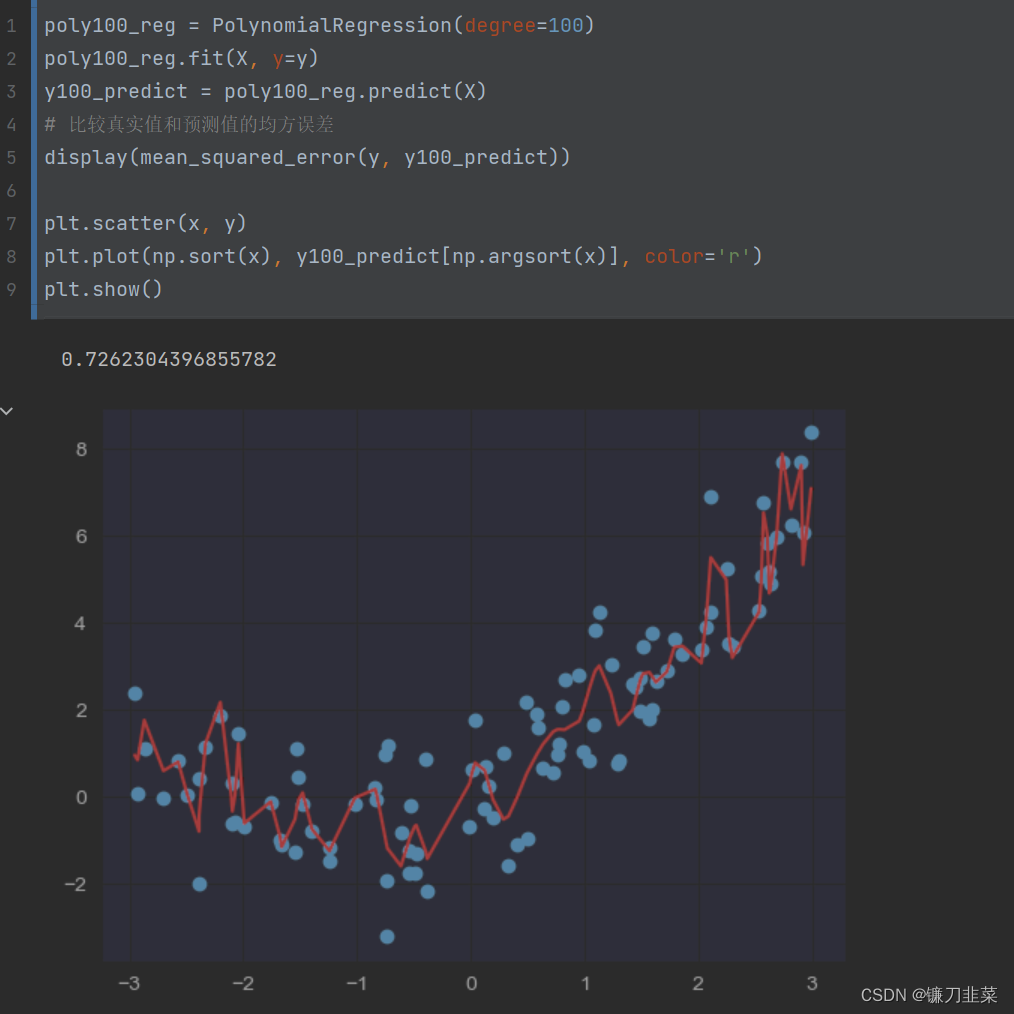
显然,在训练数据集上,随着degree的增加,拟合效果越来越好,MSE的值越来越小,因为样本点是一定的,总能找到一条曲线将所有的样本点拟合;但是曲线并不是所计算出的拟合曲线,只是原有的数据点对应的y的预测值连接出来的结果,而且有的地方没有数据点,因此连接的结果和原来的曲线不一致。在待预测数据的预测过程中,过度拟合训练集会造成泛化能力的降低,预测偏差增大。
5.1.2 模型的泛化与正则化
- 泛化和正则化的概念
泛化是指机器学习模型学习到的概念在处理训练过程中未遇到的样本的表现,即模型处理新样本的能力。
正则化(Regularization是给需要训练的目标函数加上一些规则(限制),目的是为了防止过拟合。(在统计领域中,正则化也称作压缩估计),正则化的主要目的是通过特征选择即对回归函数的系数进行约束,显著降低模型方差,最终降低测试误差。具体说,就是将回归系数往零的方向压缩,这也就是为什么叫压缩估计的原因。
正则化的种类:
L
1
L1
L1,
L
2
L2
L2正则化(L1,L2Regularization)使用的正则化项分别是L1范数、L2范数,其中:
-
L
1
L1
L1范数,公式为
∣
∣
x
∣
∣
1
=
∑
i
=
1
n
∣
x
i
∣
||x||_1 = \sum^n_{i=1}{|x_i|}
∣∣x∣∣1=∑i=1n∣xi∣,即向量元素的绝对值之和。
-
L
2
L2
L2范数,公式为
∣
∣
x
2
∣
∣
=
(
∑
i
=
1
n
∣
x
i
∣
2
)
1
2
||x_2||=(\sum^n_{i=1}{|x_i|^2})^\frac{1}{2}
∣∣x2∣∣=(∑i=1n∣xi∣2)21,又称为欧几里得(Euclid)范数,即向量元素绝对值平方和再进行开方。
-
L
−
q
L-q
L−q范数,公式为
∣
∣
x
∣
∣
q
=
(
∑
i
=
1
n
∣
x
i
∣
q
)
1
q
||x||_q = (\sum_{i=1}^n{|x_i|}^q)^\frac{1}{q}
∣∣x∣∣q=(∑i=1n∣xi∣q)q1,即向量元素绝对值的
q
q
q次幂的累加和再
1
q
\frac{1}{q}
q1次幂。
上述公式中,
n
n
n为模型的阶次,即模型有几个变量(对应数据有几个维度)
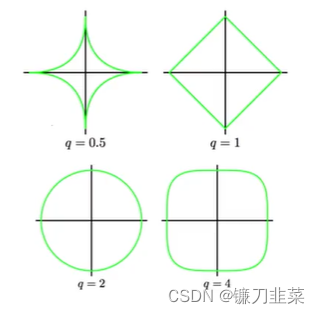
下图为二维优化变量范围,
q
q
q的值越小,曲线越贴近坐标轴,反之,
q
q
q的值越大,曲线越远离坐标轴。
**加入正则化项后的代价函数(cost function)**为:
J
(
w
)
=
1
2
∑
j
=
1
N
{
y
i
−
w
T
σ
(
x
j
)
}
2
+
λ
2
∑
j
=
1
N
∣
w
j
∣
q
J(w)=\frac{1}{2}\sum_{j=1}^N \{y_i-w^T\sigma(x_j)\}^2+\frac{\lambda}{2}\sum_{j=1}^N|w_j|_q
J(w)=21j=1∑N{yi−wTσ(xj)}2+2λj=1∑N∣wj∣q
其中
q
=
2
q=2
q=2为L2正则化,
q
=
1
q=1
q=1为L1正则化,也可以表述为下列简化形式:
- L2正则化: J = J 0 + α ∑ w 2 J=J_0+\alpha\sum w^2 J=J0+α∑w2
- L1正则化: J = J 0 + α ∑ ∣ w 1 ∣ J=J_0+\alpha\sum |w^1| J=J0+α∑∣w1∣
参数空间L2正则化和参数空间L1正则化的示意图如下:
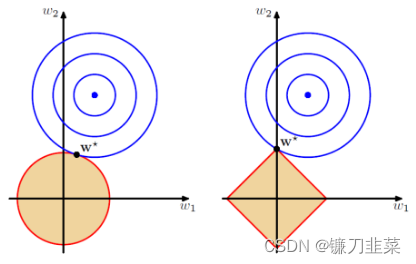
蓝色的圆圈表示没有经过限制的损失函数在寻找最小值过程中,
w
w
w的不断迭代的变化情况,表示的方法是等高线。蓝线和红线的交点
w
∗
w^*
w∗是最小值取到的点。
- 岭回归和LASSO回归
(1)对参数空间进行 L 2 L2 L2范数正则化的线性模型称为岭回归(Ridge Regression):
J ( w ) = ∑ i = 1 N ( y i − w 0 − ∑ j = 1 p w j x i j ) 2 + λ ∑ j = 1 p w j 2 ,其中 λ > = 0 J(w)=\sum_{i=1}^N(y_i-w_0-\sum_{j=1}^p{w_jx_{ij}})^2+\lambda\sum_{j=1}^p{w_j}^2 ,其中\lambda>=0 J(w)=i=1∑N(yi−w0−j=1∑pwjxij)2+λj=1∑pwj2,其中λ>=0
sklearn中岭回归的代码为:
sklearn.linear_model.ridge_regression(X, y, alpha, *, sample_weight=None, solver=‘auto’, max_iter=None, tol=0.001, verbose=0, random_state=None, return_n_iter=False, return_intercept=False, check_input=True)
参数列表:
- alpha:较大的值表示更强的正则化。浮点数
- sample_weight:样本权重,默认无。
- solver:求解方法,{‘auto’, ‘svd’, ‘cholesky’, ‘lsqr’, ‘sparse_cg’, ‘sag’, ‘saga’}, 默认=’auto’。
- 'svd’使用X的奇异值分解来计算Ridge系数。
- 'cholesky’使用标准的scipy.linalg.solve函数通过dot(XT,X)的Cholesky分解获得封闭形式的解。
- 'sparse_cg’使用scipy.sparse.linalg.cg中的共轭梯度求解器。作为一种迭代算法,对于大规模数据(可能设置tol和max_iter),此求解器比“ Cholesky”更合适。
- 'lsqr’使用专用的正则化最小二乘例程scipy.sparse.linalg.lsqr。它是最快的,并且使用迭代过程。
- 'sag’使用随机平均梯度下降。
- ‘saga’使用其改进的无偏版本SAGA。两种方法都使用迭代过程,并且当n_samples和n_features都很大时,通常比其他求解器更快。请注意,只有在比例大致相同的要素上才能确保‘sag’和‘saga’快速收敛。您可以使用sklearn.preprocessing中的缩放器对数据进行预处理。最后五个求解器均支持密集和稀疏数据。但是,当fit_intercept为True时,仅’sag’和’sparse_cg’支持稀疏输入。
from sklearn import linear_model
reg_rid = linear_model.Ridge(alpha=.5)
reg_rid.fit(X,y)
reg_rid.score(X,y)
(2)对参数空间进行
L
1
L1
L1范数正则化的线性模型称为LASSO回归(LASSO Regression)。
J
(
w
)
=
∑
i
=
1
N
(
y
i
−
w
0
−
∑
j
=
1
p
w
j
x
i
j
)
2
+
λ
∑
j
=
1
p
∣
w
j
∣
,其中
λ
>
=
0
J(w)=\sum_{i=1}^N(y_i-w_0-\sum_{j=1}^p{w_jx_{ij}})^2+\lambda\sum_{j=1}^p|w_j| ,其中\lambda>=0
J(w)=i=1∑N(yi−w0−j=1∑pwjxij)2+λj=1∑p∣wj∣,其中λ>=0
sklearn中关于LASSO回归的代码为:
class sklearn.linear_model.Lasso(alpha=1.0, *, fit_intercept=True, normalize=False, precompute=False, copy_X=True, max_iter=1000, tol=0.0001, warm_start=False, positive=False, random_state=None, selection=‘cyclic’)
参数列表:
- alpha:正则化强度,1.0代表标准最小二乘。
- fit_intercept:是否计算模型截距。默认true。
- normalize:是否标准化,默认false。
- positive:是否强制系数为正,默认false。
from sklearn import linear_model
reg_lasso = linear_model.Lasso(alpha = 0.5)
reg_lasso.fit(X,y)
reg_lasso.score(X,y)
岭回归和LASSO回归的不同之处:
1)使用岭回归改进的多项式回归算法,随着
α
\alpha
α的改变,拟合曲线始终是曲线,知道最后变成一条几乎水平的直线;也就是说,在使用岭回归之后,多项式回归算法在模型变量前还是有系数的,因此很难得到一条斜的直线。
2)而使用LASSO回归改进的多项式回归算法,随着
α
\alpha
α的改变,拟合曲线会很快变成一条斜的直线,最后慢慢变成一条几乎水平的直线,即模型更倾向于一条直线。
5.1.3 回归模型的评估指标和调用方法
这里评估指标一般用于对经过训练集训练后的模型来使用的,以各项指标的评估得分来比较模型的性能。因为模型上限后,一般的未知样本的标签是较难得到的。
这里注意要与参数估计中的公式区分开,虽然有些参数估计的公式用到了诸如MSE的方法,但只是方法相同,用处却不一样。
回归模型的评估指标有平均绝对值误差、均方误差、均方根误差、R平方值。
- 平均绝对值误差
平均绝对值误差,也称**L1损失(MAE)**是预测值与真实值之差的绝对值,计算公式如下:
M A E = 1 n ∑ i = 1 n ∣ f i − y i ∣ = 1 n ∑ i = 1 n ∣ e i ∣ MAE = \frac{1}{n}\sum_{i=1}^n{|f_i-y_i|}=\frac{1}{n}\sum_{i=1}^n{|e_i|} MAE=n1i=1∑n∣fi−yi∣=n1i=1∑n∣ei∣
以下是sklearn中调用MAE的示例代码:
from sklearn.metrics import mean_absolute_error
mean_absolute_error(y_test,y_pred)
- 均方误差
均方误差,也称**L2损失(MSE)**是指的参数估计值与参数真实值之差平方的期望值。MSE是衡量平均误差的一种较方便的方法,可以用来评价数据的变化程度。MSE的值越小,说明预测模型描述实验数据具有越好的精确度,计算公式如下:
M S E = 1 n ∑ i = 1 n ( o b s e r v e d i − p r e d i c t e d i ) 2 MSE = \frac{1}{n}\sum_{i=1}^n{(observed_i-predicted_i)^2} MSE=n1i=1∑n(observedi−predictedi)2
以下是sklearn中调用MAE的示例代码:
from sklearn.metrics import mean_squared_error
mean_squared_error(y_test,y_pred)
- 均方根误差
均方根误差(RMSE)是MSE的平方根,计算公式如下:
R M S E = M S E = S S E N = 1 N ∑ i = 1 N ( o b s e r v e d i − p r e d i c t e d i ) 2 RMSE =\sqrt{MSE}=\sqrt{\frac{SSE}{N}}= \frac{1}{N}\sum_{i=1}^N{(observed_i-predicted_i)^2} RMSE=MSE=NSSE=N1i=1∑N(observedi−predictedi)2
以下是sklearn中调用RMSE的示例代码:
from sklearn.metrics import mean_squared_error
Pred_Error = mean_squared_error(y_test,y_pred)
Sqrt(Pred_Error)
- R平均值
R平方值(R-Squared)反映了回归模型在多大程度上解释了因变量的变化,或者说模型对观测值的拟合程度如何。计算公式如下:
R 2 ( y , y ^ ) = 1 − ∑ i = 0 n s a m p l e s − 1 ( y i − y i ^ ) 2 ∑ i = 0 n s a m p l e s − 1 ( y i − y i ˉ ) 2 R^2(y,\hat{y})=1-\frac{\sum_{i=0}^{n_{samples}-1}(y_i-\hat{y_i})^2}{\sum_{i=0}^{n_{samples}-1}(y_i-\bar{y_i})^2} R2(y,y^)=1−∑i=0nsamples−1(yi−yiˉ)2∑i=0nsamples−1(yi−yi^)2
以下是sklearn中调用R平方值的示例代码:
from sklearn.metrics import r2_score
r2_score(y_test,y_pred)
补充:
- 均方对数差损失(Mean Squared Log Error,MSLE)
l o s s ( y i ^ , y ) = 1 N ∑ i = 1 N ( l o g y i ^ − l o g y i ) 2 loss(\hat{y_i},y) = \frac{1}{N}\sum_{i=1}^N(log\hat{y_i}-logy_i)^2 loss(yi^,y)=N1i=1∑N(logyi^−logyi)2 - Huber损失(Huber loss)
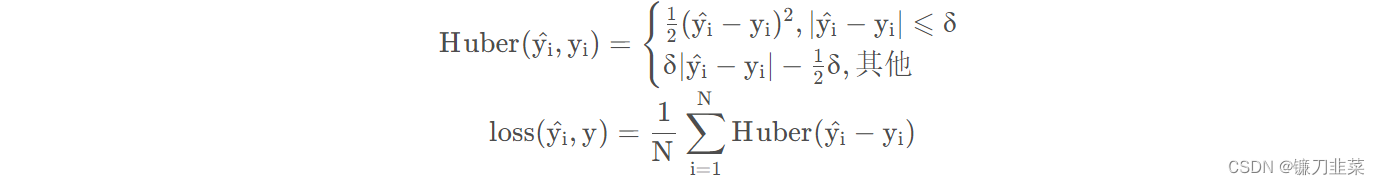
- Log-Cosh损失函数(Log-Cosh loss)
l o s s ( y i ^ , y ) = 1 N ∑ i = 1 N l o g ( c o s h ( y i ^ − y ) ) loss(\hat{y_i},y) = \frac{1}{N}\sum_{i=1}^N{log(cosh(\hat{y_i}-y))} loss(yi^,y)=N1i=1∑Nlog(cosh(yi^−y))
- L2损失是使用最广泛的损失,在优化过程中更为稳定和准确,但是对于局外点敏感。
- L1损失会比较有效地惩罚局外点,但它的导数不连续使得寻找最优解的过程低效。
- Huber损失由L2损失与L1损失合成,当 δ \delta δ趋于0时退化成了L1损失,当 δ \delta δ趋于无穷时则退化为L2损失。 δ \delta δ决定了模型处理局外点的行为,当残差大于 δ \delta δ时使用L1损失,很小时则使用更为合适的L2损失来进行优化。Huber损失函数克服了L1损失和L2损失的缺点,不仅可以保持损失函数具有连续的导数,同时可以利用L2损失梯度随误差减小的特性来得到更精确的最小值,也对局外点具有更好的鲁棒性。但Huber损失函数的良好表现得益于精心训练的超参数 δ \delta δ。
- Log-Cosh损失拥有Huber损失的所有优点,并且在每一个点都是二次可导的,这在很多机器学习模型中是十分必要的。
5.1.4 分类模型的评估指标和调用方法
- Logistic损失(Logistic loss)
- 负对数似然损失(Negative Log Likelihood loss)
- 交叉熵损失(Cross Entropy loss)
Logistic损失用于解决每个类别的二分类问题,为了方便数据集把最大似然转化为负对数似然,而得到负对数似然损失,交叉熵损失从两个类别扩展到M个类别,交叉熵损失在二分类时应当是负对数似然损失。
5.1.5 交叉验证
交叉验证(Cross Validation)是验证分类器性能的一种统计分析方法,其基本思想是在某种意义下将原始数据进行分组,一部分作为训练集,另一部分作为验证集。首先用训练集对分类器进行训练,再利用验证集来测试训练得到的模型,以此来作为评价分类器的性能指标。常用的交叉验证法包括简单交叉验证、K折交叉验证、留一法交叉验证和留P法交叉验证。
- 简单交叉验证
简单交叉验证(Cross Validation)是将原始数据随机分为两组,一组作为训练集,另一组作为验证集,利用训练集训练分类器,然后利用验证集验证模型,将最后的分类准确率作为此分类器的性能指标。通常划分30%的数据作为测试数据。 - K折交叉验证
K折交叉验证(K-Fold Cross Validation),是将原始数据分成K组(一般是均分),然后将每个子集数据分别做一次验证集,其余K-1组子集数据做训练集,这样就会得到K个模型,将K个模型最终的验证集的分类准确率取平均值,作为K折交叉验证分类器的性能指标。通过设置K大于或等于3。
注意:当数据集比较大时,K不能取值过大,例如数据集包含1百万个样本,则需要训练1百万个模型,这还是未考虑算法调参的情况下。
3. 留一法交叉验证
留一法交叉验证(Leave-One-Out Cross Validation,LOO-CV),是指每个训练集由除一个样本之外的其余样本组成,留下的一个样本为验证集。这样,对于N个样本的数据集,最终可以形成N个模型,用N个模型最终的验证集的分类准确率的平均数作为分类器的性能指标。留一法是K折交叉验证,K=N时的特例。
留一法中被实际评估的模型与期望评估的用全部数据集D训练出的模型很相似。因此,留一法的评估结果往往被认为比较准确。但留一法的估计结果未必永远比其他评估方法准确;“没有免费的午餐”NFL定理对实验评估方法同样适用。 ———周志华《机器学习》P27
- 留P法交叉验证
留P法交叉验证(Leave-P-Out Cross Validation,LPO-CV),与留一法交叉验证类似,是从完整的数据集中删除p个样本,产生所有可能的训练集和验证集。对于N个样本,能产生 ( N , p ) (N,p) (N,p)个训练-检验对。也就是每个训练集由除P个样本之外的其余样本组成,留下的P个样本为验证集。
注意:
1)训练/测试集的划分要尽可能保持数据分布的一致性,避免因数据划分过程引入额外的偏差而对最终结果产生影响,例如在分类任务中至少要保持样本的类别比例相似—分层采样(stratified sampling)。
2)即使在给定训练/测试集的样本比例后,仍存在多种划分方式对初始数据集D进行分割。不同的分割将导致不同的训练/测试集,相应的,模型评估的结果也会有所差别。因此在采用留出法时往往采用若干次随机划分、重复进行实验评估后取平均值作为留出法的评估结果。
- 几种交叉验证在sklearn中的调用方法示例代码
(1)简单交叉验证
from sklearn.model_selection import train_test_split
from sklearn.datasets import load_iris

iris = load_iris()
X_train, X_test, y_train, y_test = train_test_split(iris.data, iris.target, test_size=.4, random_state=0)
(2)K折交叉验证
from sklearn.model_selection import KFold
kf = KFold(n_splits=10)
(3)留一法交叉验证
from sklearn.model_selection import LeaveOneOut
loo = LeaveOneOut()
(4)留P法交叉验证
from sklearn.model_selection import LeavePOut
lpo = LeavePOut(p=5)
- 其他交叉验证分割方法
(1)基于类标签,具有分层的交叉验证。
这一类交叉验证方法主要用于解决样本不平衡的问题。
StratifiedKFold是 k-fold 的变种,会返回 stratified(分层) 的折叠:每个小集合中, 各个类别的样例比例大致和完整数据集中相同。使用sklearn.model_selection 中的类StratifiedKFold 。
from sklearn.model_selection import StratifiedKFold
skf = StratifiedKFold(n_splits=3)
for train ,test in skf.split(iris.data,iris.target):
    print("分层k折拆分:%s %s" %(train.shape, test.shape))

#分层k折拆分:(100,) (50,)
#分层k折拆分:(100,) (50,)
#分层k折拆分:(100,) (50,)
StratifiedShuffleSplit是 ShuffleSplit 的一个变种,会返回直接的划分,比如创建一个划分,但是划分中每个类的比例和完整数据集中的相同。
from sklearn.model_selection import StratifiedShuffleSplit
skf = StratifiedShuffleSplit(n_splits=3 ,test_size=0.25, random_state=0)
for train ,test in skf.split(iris.data,iris.target):
    print("分层k折拆分:%s %s" %(train.shape, test.shape))
(2)用于分组数据的交叉验证
这一类交叉验证方法主要用于进一步测试模型的泛化能力。留出一组特定的不属于测试集和训练集的数据。常用的方法包括GroupKFold、LeaveOneGroupOut、LeavePGroupsOut、GroupShuffleSplit。
- GroupKFold是 k-fold 的变体,它确保同一个group在测试和训练集中都不被表示。
- LeaveOneGroupOut是LeaveOneOut的变体,根据用户提供的整数组的数组来区别不同组,以此来提供样本。这个组的信息可以用来编码任意域特定的预定义交叉验证折叠。每个训练集都是由除特定组别意外的所有样本构成的。
- LeavePGroupsOut类似于 LeaveOneGroupOut ,但为每个训练/测试集删除与 P 组有关的样本。
- GroupShuffleSplit迭代器是 ShuffleSplit 和 LeavePGroupsOut 的组合,它生成一个随机划分分区的序列,其中为每个分组提供了一个组子集。
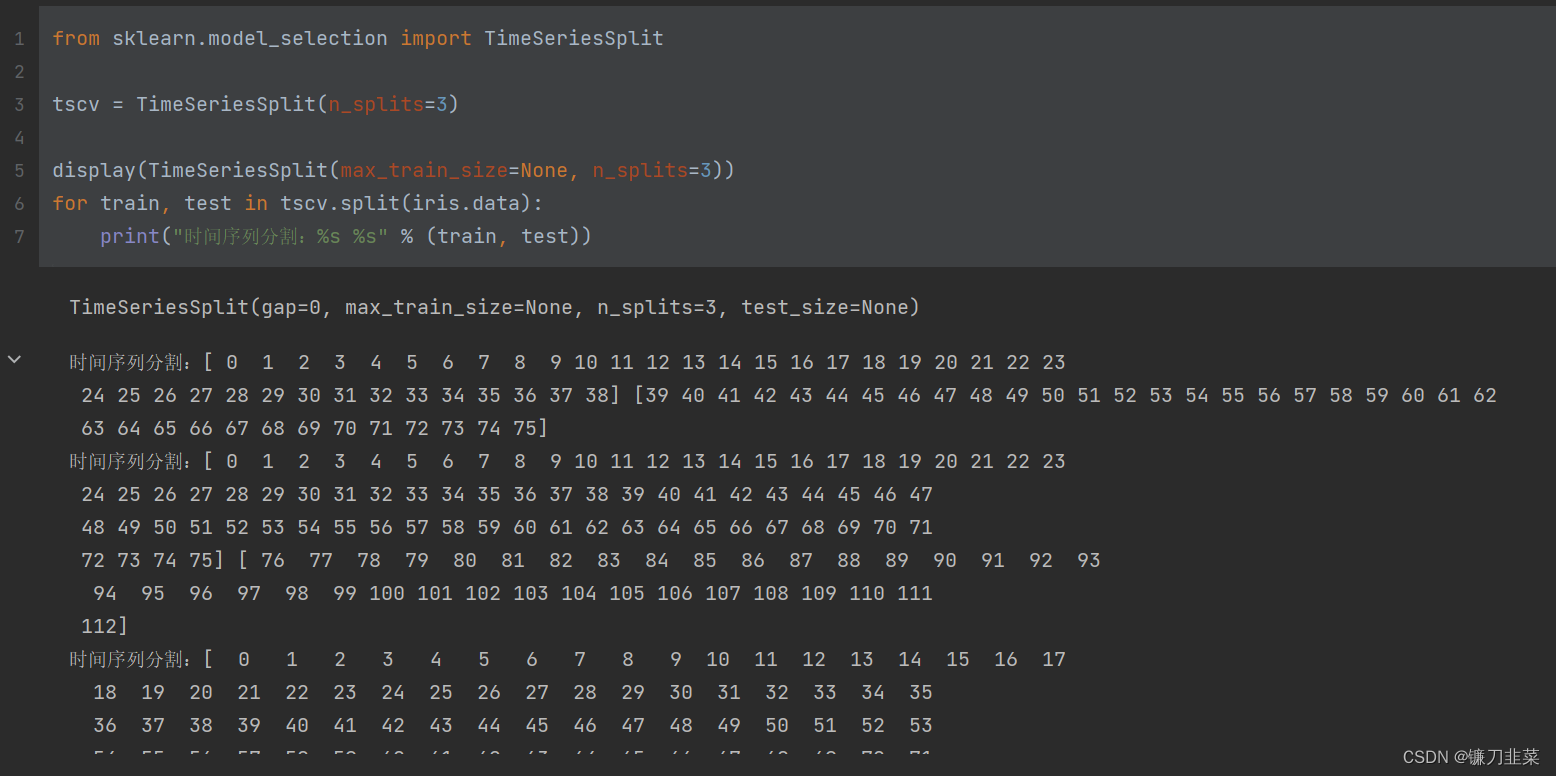
(3)时间序列分割
TimeSeriesSplit是 K-fold 的一个变体,它首先返回 K 折作为训练数据集,并且 (K+1) 折作为测试数据集。 请注意,与标准的交叉验证方法不同,连续的训练集是超越前者的超集,有关时间序列的样本切分必须保证时间上的顺序性,不能用未来的数据去验证现在数据的正确性,只能使用时间上之前一段时间的数据建模,而用后一段时间的数据来验证模型预测的效果。 另外,它将所有的剩余数据添加到第一个训练分区,它总是用来训练模型。
5.2 模型调参
5.2.1 调参
- 调参的目标
调参就是对模型的参数进行调整,以找到使模型性能最优的参数。调参的目标就是达到整体模型的偏差和方差的大和谐!
参数可分为两类:过程影响类参数和子模型影响类参数。具体来说:
- 过程影响类参数就是在子模型不变的前提下,调整“子模型数(n_estimators)”、“学习率(learning_rate)”等参数,改变训练过程,从而提高整体模型的性能。
- 子模型影响类参数就是调整“最大树深度(max_depth)”、“分裂条件(criterion)”等参数,改变子模型的性能,从而提高整体模型的性能。
bagging的训练过程旨在降低方差,而boosting的训练过程旨在降低偏差,过程影响类的参数能够引起整体模型性能的大幅度变化。
- 参数对整体模型性能的影响
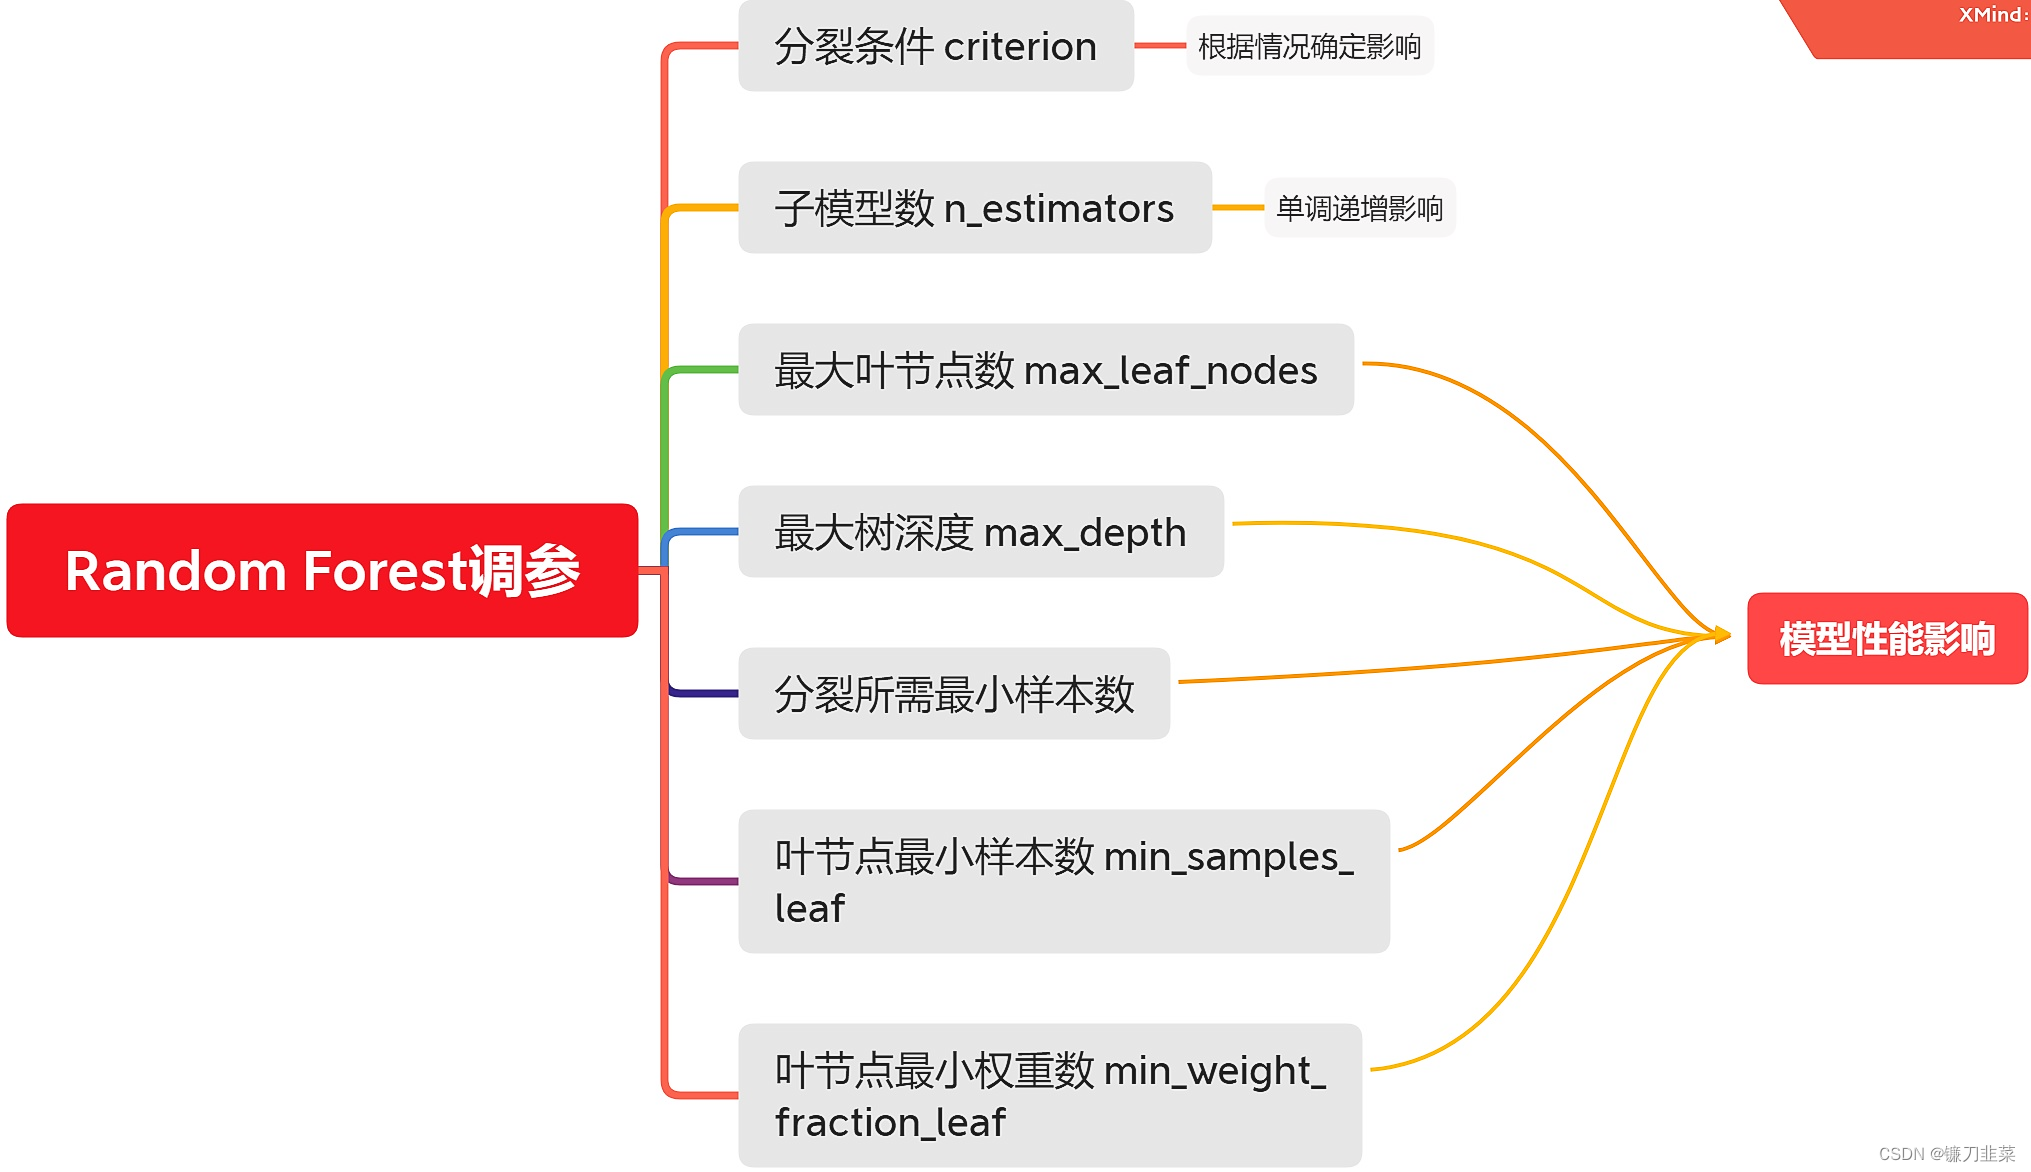
图5.2.1.1 参数对Random Forest的影响
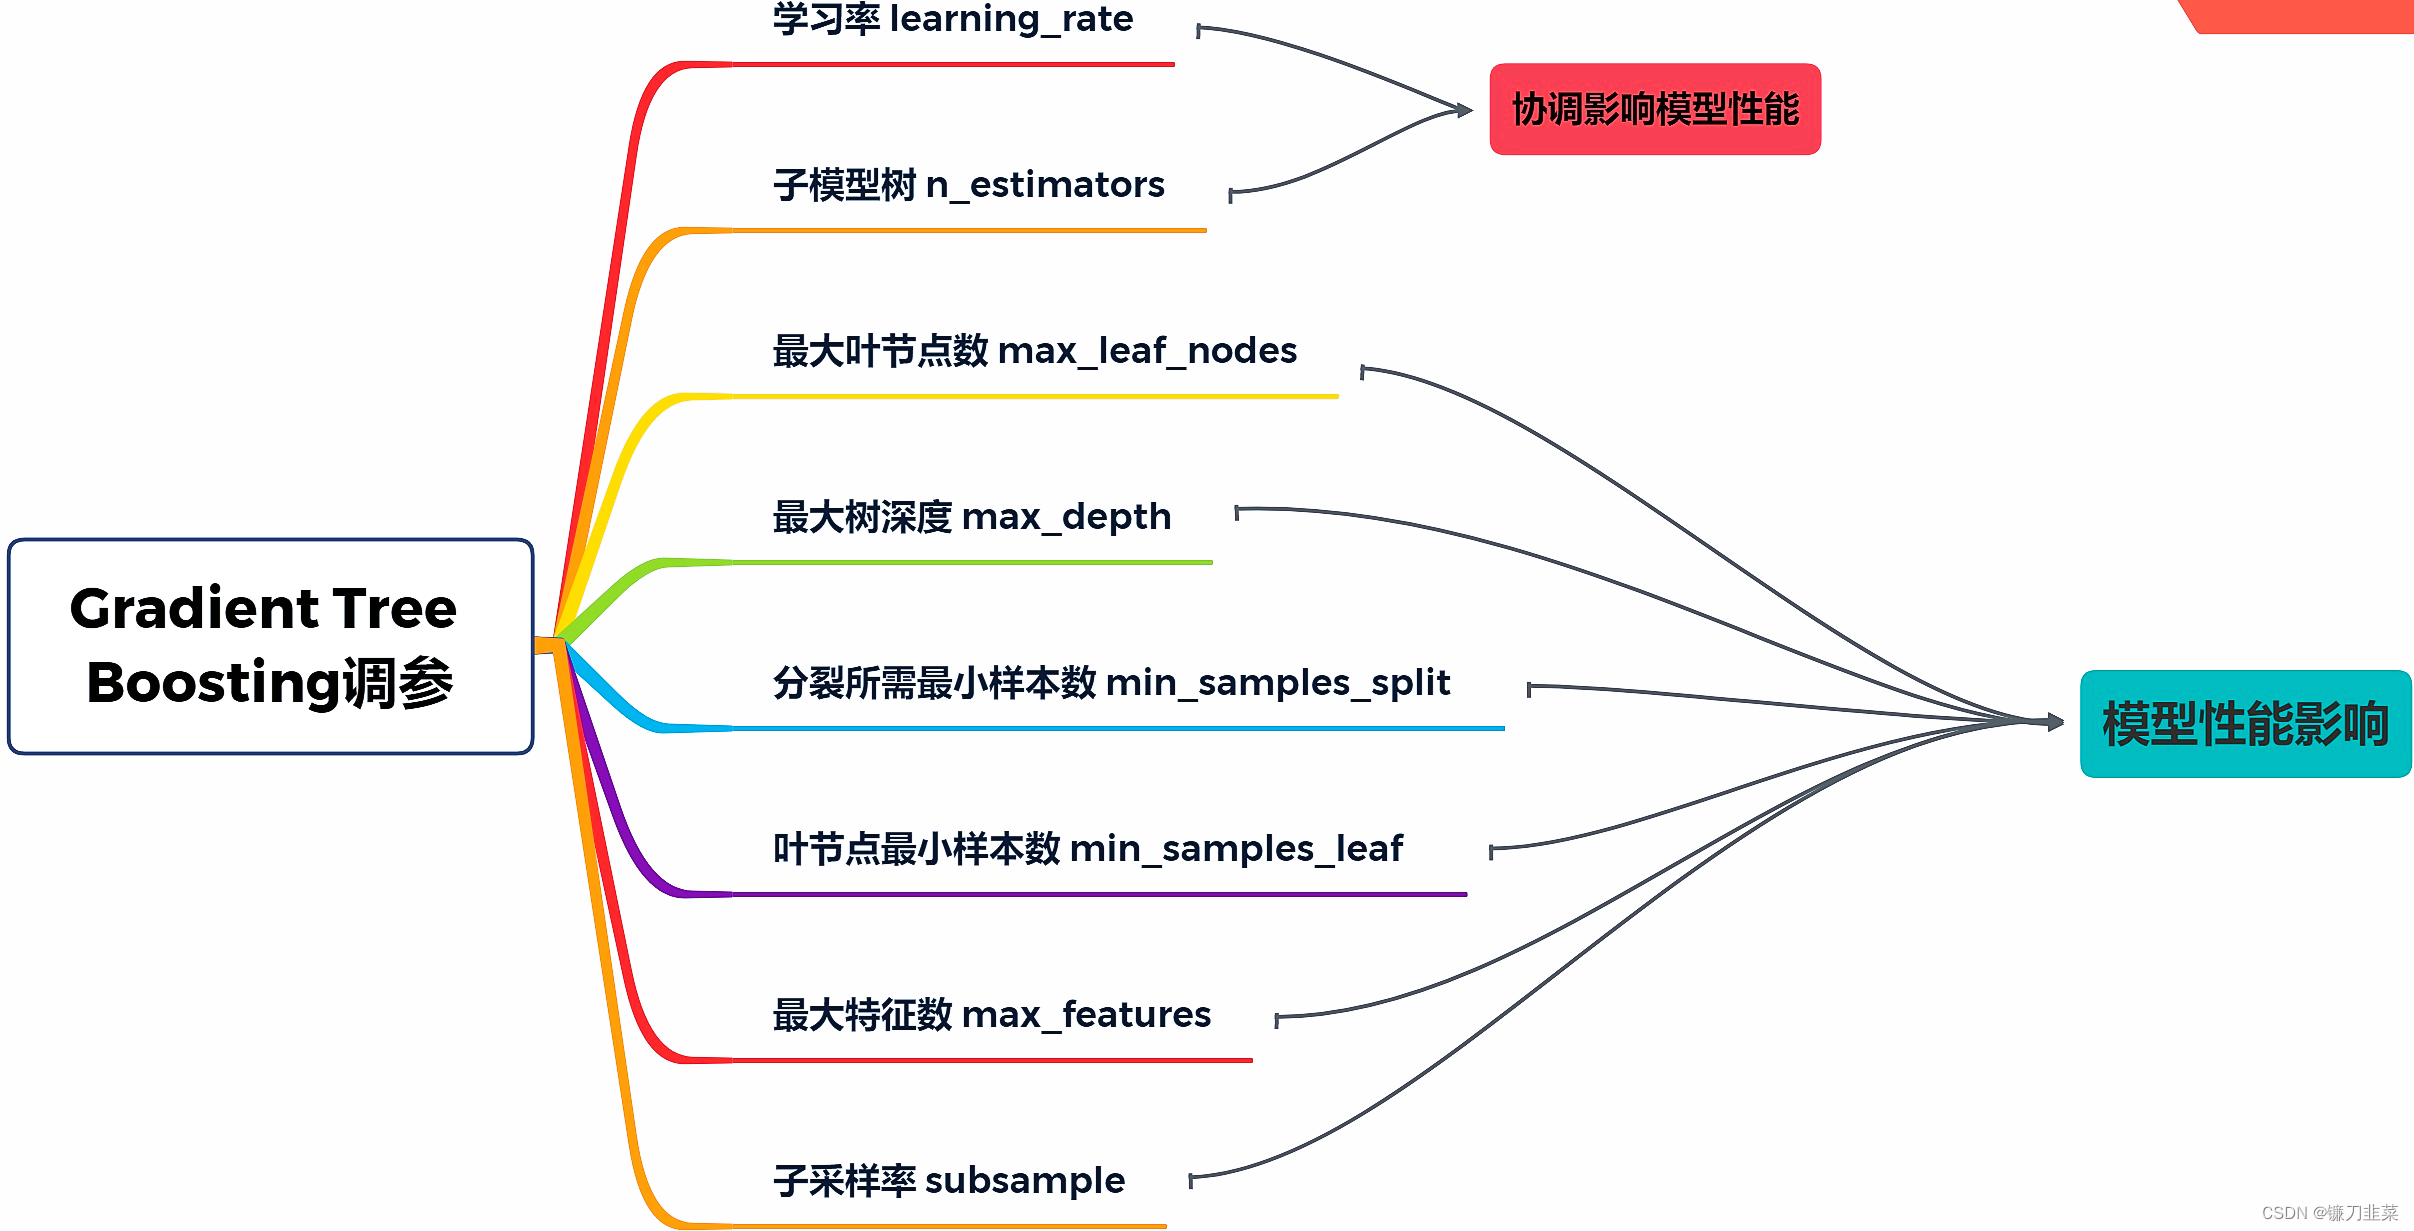
图5.2.1.2 参数对Gradient Tree Boosting的影响
5.2.2 网格搜索
网格搜索(Grid Search)是一种穷举搜索的调参手段。在所有候选的参数选择中,通过循环遍历,尝试每一种可能性,表现最好的参数就是最终的结果。其原理就像是在数组中找最大值。以有两个参数的模型为例,参数a有三种可能,参数b有4种可能,把所有可能性列出来,可以表示成一个3*4的表格,其中每个单元就是一个网格,循环过程就像是在每个网格中遍历、搜索,因此得名网格搜索。
下面是一个简单的网格搜索示例,应用iris数据集,对SVC模型参数做一次网格搜索调参。
| C=0.001 | C=0.01 | … | C=10 | |
|---|---|---|---|---|
| grmma=0.001 | SVC(C=0.001,grmma=0.001) | SVC(C=0.01,grmma=0.001) | … | SVC(C=10,grmma=0.001) |
| grmma=0.01 | SVC(C=0.001,grmma=0.01) | SVC(C=0.01,grmma=0.01) | … | SVC(C=10,grmma=0.01) |
| … | … | … | … | … |
| grmma=100 | SVC(C=0.001,grmma=100) | SVC(C=0.01,grmma=100) | … | SVC(C=10,grmma=100) |
具体的代码和调参结果如下:
from sklearn.datasets import load_iris
from sklearn.svm import SVC
from sklearn.model_selection import train_test_split
import numpy as np

iris = load_iris()
X_train, X_test, y_train, y_test = train_test_split(iris.data, iris.target, random_state=0)
print("Size if training set:{} size of testing size:{}".format(X_train.shape[0], X_test.shape[0]))  #total number 150

'''
C:正则化参数。正则化的强度与C成反比。必须严格为正。惩罚是平方的l2惩罚。
kernel:{'linear','poly','rbf','sigmoid','precomputed'},默认='rbf'
degree:多项式和的阶数
gamma:“ rbf”,“ poly”和“ Sigmoid”的内核系数。
shrinking:是否软间隔分类,默认true
'''

# grid search start
best_score = 0
for gamma in [0.001, 0.01, 0.1, 1, 10, 100]:
    for C in [0.001, 0.01, 0.1, 1, 10, 100]:
        svm = SVC(gamma=gamma, C=C)  #对于每种参数的可能组合,都进行一次训练
        svm.fit(X_train, y_train)
        score = svm.score(X_test, y_test)
        if score > best_score:
            best_score = score
            best_parameters = {'gamma': gamma, 'C': C}
# grid search end
print("Best score:{:.2f}".format(best_score))
print("Best parameters:{}".format(best_parameters))
运行结果:
Size if training set:112 size of testing size:38
Best score:0.97
Best parameters:{'gamma': 0.001, 'C': 100}
5.2.3 随机搜索
网格搜索相当于暴力地从参数空间中每个都尝试一遍,然后选择最优的那组参数,这样的方法显然是不够高效的,因为随着参数类别个数的增加,需要尝试的次数呈指数级增长。有没有一种更加高效的调优方式呢?那就是使用随机搜索的方式,这种方式不仅仅高效,而且实验证明,随机搜索法结果比稀疏化网格法稍好(有时候也会极差,需要权衡)。参数的随机搜索中的每个参数都是从可能的参数值的分布中采样的。与网格搜索相比,这有两个主要优点:
- 可以独立于参数数量和可能的值来选择计算成本。
- 添加不影响性能的参数不会降低效率。
调参实例
首先,对未调参的SVR进行评价:
rom sklearn.svm import SVR  # 引入SVR类
from sklearn.pipeline import make_pipeline  # 引入管道简化学习流程
from sklearn.preprocessing import StandardScaler  # 由于SVR基于距离计算,引入对数据进行标准化的类
from sklearn.model_selection import GridSearchCV  # 引入网格搜索调优
from sklearn.model_selection import cross_val_score  # 引入K折交叉验证
from sklearn import datasets

boston = datasets.load_boston()  # 返回一个类似于字典的类
X = boston.data
y = boston.target
features = boston.feature_names
pipe_SVR = make_pipeline(StandardScaler(), SVR())
score1 = cross_val_score(estimator=pipe_SVR, X=X, y=y, scoring='r2', cv=10)  # 10折交叉验证
print("CV accuracy: %.3f +/- %.3f" % ((np.mean(score1)), np.std(score1)))
输出:CV accuracy: 0.187 +/- 0.649
交叉验证经常与网格搜索进行结合,作为参数评价的一种方法,这种方法叫做grid search with cross validation。sklearn因此设计了一个这样的类GridSearchCV,这个类实现了fit,predict,score等方法,被当做了一个estimator,使用fit方法,该过程中:(1)搜索到最佳参数;(2)实例化了一个最佳参数的estimator;
然后,使用网格搜索来对SVR调参:
from sklearn.pipeline import Pipeline

pipe_svr = Pipeline([("StandardScaler", StandardScaler()),
                     ("svr", SVR())])
param_range = [0.0001, 0.001, 0.01, 0.1, 1.0, 10.0, 100.0, 1000.0]
param_grid = [{"svr__C": param_range, "svr__kernel": ["linear"]},  # 注意__是指两个下划线,一个下划线会报错的
              {"svr__C": param_range, "svr__gamma": param_range, "svr__kernel": ["rbf"]}]
gs = GridSearchCV(estimator=pipe_svr, param_grid=param_grid, scoring='r2', cv=10)  # 10折交叉验证
gs = gs.fit(X, y)
print("网格搜索最优得分:", gs.best_score_)
print("网格搜索最优参数组合:\n", gs.best_params_)
输出:
网格搜索最优得分: 0.6081303070817479
网格搜索最优参数组合:
 {'svr__C': 1000.0, 'svr__gamma': 0.001, 'svr__kernel': 'rbf'}
最后,使用随机搜索来对SVR调参:
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import uniform  # 引入均匀分布设置参数

pipe_svr = Pipeline([("StandardScaler", StandardScaler()),
                     ("svr", SVR())])
distributions = dict(svr__C=uniform(loc=1.0, scale=4),  # 构建连续参数的分布
                     svr__kernel=["linear", "rbf"],  # 离散参数的集合
                     svr__gamma=uniform(loc=0, scale=4))

rs = RandomizedSearchCV(estimator=pipe_svr,
                        param_distributions=distributions,
                        scoring='r2',
                        cv=10)  # 10折交叉验证
rs = rs.fit(X, y)
print("随机搜索最优得分:", rs.best_score_)
print("随机搜索最优参数组合:\n", rs.best_params_)
输出:
随机搜索最优得分: 0.3013294958679655
随机搜索最优参数组合:
 {'svr__C': 1.3542346449631775, 'svr__gamma': 0.8362549744047394, 'svr__kernel': 'linear'}
5.2.4 学习曲线
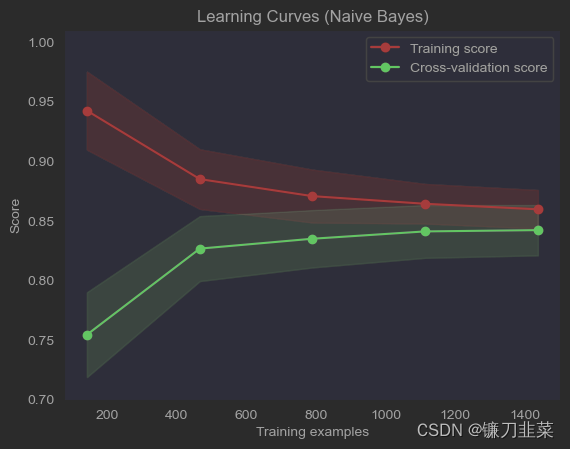
学习曲线是在训练集大小不同时,通过绘制模型训练集和交叉验证集上的准确率来观察模型在新数据上的表现,进而判断模型的方差或偏差是否过高,以及增大训练集是否可以减小过拟合。
模型欠拟合、过拟合、偏差和方差平衡 时对应的学习曲线如下图所示:
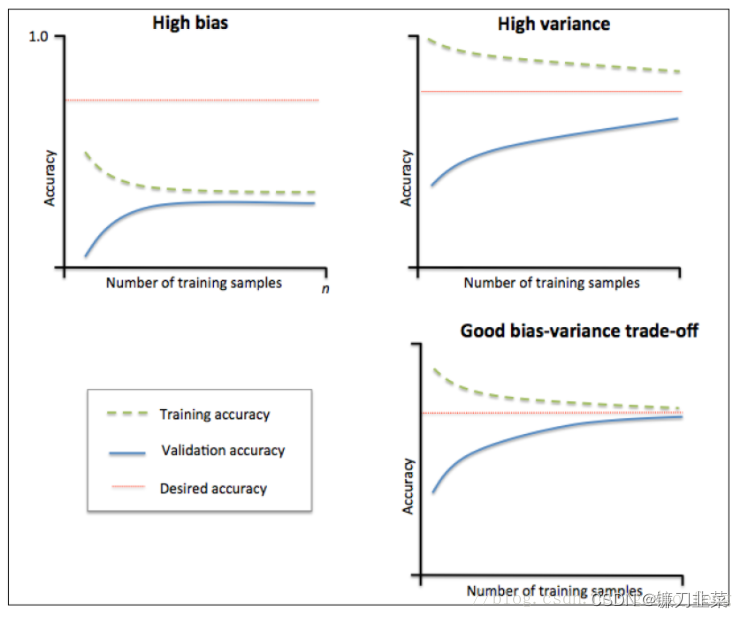
图5.2.4.1 学习曲线示意图
左上角的图中训练集和验证集上的曲线能够收敛。在训练集合验证集上准确率相差不大,却都很差。这说明模拟对已知数据和未知都不能进行准确的预测,属于高偏差。这种情况模型很可能是欠拟合。可以针对欠拟合采取对应的措施。
右上角的图中模型在训练集上和验证集上的准确率差距很大。说明模型能够很好的拟合已知数据,但是泛化能力很差,属于高方差。模拟很可能过拟合,要采取过拟合对应的措施。
学习曲线的代码如下:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.naive_bayes import GaussianNB
from sklearn.svm import SVC
from sklearn.datasets import load_digits
from sklearn.model_selection import learning_curve
from sklearn.model_selection import ShuffleSplit


def plot_learning_curve(estimator, title, X, y, ylim=None, cv=None,
                        n_jobs=1, train_sizes=np.linspace(.1, 1.0, 5)):
    """
    画出data在某模型上的learning curve.
    参数解释
    ----------
    estimator : 你用的分类器。
    title : 表格的标题。
    X : 输入的feature,numpy类型
    y : 输入的target vector
    ylim : tuple格式的(ymin, ymax), 设定图像中纵坐标的最低点和最高点
    cv : 做cross-validation的时候,数据分成的份数,其中一份作为cv集,其余n-1份作为training(默认为3份)
    n_jobs : 并行的的任务数(默认1)
    """
    plt.figure()
    plt.title(title)
    if ylim is not None:
        plt.ylim(*ylim)
    plt.xlabel("Training examples")
    plt.ylabel("Score")
    train_sizes, train_scores, test_scores = learning_curve(
        estimator, X, y, cv=cv, n_jobs=n_jobs, train_sizes=train_sizes)
    train_scores_mean = np.mean(train_scores, axis=1)
    train_scores_std = np.std(train_scores, axis=1)
    test_scores_mean = np.mean(test_scores, axis=1)
    test_scores_std = np.std(test_scores, axis=1)
    plt.grid()

    plt.fill_between(train_sizes, train_scores_mean - train_scores_std,
                     train_scores_mean + train_scores_std, alpha=0.1,
                     color="r")
    plt.fill_between(train_sizes, test_scores_mean - test_scores_std,
                     test_scores_mean + test_scores_std, alpha=0.1, color="g")
    plt.plot(train_sizes, train_scores_mean, 'o-', color="r",
             label="Training score")
    plt.plot(train_sizes, test_scores_mean, 'o-', color="g",
             label="Cross-validation score")

    plt.legend(loc="best")
    plt.draw()
    plt.show()

    midpoint = ((train_scores_mean[-1] + train_scores_std[-1]) + (test_scores_mean[-1] - test_scores_std[-1])) / 2
    diff = (train_scores_mean[-1] + train_scores_std[-1]) - (test_scores_mean[-1] - test_scores_std[-1])
    return midpoint, diff


digits = load_digits()
X, y = digits.data, digits.target

title = "Learning Curves (Naive Bayes)"
# Cross validation with 100 iterations to get smoother mean test and train
# score curves, each time with 20% data randomly selected as a validation set.
cv = ShuffleSplit(n_splits=100, test_size=0.2, random_state=0)

estimator = GaussianNB()
plot_learning_curve(estimator, title, X, y, ylim=(0.7, 1.01), cv=cv, n_jobs=4)

title = "Learning Curves (SVM, RBF kernel, $\gamma=0.001$)"
# SVC is more expensive so we do a lower number of CV iterations:
cv = ShuffleSplit(n_splits=10, test_size=0.2, random_state=0)
estimator = SVC(gamma=0.001)
plot_learning_curve(estimator, title, X, y, (0.7, 1.01), cv=cv, n_jobs=4)
5.2.5 验证曲线
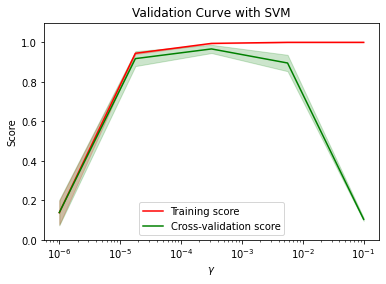
和学习曲线不同,验证曲线的横轴为某一个超参数的一系列值,由此比较不同参数设置下(而非不同训练集大小)模型的准确率。
参考资料
[1] 《阿里云天池大赛赛题解析——机器学习篇》
[2] 机器学习交叉验证的数据分割算法
[3] 学习曲线(learning curve)来判断模型状态:过拟合欠拟合

 1579


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


