李宏毅老师课程:Semi-supervised

李宏毅—1天搞懂深度学习(ppt,pdf以及精心整理的目录) Deep Learning Tutorial——李宏毅Hung-yi Lee, 李宏毅—1天搞懂深度学习的ppt,pdf以及精心整理的目录。 立即下载

Introduction

在这里插入图片描述
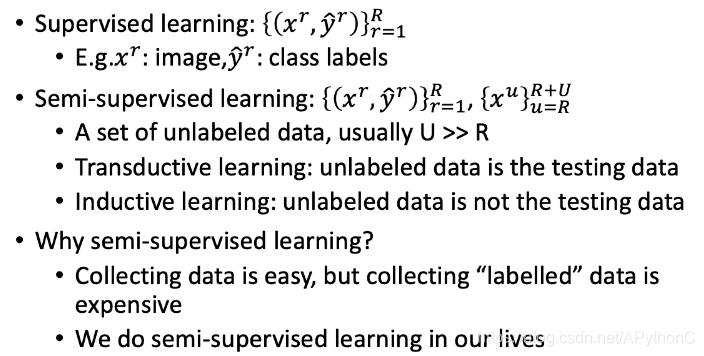
对于猫狗分类问题,如果只有一部分data有label,还有其他很大一部分data是unlabeled,那么我们可以认为unlabeled data对我们网络的训练是无用的吗?
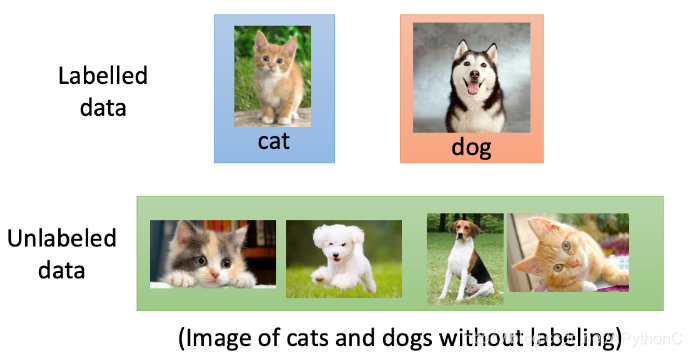
在这里插入图片描述
Q:Why semi-supervised learning helps ?
(为什么semi-supervised learning会有效?)
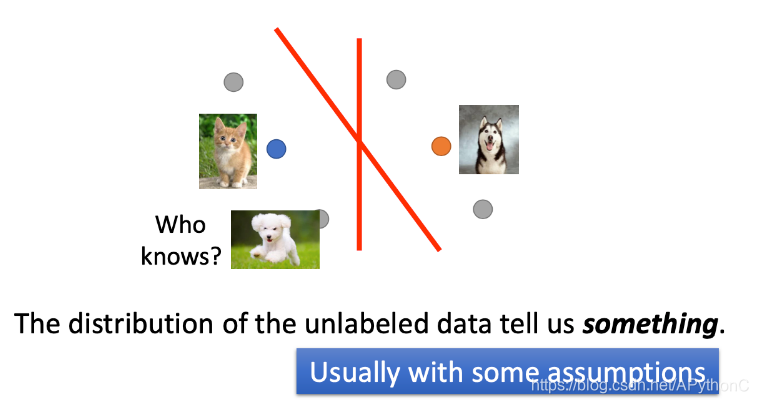
在这里插入图片描述
A:如图所示,图中灰色圆点表示unlabeled data,其他圆点表示labeled data。如果没有unlabeled data,此时可以用一条竖直的线将猫狗进行分类,boundary为竖直的那条线;但unlabeled data的分布也可以告诉我们一些信息,对我们的训练也是有帮助的,有了unlabeled data,此时的boundary为斜直线

Semi-supervised Learning for Generative Model

Supervised Generative Model

不考虑unlabeled data,只有labeled data
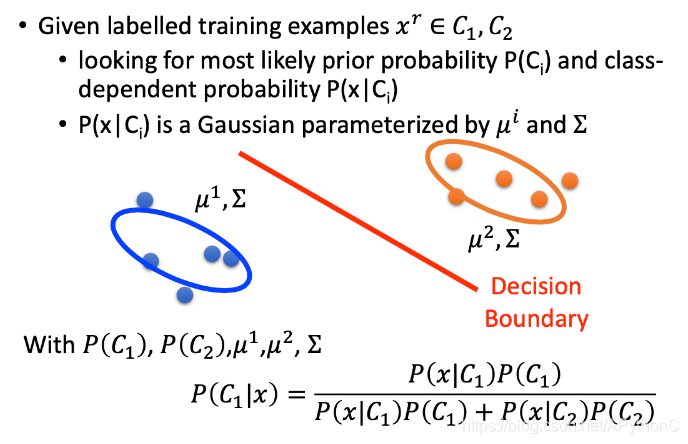
在这里插入图片描述

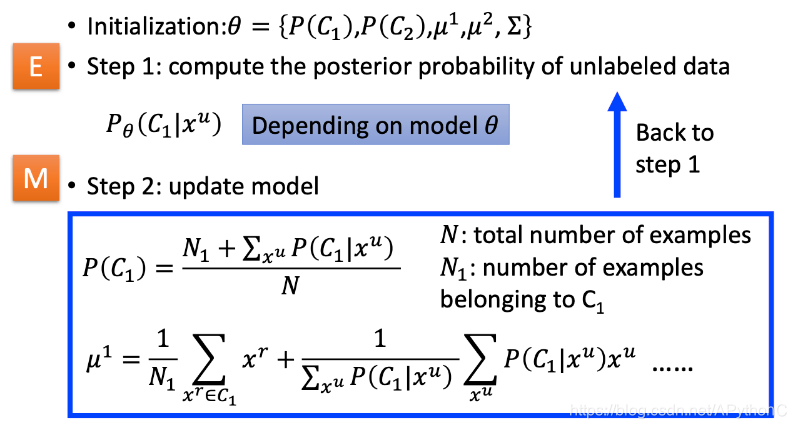
Semi-supervised Generative Model

如果把unlabeled data也考虑进来,此时的boundary 也发生了变化
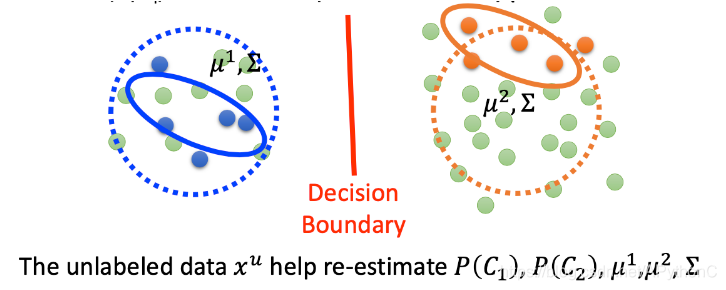
在这里插入图片描述

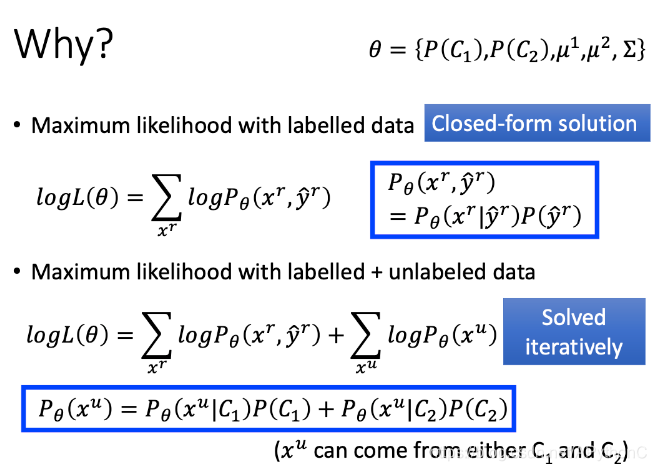
Formulation

在这里插入图片描述
不同的maximum likelihood对比
在这里插入图片描述

Low-density Separation Assumption

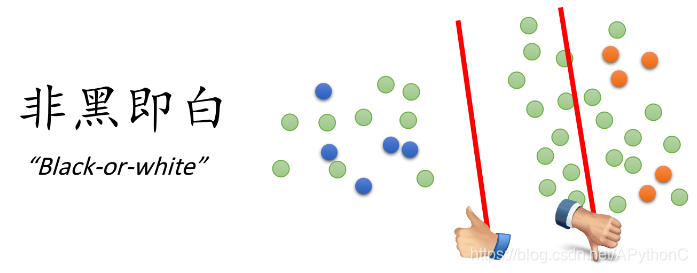
假设这个世界是非黑即白的,在两个class的交界处data的密度(density)是很低的,它们之间会有一道明显的鸿沟,此时unlabeled data(下图绿色的点)就是帮助你在原本正确的基础上挑一条更好的boundary
在这里插入图片描述

Self Training

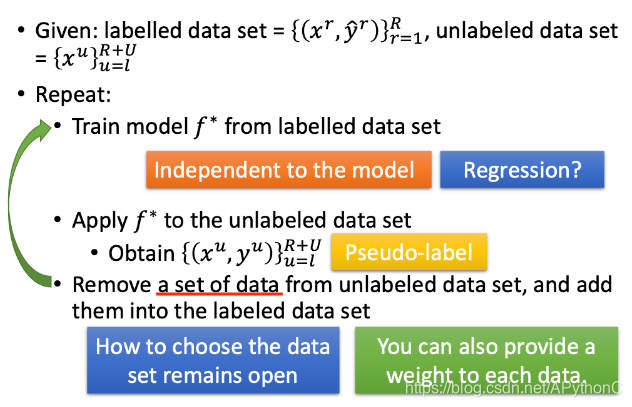
有labeled data和unlabeled data,重复以下过程:

  • 从labeled data中tarin了模型 f ∗ f^* f∗
  • 将 f ∗ f^* f∗应用到unlabeled data,得到带label的数据,称为Pseudo-label
  • 从unlabeled data中移出这部分data,并加入labeled data;要移除哪部分data,要根据具体的限制条件而定
  • 有了更多的label data,就可以继续训练我们的模型,返回第一步
    在这里插入图片描述
    注:该方法对Regression是不适用的

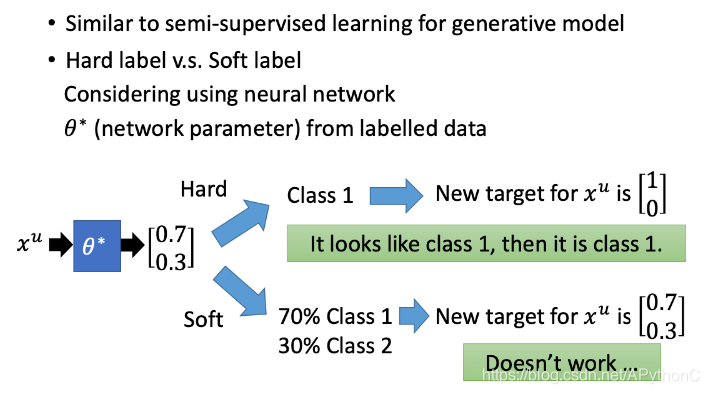
Hard label v.s. Soft label

self-training用的是hard label;generative model用的是soft label
在这里插入图片描述

Entropy-based Regularization

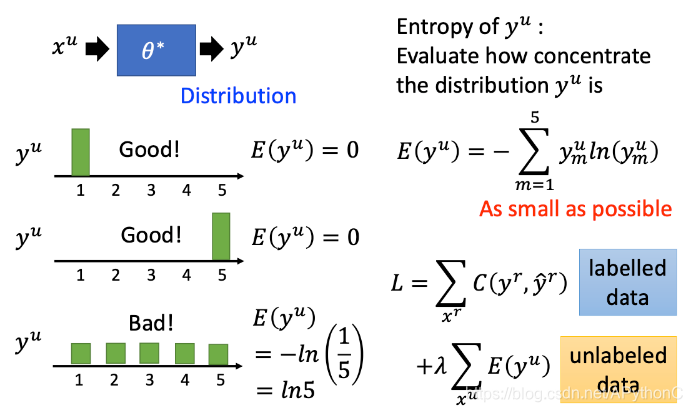
如果输出的每个类别的概率是相近的,那么这个模型就比较bad;输出的类别差距很大,比如某个类别的概率为1,其他都是0
在这里插入图片描述
现在就可以重新设计loss function,用cross entropy来估计差距

Semi-supervised SVM

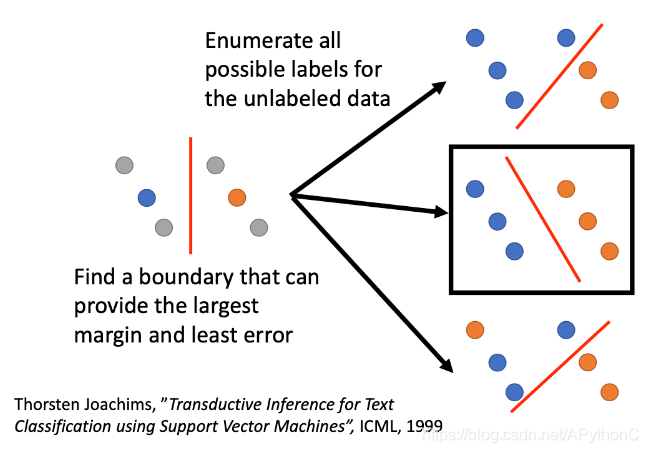
SVM要做的是,给你两个class的data,去找一个boundary:

  • 要有最大的margin,让这两个class分的越开越好
  • 要有最小的分类错误

对unlabeled data穷举所有可能的label,下图中列举了三种可能的情况;然后对每一种可能的结果都去算SVM,再找出可以让margin最大,同时又minimize error的那种情况,下图中是用黑色方框标注的情况
在这里插入图片描述

Smoothness Assumption

Introduction

smoothness assumption的基本精神是:近朱者赤,近墨者黑

假设:如果x是similar的,那么他们的y也是一样的

这样的假设是非常不精确的,下面我们做出一个更加精确的假设:

  • x是分布不均匀的,有的地方很密集,有的地方很稀疏
  • x 1 x^1 x1, x 2 x^2 x2中间有个high density region,那么label y 1 y^1 y1, y 2 y^2 y2就很可能是一样的;但 x 2 x^2 x2, x 3 x^3 x3中间没有high density region,其label相同的概率就非常小
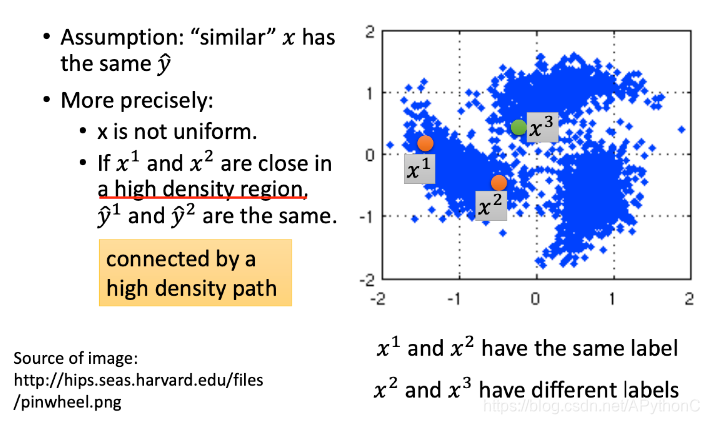
    在这里插入图片描述
    对于下图中的数字,2之间是有过渡形态的,所以这两个图片是similar的;而2与3之间没有过渡形态,因此是不similar的
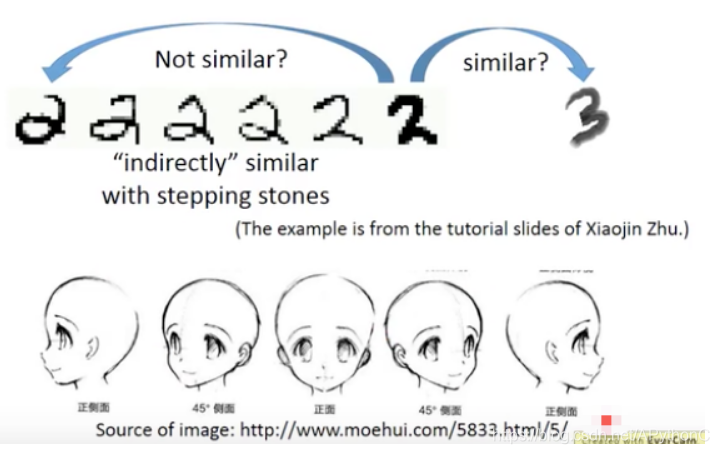
    在这里插入图片描述
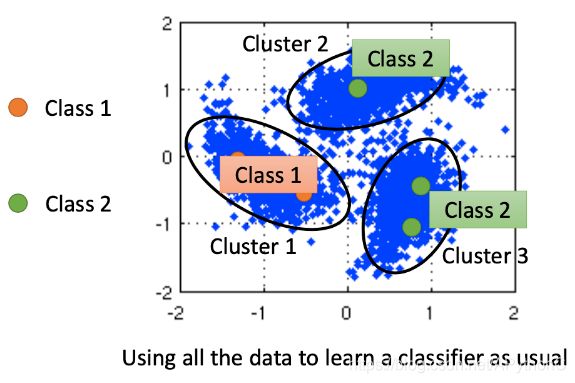
    比较直观的做法是先进行cluster,再进行label
    在这里插入图片描述

Graph-based Approach

我们可以把data point用图来表示,图的表示有时是比较nature,有时需要我们自己找出来point之间的联系
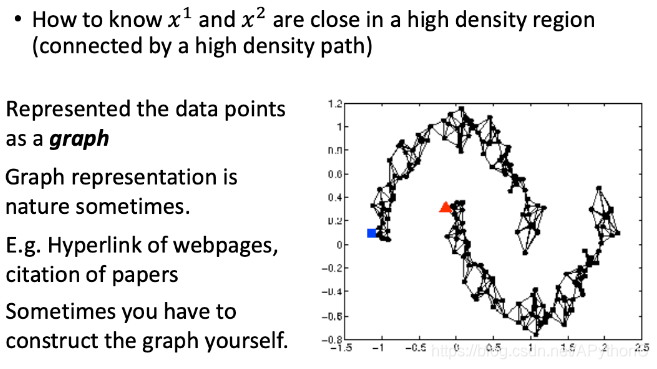
在这里插入图片描述

Graph Construction

通过以下两个算法来添加edge:

  • KNN,对于图中红色的圆点,与其最相近的三个(k=3)neighbor相连接
  • e-Neighborhood,对于周围的neighbor,只有和他相似度大于1的才会被连接起来
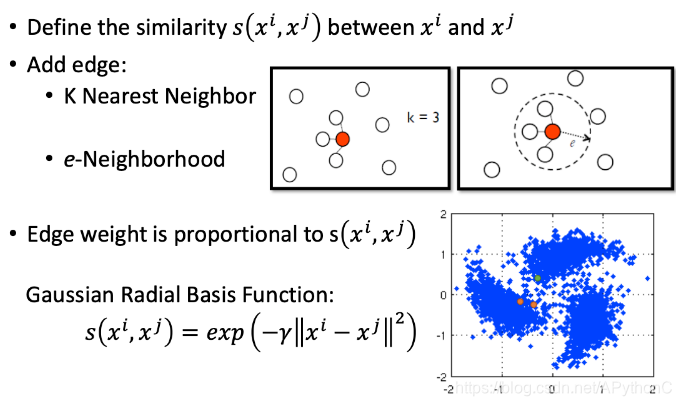
在这里插入图片描述
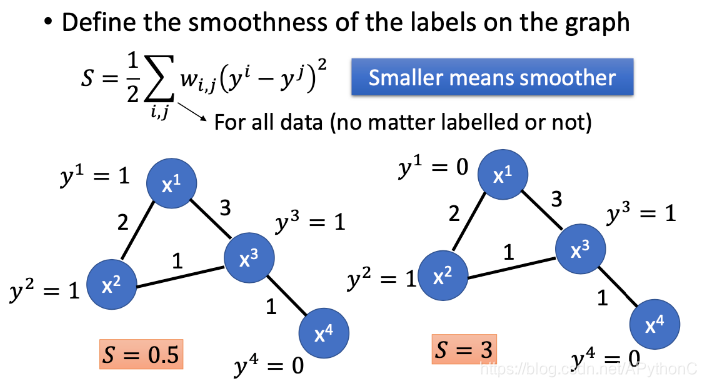
edge并不是只有相连和不相连两种选择而已,也可以给edge一些weight,让这个weight和这两个point之间的相似度成正比

labeled data会影响他的邻居,如果这个point是class1,那么他周围的某些point也可能是class1
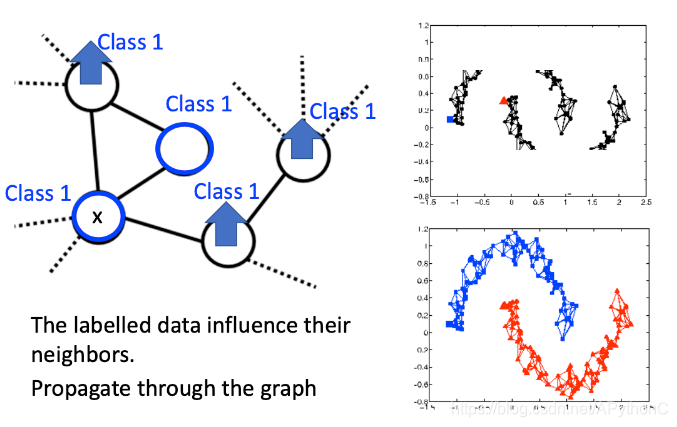
在这里插入图片描述
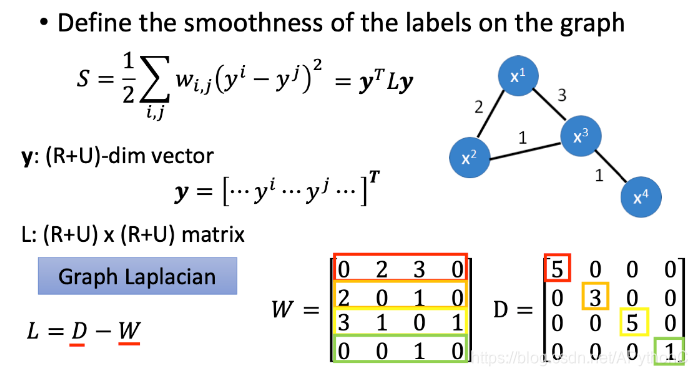
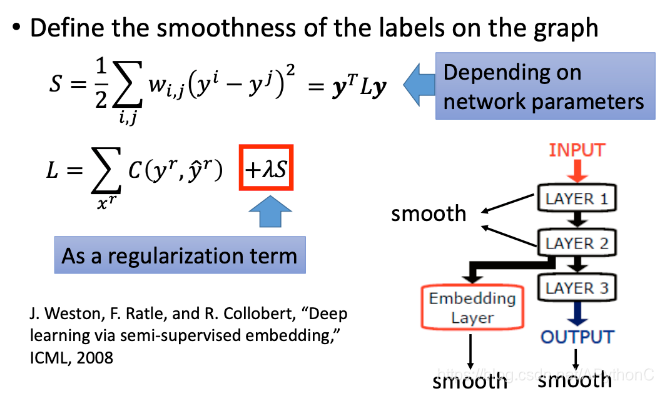
我们期望smooth的值越小越好
在这里插入图片描述
在这里插入图片描述
在这里插入图片描述

Better Representation

Better Representation的精神是化繁为简
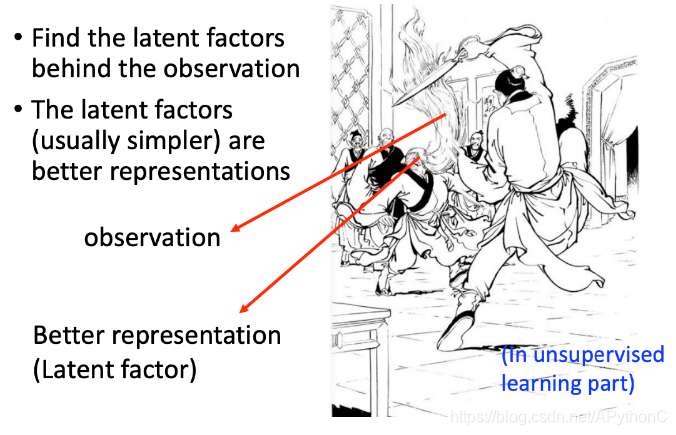
在这里插入图片描述
本文图片来自李宏毅老师课程PPT,文字是对李宏毅老师上课内容的笔记或者原话复述,在此感谢李宏毅老师的教导。

Anomaly-Detection:无监督和半监督异常检测隔离森林内核PCA检测ADOA等 Anomaly-Detection Author: MaXiao E-Mail: 备注: 若文档无法正常显示图片,请参考右方链接: 第一部分:无监督异常检测 (Unsupervised Detection) 1. 算法 1.1 Isolation Forest 算法论文: 算法解析: 算法应用: 1.2 基于PCA的异常检测 方法1:基于样本的重构误差 算法论文: 算法解析: 算法实现 基于KernelPCA重构误差的异常检测: 基于LinearPCA重构误差的异常检测: 只调用Numpy实现LinearPCA异常检测: 不调用scikit-learn,只调用Numpy,通过矩阵的奇异值分解(SVD)实现PCA,再进行异常检测 返回结果与recon_error_pca.py完全一致 方法2:基于样本在Major/Minor主成分上的偏差 算法论文: 算法解析: Chapter 2:基于样本 立即下载

相关推荐

semi-supervised-svm:数据科学作业。 半监督分类算法

半监督的svm 数据科学分配解决方案。 使用支持向量机作为基础分类器的半监督分类器的实现。 该数据集是在代码中随机生成的。 依存关系: 麻木 斯克莱恩 分类问题 给定数据: 大量未标记的数据 少量标注数据 能够正确标记未标记数据集中任何样本的人类专家,其费用与新标记样本的数量成正比 目标: 降低成本 提高分类器的准确性 解决方案 该解决方案将具有最高置信度的预测标签添加到标签数据集中。 置信度最低的标签表明分类器需要人工专家的帮助。 这些真实的标签将添加到数据集中,并且成本会增加。 人类专家的提示数量不能超过标记样本的初始数量-标记数据的数量只能加倍。 如果准确性为100%,成本达到先前说明的限制或没有将任何样本添加到标记的数据集中,则算法终止。 例子 设置: 数据集:10000个样本,3个类,每个类2个类,3个信息性特征。 最大限度。 迭代次数:100 数据集中未标记数据的

机器学习16:半监督学习semi-supervised

一、why semi-supervised dataset中只有部分数据进行了lable标注,即,有的数据成对出现{输入,输出},有的数据只有输入{输入}; Transductive learning(直推试学习):unlabled数据作为测试集; Inductive learning(启发式学习):unlabled数据不是测试集。 半监督学习有用的原因:虽然unlabled数据的分类...

qqqinrui的博客 1543

semi-supervised-learning:深度学习半监督相关算法,主要是Mean teachers are better role models

semi-supervised-learning 深度学习半监督相关算法,主要是文献《Mean teachers are better role models》算法,经测试在一般分类问题上精度都会有几个点的提升。 1.数据存放到data目录,每个类别图片存放到一个文件里面,然后用makelist生成列表文件:path label,把无标签的数据标签设置为:-1 2.运行mean_teacher.py

TensorFlow相关组件的安装

TensorFlow相关组件的安装

AAI666666的博客 3937

【GEE实战指南】Python本地API配置避坑与一站式环境搭建

本文详细介绍了Google Earth Engine(GEE)Python本地API的配置避坑指南与一站式环境搭建流程。通过conda创建隔离环境、账户认证关键步骤、初始化代码的正确写法以及实战测试案例,帮助开发者快速掌握GEE Python API的配置技巧,避免常见错误,提升地理空间数据分析效率。

weixin_42624889的博客 187

mtk-drm commit送显流程(二):内核态atomic_commit实现解析

本文深入解析了mtk-drm框架中atomic_commit机制的内核态实现流程,详细介绍了从用户态触发到硬件提交的完整调用链,包括状态检查、硬件提交等关键阶段。特别分析了MTK平台在动态刷新率、内存带宽优化等方面的特有实现策略,为开发者提供了调试技巧和常见问题解决方案。

weixin_30839881的博客 1308

详解半监督学习(Semi-Supervised Learning)(基础篇)

其中,无监督学习用于使用未标记数据进行聚类或生成模型,以学习数据的分布和结构。常见的方法包括自训练(Self-Training)、伪标签(Pseudo-Labeling)、生成模型(Generative Models)等。然后,将部分数据作为标记数据,其余数据作为未标记数据。通过训练初始分类器,利用其预测结果作为未标记数据的伪标签。最后,将标记和伪标签数据合并,并用于训练半监督学习模型。下面是一个使用半监督学习方法自训练(Self-Training)进行文本分类的示例。

m0_73916791的博客 5268

eda、gnm、anm究竟是个啥?

eda:主成分分析 gnm:高斯网络模型 anm:各向异性网络模型

药研猿的博客 1244

Semi-supervised Learning (3)

semi-supervised learning, Generative models

qq_37587850的博客 461

[Unity_Plastic SCM小技巧] 使用 UnityYAMLMerge 工具合并场景和预制件文件

首先YAMLMerge工具其实并不局限于PlasticSCM,git也可以,它是内置在Editor内的一个更加智能的版本控制工具,只不过正常不会启用,他的目录在C:\Program Files\Unity\Editor\Data\Tools\UnityYAMLMerge.exe(Unity Editor安装目录),MAC上:/Applications/Unity/Unity.app/Content...

unityofficial的博客 1146

TC3xx芯片中断配置避坑指南:从AUTOSAR Davinci配置到SRN地址计算的完整流程

本文详细解析了英飞凌TC3xx芯片的中断配置流程,从AUTOSAR Davinci工具链到硬件调试的全链路指南。重点介绍了中断路由(IR)模块、服务请求节点(SRN)和中断控制单元(ICU)的配置技巧,帮助开发者避开常见陷阱,优化中断性能。

weixin_30628801的博客 414

Semi-supervised Learning(半监督学习)

半监督学习,

长路漫漫亦灿灿 1893

DeepSeek Harness“一切皆插件”核心机制详解

DeepSeek Harness 的“一切皆插件”核心 = Cordis 微内核 + 服务化能力接口 + 声明式依赖注入 + 类型化事件 + 可逆副作用 + 配置层 Profile/Bundle/Patch 组合。它的工程收益是:把模型、工具、循环、存储、UI 等所有 Agent 能力都变成“可从配置替换、可干净装卸”的单元,而不是写死在框架里。

软件行业技术文化交流。 602

李宏毅机器学习课程笔记4:CNN、Why Deep、Semi-supervised

台湾大学李宏毅老师的机器学习课程是一份非常好的ML/DL入门资料,李宏毅老师将课程录像上传到了YouTube,地址:NTUEE ML 2016 。 这篇文章是学习本课程第10-12课所做的笔记和自己的理解。Lecture 10: Convolutional Neural Network Why CNN for ImageCNN的参数比全连接神经网络少得多,为什么CNN只用较少的参数就可以用于处理图

徐子尧的博客 9140

012、乘累加单元(MAC):NPU中最基本的计算单元

本文深入剖析了神经网络处理器(NPU)中的核心计算单元——乘累加单元(MAC)。作者通过实际调试案例揭示了MAC单元设计中的关键问题:定点数格式对齐、累加器位宽陷阱、流水线优化和多MAC同步方案。重点讨论了INT8量化中的边界条件处理、偏置项截断风险以及零值检测等实战经验,并提供了三点实用建议:建立精确的C模型、参考RISC-V P扩展指令集、仔细审查芯片规格书。文章强调硬件加速的实际瓶颈往往在于数据搬运而非计算单元本身,为NPU开发者提供了宝贵的工程实践参考。

m0_50546716的博客 299

图像分割 - 使用Mask R-CNN模型在COCO数据集上进行图像分割任务

图像分割是计算机视觉领域的一个重要任务,它旨在将图像中的每个像素分类为对象或背景。Mask R-CNN是一种基于区域的卷积神经网络,可用于图像分割任务。它是Faster R-CNN的扩展,将目标检测与图像分割结合起来,能够同时检测和分割对象。在本博客中,我们将使用Mask R-CNN模型在COCO数据集上进行图像分割任务。我们将介绍如何下载和准备COCO数据集,以及如何使用Mask R-CNN模型进行训练和推理。

斌擎科技 1190

李宏毅ML lecture-12 Semi-supervised Learning

李宏毅ML lecture-12 Semi-supervised Learning生成式模型EM算法参考判别式模型Low-density Separationself-trainingEntropy-based RegularizationSVM参考Smoothness AssumptionCluster and then LabelGraph-based ApproachBetter Repre...

Arron_hou的博客 838

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

李宏毅机器学习笔记6:Why deep、Semi-supervised

李宏毅老师的机器学习课程和吴恩达老师的机器学习课程都是都是ML和DL非常好的入门资料,在YouTube、网易云课堂、B站都能观看到相应的课程视频,接下来这一系列的博客我都将记录老师上课的笔记以及自己对这些知识内容的理解与补充。(本笔记配合李宏毅老师的视频一起使用效果更佳!) Lecture 8:Why deep? 1.Shallow network VS Deep network 在比较...

weixin_33724659的博客 267

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

李宏毅老师机器学习入门

入门Learning Map你想要找什么样的函数怎样告诉机器你要找什么样的函数机器怎样找出你想要的函数课程作业安排 机器学习就是自动找函数(方法)。 典型应用如:语音识别、图像识别、下围棋、对话系统等等。 Learning Map 下图中,同样的颜色指的是同一个类型的事情 蓝色方块指的是Scenario,即学习的情境。通常学习的情境是我们没有办法控制的,比如做Reinforcement Learning是因为我们没有Data、没有办法来做Supervised Learning的情况下才去做的。如果有Data

APythonC的博客 472

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Lesson 11 Self-supervised Learning for NLP: Bert+GPT

听课(李宏毅老师的)笔记,方便梳理框架,以作复习之用。本节课主要以Bert和GPT为例,讲授了self-supervised learning for NLP相关内容。

qq_52641289的博客 1026

李宏毅老师-自监督学习(Self-supervised Learning)Part2

慢慢来,会更好! 大家好,我是一个想研究又不会研究的研究生 陪伴大家一起学习成长! 我们先来学习Bert这个model 什么是Self-supervised Learning呢? supervised:比如说现在输入一篇文章,判断它是正面还是负面文章 我们就需要文章和label(它是正面还是负面)才能够进行train self-supervised:在没有label的情况下,自己想办法做supervised 假设现在只有一堆文章,没有标注 想办法让一部分文章作为model的输入,另一部分作为label

weixin_46675905的博客 467

【学习】自监督学习2、GPT、PLM

李宏毅机器学习

Raphael9900的博客 2434

(待完善)半监督学习(Semi-supervised learning)综述

半监督学习(Semi-supervised learning)综述 1. 关于半监督学习 半监督学习是机器学习的分支,主要利用有标签样本以及无标签样本用于用于特定学习的任务。如下图,半监督学习有利于获得更准确的分类边界。 在这里插入图片描述 1.2 半监督学习的假设 (1)平滑假设 如何输入的两个点在输入空间是接近的,那个它们的标签是一致的。 (2)低密度假设 (3)流型假设 2. 半监督学习的方法 2.1 Inductive 方法 Inductive方法构造一个分类器,并用于对每个样本进行预测。无标签样

rosefun96的博客 6509

李宏毅老师《机器学习》课程笔记--合辑目录

合辑索引目录

宁萌Julie的博客 1567
上一篇: 李宏毅老师课程:Unsupervised Learning - Word Embedding
下一篇: 李宏毅老师课程:Explainable ML
APythonC
博客等级 码龄7年 23粉丝 58原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值