又快又准的RAG Meta-Chunking,1.3倍提升,耗时减半

Hermes+BGE-M3本地RAG实战:qmd、hybrid检索与内存映射深度解析 RAG(检索增强生成)作为大模型落地的关键技术,其核心挑战已从模型选型转向知识库的轻量化部署与低资源适配。本文聚焦本地化RAG工程实践,围绕嵌入模型(embedding)、混合检索(hybrid retrieval)、量化分发(qmd)等基础概念展开,深入解析BGE-M3三模态向量表示原理及其对传统cosine相似度计算的重构价值;强调Hermes单体架构如何通过mmap内存映射、roaring bitmap索引与GGUF量化模型协同,在16GB内存笔记本上实现端到端1.2秒低延迟响应;覆盖PDF解析、ch 阅读详情

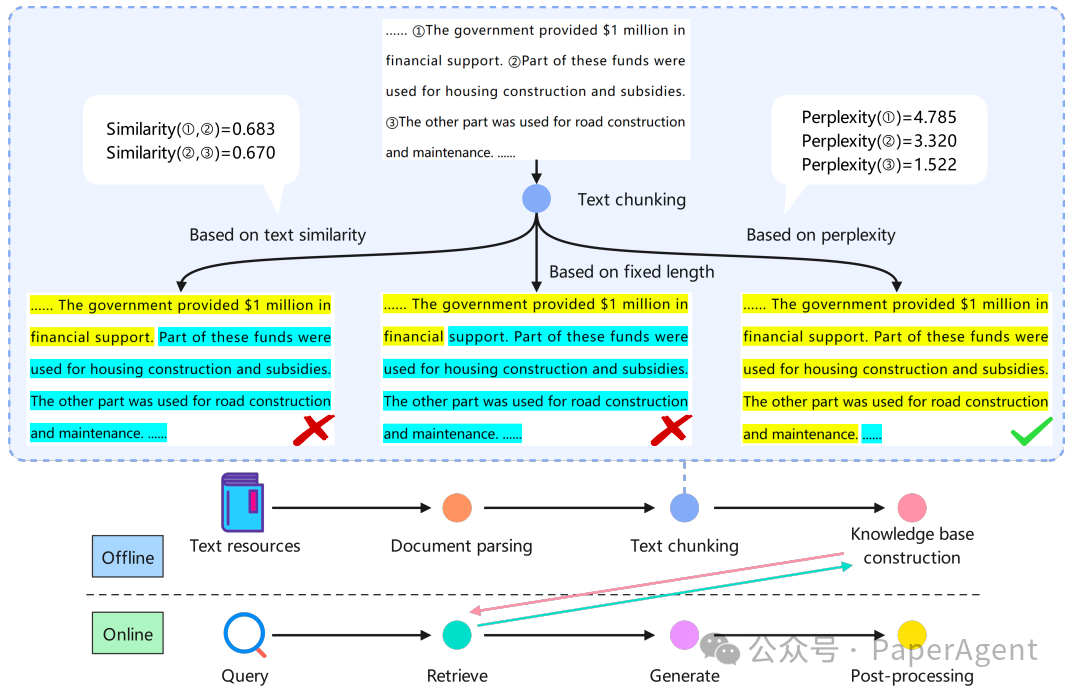
RAG效果在很大程度上依赖于检索到的文档的相关性和准确性。传统的基于规则或语义相似性的文本分块方法在捕捉句子间微妙的逻辑关系上存在不足。

RAG流水线的概览,以及基于规则、相似性和PPL分割的示例。相同的背景色表示位于同一个块中。
图片

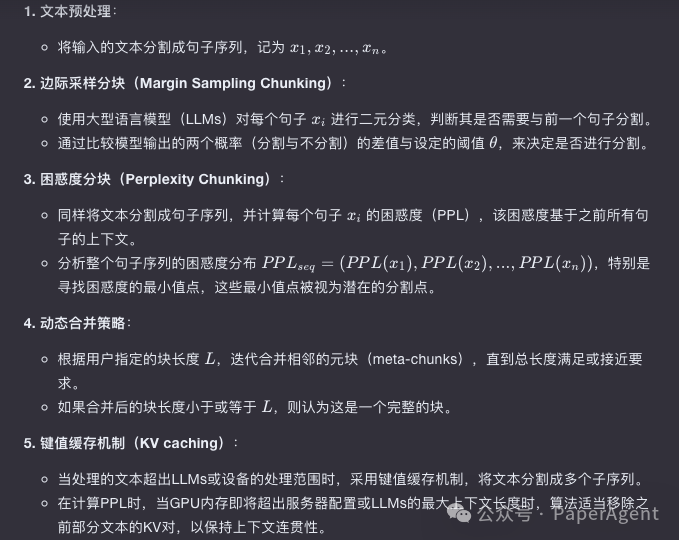
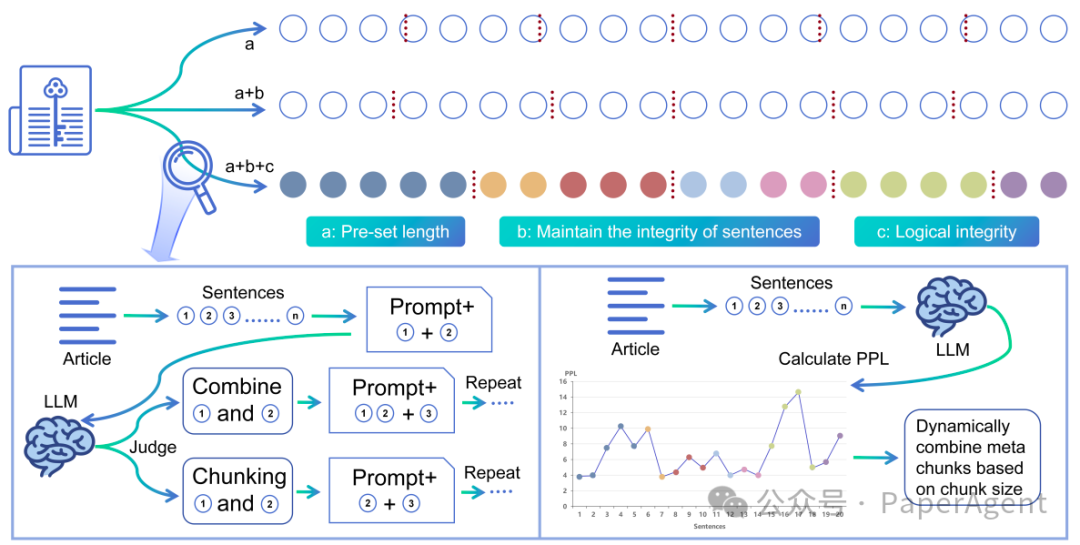
 为了解决现有方法的局限性,提出了一种名为Meta-Chunking的概念,它在句子和段落之间定义了一种粒度:由段落内具有深层语言逻辑联系的句子集合组成,旨在增强文本分割过程中的逻辑连贯性。Meta-Chunking包括基于LLMs的两种策略:边际采样分块(Margin Sampling Chunking)和困惑度分块(Perplexity Chunking)。

整个元块分割(Meta-Chunking)过程的概览。每个圆圈代表一个完整的句子,句子的长度并不一致。垂直线表示在哪里进行分割。图底部的两侧揭示了边缘采样分割(Margin Sampling Chunking)和困惑度分割(Perplexity Chunking)。具有相同背景色的圆圈代表一个元块,它们被动态组合以使最终的块长度满足用户需求。
图片

Meta-Chunking的工作流程:

图片

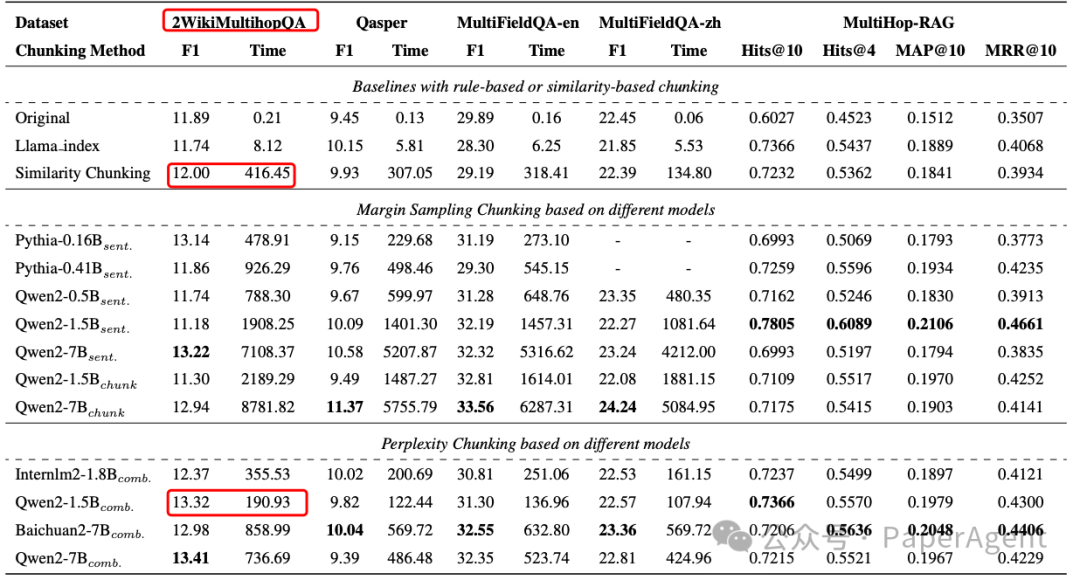
通过在11个数据集上的实验,证明了Meta-Chunking能够更有效地提升基于RAG的单跳和多跳问答任务的性能。例如,在2WikiMultihopQA数据集上,它比相似性分块(Similarity Chunking)的性能提高了1.32倍,同时只消耗了45.8%的时间。

在五个问答(QA)数据集中展示了主要的实验结果。前四个数据集来源于LongBench。sent. 表示是否适合将两个句子分开,而chunk表示后一个句子是否适合与前面的块合并。comb. 指的是首先使用PPL分割(PPL Chunking)且阈值为0来分割文本,然后进行动态组合的过程。
图片

此外,还探讨了不同模型大小对文本分块任务的影响,发现中型模型(如1.5B参数级别)在性能和效率之间展现了更平衡的表现。
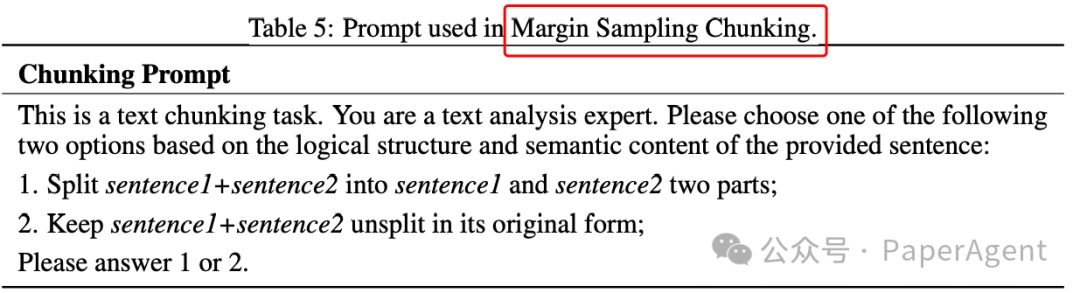
图片

RAG不是简单检索+生成:面向专业场景的可信决策流设计 RAG(检索增强生成)常被误解为大模型叠加搜索引擎的技术组合,实则是一种面向高可靠性需求的专业知识服务范式。其核心原理在于构建端到端的可信信息决策流,需同步解决语义对齐、证据可溯与时效可控三大挑战。技术价值体现在强可解释性、快速知识迭代与合规审计能力,广泛应用于医疗问答、法律辅助、金融合规等对准确性、溯源性与权威性要求严苛的领域。本文聚焦RAG落地中Embedding语义锚定、混合检索重排序、证据角色化提示约束等关键实践,揭示‘为什么微调不是银弹’‘为何召回率是最大误导指标’等真实工程认知。 阅读详情

相关推荐

RAG中的chunk以及评测方法

分块(chunking)是将大块文本分解成小段的过程。chunk的主要原因是尽量减少我们Embedding内容的噪音,所以为知识库中的文档找到最为合适的chunk大小,非常影响后续查找的准确性和相关性。

Criss@陈磊 501

Meta-Chunking:一种用于提高RAG性能的文本分割技术

尽管RAG技术在 LLMs 中具有潜力,但在文本分块方面常常被忽视。文本分块的质量直接影响知识密集型任务的表现。本文提出概念,这是一种介于句子和段落之间的文本分割技术,旨在通过逻辑感知来提高文本分割的效率;。此外,还提出了结合Meta-Chunking与动态合并的策略,在不牺牲逻辑连贯性的前提下,实现细粒度与粗粒度文本分块之间的平衡。

Python_cocola的博客 1085

DP3(3D Diffusion Policy)算法详解:从点云感知到扩散动作生成

DP3 的全称是:DP3 = 3D Diffusion Policy\boxed{\text{DP3 = 3D Diffusion Policy}}DP3 = 3D Diffusion Policy​对应论文题目是:3D Diffusion Policy: Generalizable Visuomotor Policy Learning via Simple 3D Representations该工作发表于 Robotics: Science and Systems(RSS)2024。DP3 是一种面向机器

u013250861的博客 353

小白学大模型 RAG:9种不同的Chunk划分方法

最近已有不少大厂已停止秋招宣讲了。节前,我们邀请了一些互联网大厂朋友、今年参加社招和校招面试的同学。针对新手如何入门算法岗、该如何准备面试攻略、面试常考点、大模型技术趋势、算法项目落地经验分享等热门话题进行了深入的讨论。在RAG(Retrieval Augmented Generation)技术中,划分chunk是将长文档或数据集切割成较小的、独立的部分,以便于处理、存储和检索。

2301_78285120的博客 4827

金桔智慧物流之容器(托盘、周转箱等)定位及周转方案原理

金桔智慧物流之容器(托盘、周转箱等)定位及周转方案原理 在物流行业种,托盘是标准化运输的关键的配件,而容器存在丢失、盘点、闲置等管理问题。如何通过信息化的手段提升容器的寿命,提高调配效率,降低闲置是物流容器行业的关键点。 金桔蓝牙网关配合金桔蓝牙资产管理终端可以解决物流行业痛点问题。 容器管理面临的问题: 技术方案 场景描述之库房 场景描述之车辆 场景描述之终端 方案优势 ...

jinjufocus的博客 1180

基于云盾构建等保三级Web安全体系:从合规要求到实战落地

网络安全等级保护(等保)是保障信息系统安全的重要制度,其核心原理是通过分级防护、动态调整的策略,构建纵深防御体系。在技术层面,等保要求覆盖物理环境、通信网络、区域边界、计算环境和安全管理中心等多个层面,旨在通过技术和管理相结合的方式,有效应对网络攻击和数据泄露风险。对于Web应用而言,满足等保三级要求具有极高的技术价值,它不仅是合规的刚性需求,更是提升业务系统整体安全水位、建立用户信任、保障业务连续性的关键工程实践。在云计算时代,利用云原生安全服务(如Web应用防火墙WAF、云安全中心、态势感知等)可以高效

weixin_29324877的博客 308

人大:基于LLM的文本分块优化RAG效果

在检索增强生成(RAG)系统中,传统文本分块方法在捕捉句子间逻辑关系细微变化方面的不足,如何实现细粒度和粗粒度文本分块之间的有效平衡?论文提出了一种名为Meta-Chunking的创新文本分块技术,通过动态组合策略实现了更高效的文本分块,显著提升了检索质量和效率。

大模型任我行的博客 1913

Claude Code+Cursor+Claude 4三剑合璧!5步搞定Magentic-UI的OAuth2.0集成,开发效率飙升500%,新手秒变全栈工程师

本文详细介绍了如何利用Claude Code、Cursor和Claude 4三款AI工具高效集成Magentic-UI的OAuth2.0认证系统。通过5个步骤的实战演练,开发者可快速完成从环境搭建、项目分析、代码生成到前端集成的全过程,显著提升开发效率。文章还提供了JWT令牌管理、安全配置及常见问题解决方案。

weixin_29234509的博客 453

Meta-Chunking:项目的核心功能/场景

Meta-Chunking:项目的核心功能/场景 Meta-Chunking:利用LLM实现高效的文本分段,通过逻辑感知保持内容逻辑完整性。 项目介绍 Meta-Chunking 是一个基于大型语言模型(LLM)的文本分段项目,旨在实现逻辑上连贯、独立的文本块划分。这种方法的核心原则是允许块大小的变化,更有效地捕获和保持内容的逻辑完整性。通过动态调整粒度,确保每个分割的块都包含一个完整且独立的思想...

gitblog_00175的博客 748

Android 13.0 framework层系统手势增加上滑手势home事件功能(相当于Home键)

在13.0的定制化开发系统手势功能的时候,客户需求要求在上滑手势的时候,在底部上滑时候进入系统桌面,也就是增加 home键功能,所以就需要分析相关的系统手势上滑事件,然后添加home事件这样 就可以实现这个功能了

安卓兼职framework和app工程师的博客 1133

D16: OpenClaw + Notion API:知识管理新玩法

本文介绍了如何利用OpenClaw连接Notion API构建自动化知识管理系统。文章首先分析了传统知识管理的痛点,包括信息分散、更新不及时等问题,并对比了Notion与其他工具在API完整性、结构化程度等方面的优势。接着详细说明了Notion API的获取和授权流程,并设计了包含项目知识库、技术决策库和会议纪要库的三层架构系统。最后通过会议纪要自动归档的实战案例,展示了如何通过YAML配置实现从飞书会议到Notion的自动化知识沉淀流程。该方案能有效解决团队知识管理中的信息碎片化问题,提升协作效率。

刘一说的IT专栏 274

LLMs之RAG:《Meta-Chunking: Learning Text Segmentation and Semantic Completion via Logical Perception》翻

​ LLMs之RAG:《Meta-Chunking: Learning Text Segmentation and Semantic Completion via Logical Perception》翻译与解读 目录 《Meta-Chunking: Learning Text Segmentation and Semantic Completion via Logical Perception》翻译与

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 1093

《SAP FICO系统配置从入门到精通共40篇》030、集成配置:FI与生产计划(PP)的自动科目确定

FI和PP的自动科目确定,本质上是把生产业务翻译成会计语言。翻译规则就藏在那些配置表里。配的时候多想一步:这个业务动作,在财务眼里是什么?是材料消耗?是产出入库?还是工费分摊?想清楚这个,再看配置界面,那些代码就不是天书了。最好的测试方式,是月底关账前,让生产部门跑一遍所有类型的生产订单。配置对不对,业务最知道。

985大学毕业,前某大厂员工,啥都会点的程序员! 574

GPT-4参数量与激活率真相:1.8万亿不是权重总数,2%不是固定开关

大语言模型中的‘参数量’常被误解为静态权重规模,实则在稀疏混合专家(MoE)架构下,它本质是可寻址的理论参数空间上限;而‘每token激活比例’反映的是动态路由机制下的统计均值,受输入语义、上下文长度和路由器策略共同影响。这一原理揭示了计算开销与存储开销的根本分离——参数总量决定显存占用下限,激活率决定实际FLOPs与推理延迟。技术价值在于支撑高效推理调度、量化部署与成本可控的API服务;典型应用场景包括长对话系统、金融合同分析及多模态交互引擎。本文聚焦GPT-4架构中1.8万亿参数与2%激活率这两个高频热

weixin_30565199的博客 940

2025美赛E题为农业留出空间(附代码+全保姆教程)Making Room for Agriculture

有机农业的核心在于减少化学投入,促进自然控制和可持续性。变量定义CCC: 作物种群III: 害虫种群PPP: 天然捕食者种群(蝙蝠、鸟类等)BBB: 生物多样性水平(以种类数量表示)SSS: 土壤健康指数(影响植物繁殖与作物生长)EEE: 农业生态系统的整体稳定性。

博客 1495

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

万字长文梳理2024年的RAG

在已经过去的 2024 年,RAG 的发展可以称得上是风起云涌,我们回顾全年,从多个角度对全年的发展进行总结。

datageek的博客 1763

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

[RAG]Meta-Chunking: 通过逻辑感知学习高效的文本分段

本文是由人大提出的,旨在解决在中,文本分段这一关键方面被忽视的问题。具体来说,传统文本分段方法(如基于规则或语义相似性)在捕捉句子间深层语言逻辑联系方面存在不足,导致在知识密集型任务(如开放域问答)中的性能受到影响。:传统文本分段方法往往基于规则或语义相似性,难以捕捉句子间的深层逻辑联系(如因果、过渡、并行和渐进关系)。:Meta-Chunking通过利用LLMs的强大理解和推理能力,设计了边际采样分段和困惑度分段策略,精确识别文本分段边界,确保分段后的文本块具有逻辑连贯性。

lyy2017175913的博客 987

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

RAG文档分块(Chunk)的策略和检索召回优化阶段重排序方法

RAG可以总结成如下步骤,本次我们探讨文档分块(Chunk)的策略,以及检索召回优化阶段重排序方法。:这是最常见的分块方法,通过设定块的大小和是否有重叠来决定分块。这种方法简单直接,不需要使用任何NLP库,因此计算成本低且易于使用。:常见的HTML、MARKDOWN格式,或者其他可以有明确结构格式的文档。这种可以借助“结构感知”对文档分块,充分利用文档文本意外的信息。:这种策略旨在确保每个分块包含尽可能多的语义独立信息。

m0_56299345的博客 3712

记录些RAG中Chunk切分方法

记录些RAG中Chunk切分方法

安静的软件工程师 1588

RAG分块策略:主流方法(递归、jina-seg)+前沿推荐(Meta-chunking、Late chunking)

LangChain 还预定义了其他编程语言(如 Go、C++、Java)等的分割符列表,方便用户快速定义新的文本切块类。如果需要处理未提供的文本格式,可以参照已有的类实现。

2401_85373691的博客 1786

Rag中chunk大小影响

在rag流程中,首先需要上传一些文档,对文档进行解析,解析后的文档一般需要切片,切分为长度大小相当的chunk。为什么需要切片呢,因为文档的大小各异,不做切片的话,文档之前的长度相差太大,对检索召回来说,不是一个很好的事情。Rag中的检索一般包括稀疏检索,还有稠密检索,稀疏检索一般指通过关键词检索,稠密检索一般指通过向量检索召回。这两种对chunk大小的要求不完全一样,本文主要针对向量检索。以上是基于向量召回的chunk size讨论,建议大家选择256~512测试。

sinat_28694519的博客 2186

RAG 为什么需要文本分割(Chunking)

Picone上的一个博客,翻译过来学习一下,其中加入了一些个人的理解和调整,有兴趣更深入研究的可以看一下文章的原文。

2401_84204413的博客 1521

RAG总结及前沿之Meta-Chunking切分思路

现有的RAG系统主要基于文本,无法有效利用视觉信息如布局和图像,这些信息在现实世界中的多模态文档中起着至关重要的作用,因此一种思路是采用基于视觉的RAG方法(VisRAG),通过使用视觉语言模型(VLM)直接处理文档图像,从而保留原始文档中的所有信息。:如果某个句子 (x_i) 的困惑度 (PPLM(x_i)) 小于其前一个和后一个句子的困惑度(即 (PPLM(x_{i-1})) 和 (PPLM(x_{i+1}))),并且差异超过设定的阈值 (\theta),则将 (x_i) 作为分块的边界;

yifangyun_360的博客 229
上一篇: 训练VLM(视觉语言模型)的经验
下一篇: 获奖后,Hinton致谢自己的研究生:“活都是他们干的”
AIBigModel
博客等级 码龄2年 5359粉丝 706原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值